在欧盟《人工智能法案》的透明度指南生效之后,以及在各主要 AI 实验室宣布将很快对其文本输出加水印以合规之后,关于这是否会对 AI 模型生成文本的质量产生影响、以及影响有多大,出现了一些争论。
自从 AI 实验室的重心转向代码生成以来,我觉得模型写出来的文字质量差了很多。1但试着去理解水印是否会让它变得更糟,仍然很有意思。
我觉得围绕科技作家 John Gruber 最近那篇文章的讨论很有意思,Anthropic 在 Claude 中对文本施加的“水印”掺假是对写作的亵渎,非常有意思。
关于水印,Gruber 写道:
一个工具为了在文本中嵌入隐藏线索以暗示其来源,而牺牲哪怕一丝的清晰度、连贯性、意义、质量等等,都是不可接受的。
他遭到了很多反驳,许多人争论说质量到底该如何衡量、甚至如何定义。
但也有人认为水印根本不影响质量:本质上只是用不同的随机数来生成文本。Daniel Jalkut——Gruber 在后续文章中链接到了他——发表了一篇题为AI 无法掺假自己的写作的文章,其中写道:
……也有一些调整算法的方式不会削弱其随机性。例如,如果一个随机数生成器习惯性地把生成数字的各位数字顺序颠倒,随机性仍然保持不变。
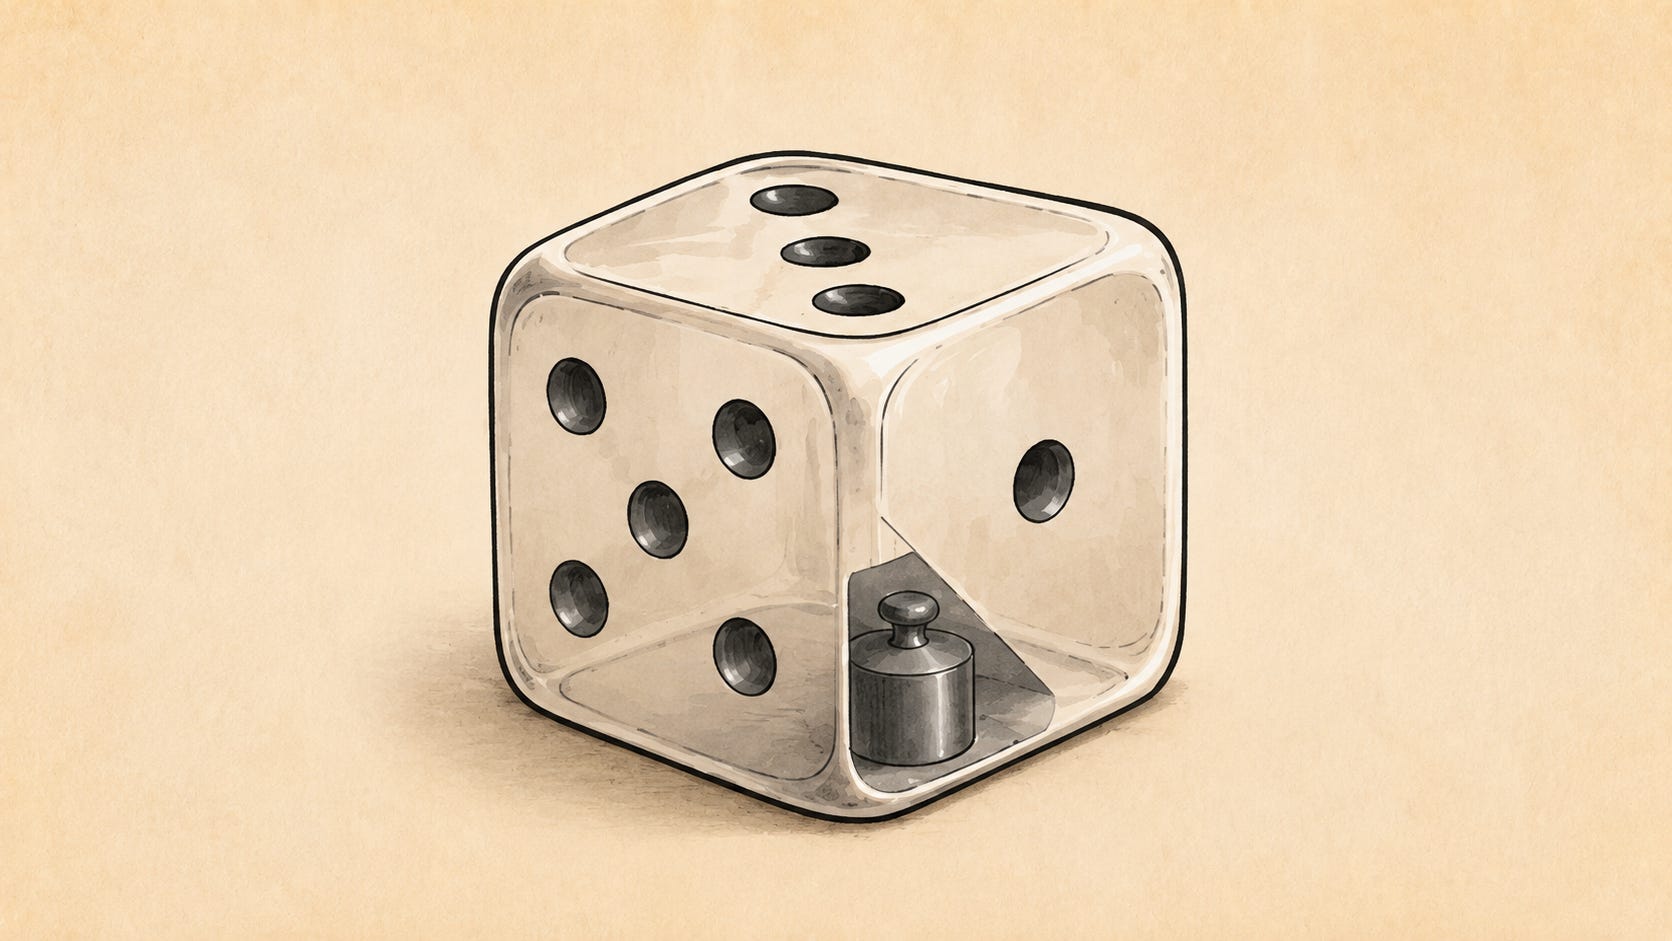
类似地,在另一场讨论中,有人把它描述为本质上就是交换骰子的两个面。
在一篇后续文章中,Gruber 写道:
我希望那是真的。我相信它可能是真的。我认为它是真的可能性极低。
我认为 Gruber 说得对。
Anthropic 提出了一个大胆的说法:“水印不会影响 Claude 输出的质量。”他们链接并作为其设计基础的论文(Google 的 SynthID-Text,2024 年发表于Nature)向所有人保证,该方法“保持了响应质量”。
所以很容易让人以为这不过是小题大做,他们真的只是在调换一些随机数而已。
但他们用人类测试过的“无质量影响”这一说法,是基于单次回答得出的。而不是数百万人实际使用这些系统的方式:随着时间推移、跨多个提示和回答的来回对话。
这份 56 页的补充 PDF他们在底部链接到的文件提供了更多关于所用方法的信息,并且它表明“无质量影响”这一说法并未道出全部实情。值得注意的是,它提到存在一种“多样性/可检测性权衡”:
虽然单序列无失真保证了每个单独回答的质量,但它不一定能在多个回答之间保持多样性
好,那这意味着什么?他们接着解释道:
当对同一提示采样多个回答时,带水印回答之间的相似度要高于不带水印回答之间的相似度。
现在,如果他们真的只是把一组随机数换成了另一组,我们就不会看到与不带水印回答相比有任何这样的差异。
他们接着写道:
在回答间多样性很重要的场景中,这可能会有问题,或者可能降低一个会生成许多回答然后选出最佳回答的系统的整体质量
好,所以用他们自己的话说,它终究可能“降低整体质量”。但没什么可担心的,因为这只会在你关心“回答间多样性”时才与你有关,而他们为此只举了一个例子:一个生成并选择回答的系统。
但“回答间多样性”也影响着大多数人使用这些系统的方式。尤其是在你需要创造力的写作任务中。
针对 Gruber 关于牺牲质量的观点,一些人辩称,模型并不知道对于每个人在其具体工作中想要表达的内容而言,最佳的下一个词是什么,所以我们不应过于纠结下一个词的选择。但那样的话,他们肯定也会同意,你,作为个体,会在看到它之后就知道它是否合适。
假设你输入提示词:“我不喜欢这句话的结尾。请建议一个新的结尾:[句子]。”模型给出了一个替代方案,但你不喜欢。没问题,点击重试按钮。好了,现在你就受到水印的影响了,因为你已经撞上了“响应间多样性”问题:就像掷一颗灌了铅的骰子,你会比在无水印模型上更频繁地看到相似的响应。
Natzir Turrado,一位技术顾问,实际测试了这一点(西班牙语文章),他在一个开放模型上使用论文中的设置和一个水印密钥复现了 SynthID-Text。他让带水印的模型五次描述一次难忘的海滨小镇之旅。他得到的五个回答中有四个以几乎相同的方式开头:“每当回想起那次去往古雅海滨小镇的旅行,我的心依然在歌唱/起舞……”。而对于无水印的模型,三个回答的开头各不相同。2
尽管他们似乎没有针对这一点进行测试,但让同一提示词的回答看起来相似的原因,也可能在不同提示词之间发生。水印在选择下一个 token 时只查看一个很小的滑动上下文窗口,因此任何时候两段文字经过相同的短 token 序列,它们就可能重建出相同的上下文窗口,从而导致输出更可预测、多样性更低。而写作中充满了相同的短语,可能触发这种行为。
这里还有另一个受影响的例子:人们试图判断一个回答的置信水平、以降低幻觉概率的一种方法是,将同一提示词重复多次,探索模型所走的不同路径。然后他们查看结果,看看共识在哪里。嗯,这也会受到影响。有了水印,你就更难信任你所看到的正在形成的共识,因为答案现在不那么独立了:它们受到水印密钥的引导。
有趣的是,虽然 SynthID 的论文指出了各条回复中的质量损失,但我在论文里找不到任何地方用人类测试过这种水印方法的这一特定方面。如果他们没做,那么他们所引用的那些出色的人类测试结果,并没有测试水印方法中受影响最大的部分。3
所以在我看来,他们正在通过水印限制其模型的创作范围,从而牺牲质量,而且他们认为你不会注意到,也不会太在意。4
Jasmine Sun 在审视为什么 AI 模型写不好时发现的一个模式。以下是诗人兼计算机科学家 Katy Gero 的看法:
让 GPT-2 的声音显得新鲜的,正是同一种异想天开,也让它容易产生其他不可预测的行为。“如果你是像 Google 或 OpenAI 这样的大公司,你想要的聊天机器人是能赚钱的。那个不会给你赚钱的聊天机器人,就是那个怪咖,”Gero 说。
Natzir Turrado 给我指出了一个他收到的回复,来自 X 上 SynthID 论文作者之一 Sumanth Dathathri:
多样性问题有很多简单的修复方法。我觉得如果你用同样的提示词去试 Gemini/Claude很多次,你会得到非常多样的回复 :)
这有点含糊,但我怀疑他所说的“简单修复”是把问题转嫁给用户。在我看来,他像是在承认他们把之前的骰子换成了一个灌了铅的骰子,但解决办法只是把它“很多次”地掷出去(我加的强调),最终它会落到每一面上。如果他是这个意思,那为什么不承认这样的改变确实让系统对用户来说比之前更糟了呢?
Turrado回应:“好奇:哪些简单修复不会牺牲检测强度?”
Dathathri 目前没有回复。
暂无帖子