LLM 太爱废话了。问一个简单的问题,你会得到几百字的"视情况而定"。烦得要命。
这就是为什么我们喜欢像 Jev 这样的决策模型来处理更简单的任务。你提出一个结构化的问题,就会得到一个带概率的类型化答案,看起来像这样:
Noul。刺猬是哺乳动物吗?→ 是,0.99
选择。刺猬属于哪个动物科?→ 哺乳动物,0.99
分数。刺猬目前的保护状况是什么?→ 无危,0.77
LLM 返回的是自由形式且过度自信的长篇大论,而决策模型则让模型的不确定性变得明确。在一个经过校准的模型中,得分为 0.8 的答案大约有 80% 的时候是正确的。这意味着 0.5 的分数就是抛硬币。
我们一直在 PostHog 试验它们,有几个用例已经进入生产环境。这是到目前为止我们关于使用决策模型学到的一切:何时使用它们、如何使用它们,以及要避免的错误。
决策模型比前沿模型便宜多达 444.6 倍、快 193.6 倍,1所以你可以用它们来检查你是否真的需要进行一次昂贵的 LLM 调用。
我们在一个流水线中这样做,用于清除Replay Vision中的个人信息,这是我们的产品,它会为你观看并总结用户会话录像。以下是它的工作方式:
每个会话摘要都要经过决策模型的 2 个是/否问题。使用这样狭窄的问题可以将误报减少到单个问题所产生的约十分之一。
1. "这是否提到了一个真实的人?"
2. "这是否显示了联系方式或身份证件?"
如果任一得分达到 0.4 或以上,Gemini 就会重写摘要,去除个人信息,然后再次检查。
否则,它就是干净的,可以通过关卡。在生产环境中,98.7% 完全跳过了 LLM 调用。
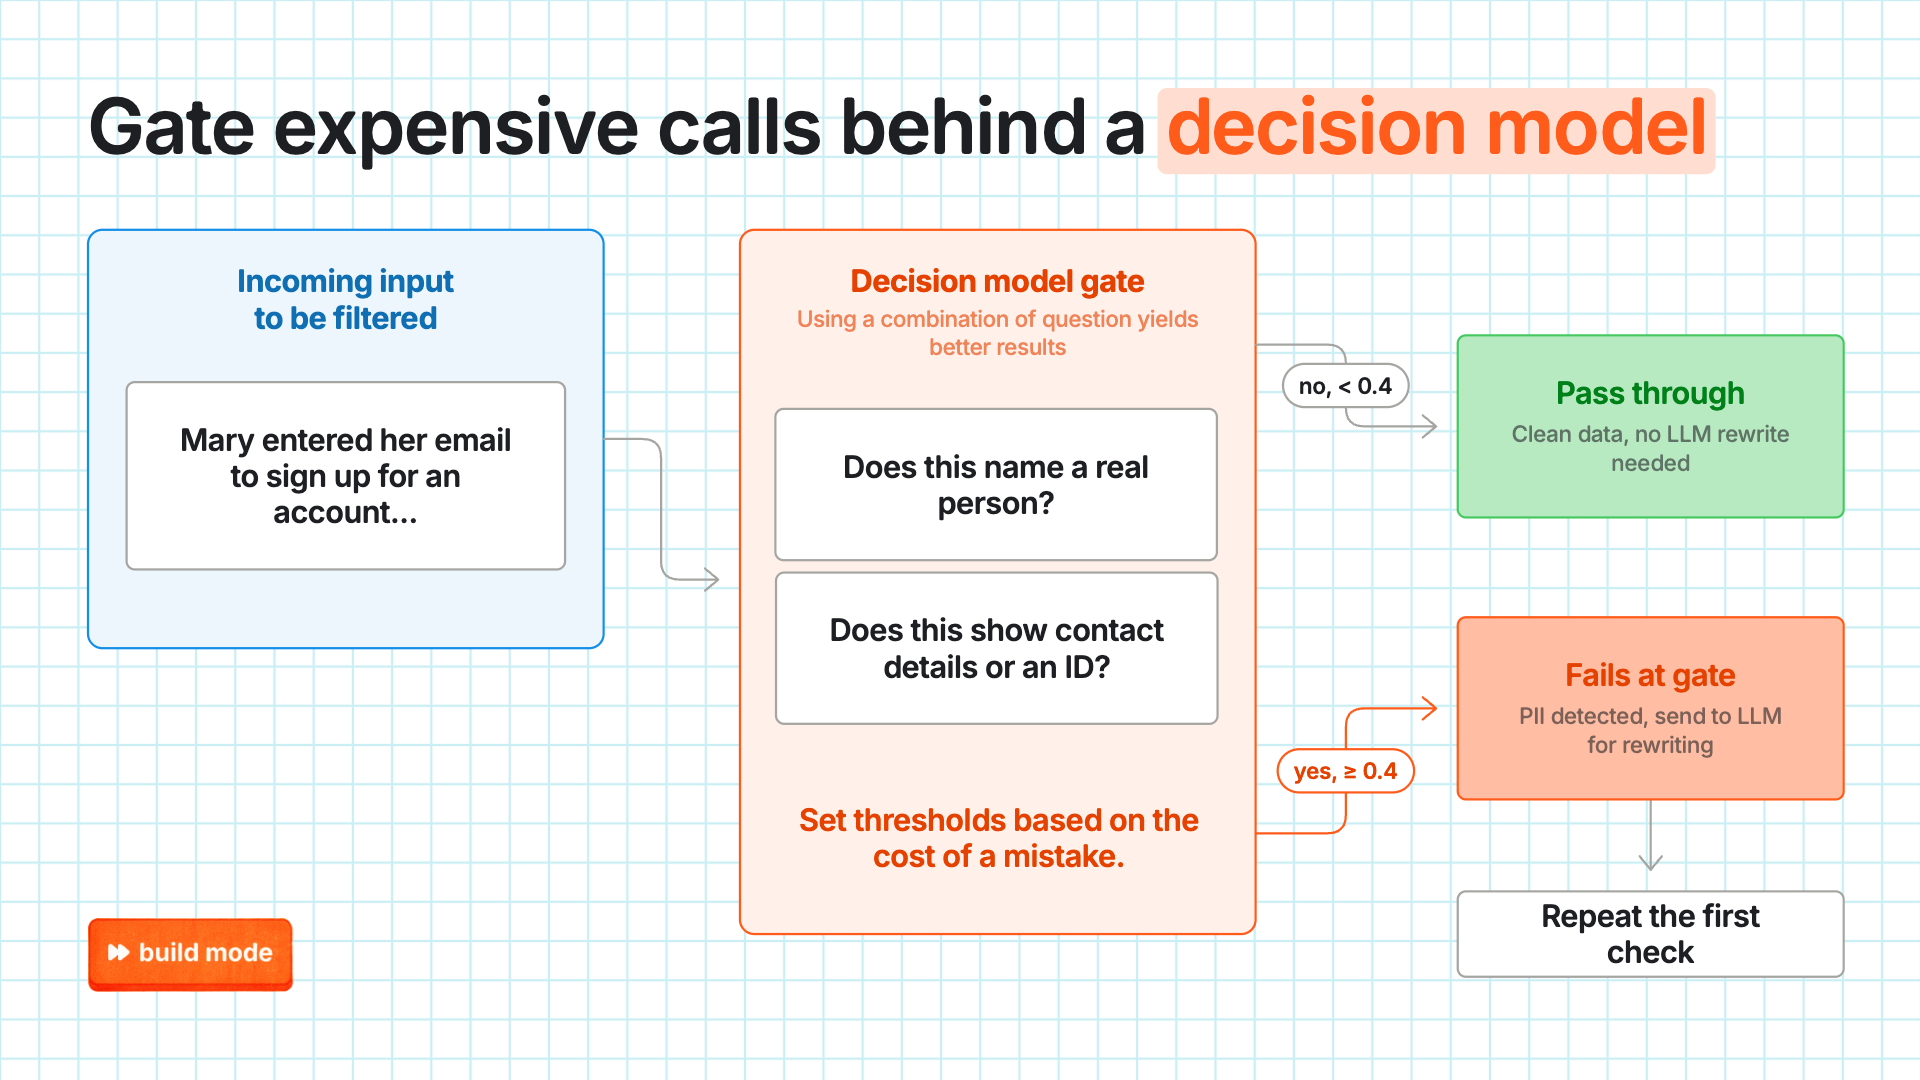
如果没有决策模型,我们就得不断摆弄那些会漏掉东西的提示词和正则表达式,或者把每个摘要都发给 Gemini,以捕捉那 1% 需要处理的。
0.85 的概率分数仍然意味着每 1,000 次检查中约有 150 个错误答案,所以要提前为误报和漏报做好规划。
在 PII 示例中,误报只会让我们多花一次 LLM 调用,而漏报则会把个人数据当作干净数据存储。这就是为什么我们把阈值设得很低,为 0.4。
当误报是代价更高的错误时,使用更高的阈值。例如,我们最近更新了 PostHog in Slack 机器人,使其无需被 @ 也能回答问题无需被 @。为了避免打扰用户,它会检查频道中的每条消息,判断 (1) 是否在询问信息,以及 (2) PostHog 能否回答。只有两项得分都在 0.85 以上的消息才会被处理。
要点:在触发昂贵的 LLM 调用之前,先用决策模型过滤任务,并根据哪种错误代价更高来设置阈值。
我们的PostHog in Slack机器人还将决策模型用作模型路由器。
当机器人被 @ 时,它首先检查消息是否要求使用特定模型。如果没有,就用一个choice问题从列表中挑选:
“选择最便宜的选项,它最有可能在第一次尝试时就正确完成任务。一次失败的运行比更聪明的选项代价更高。”
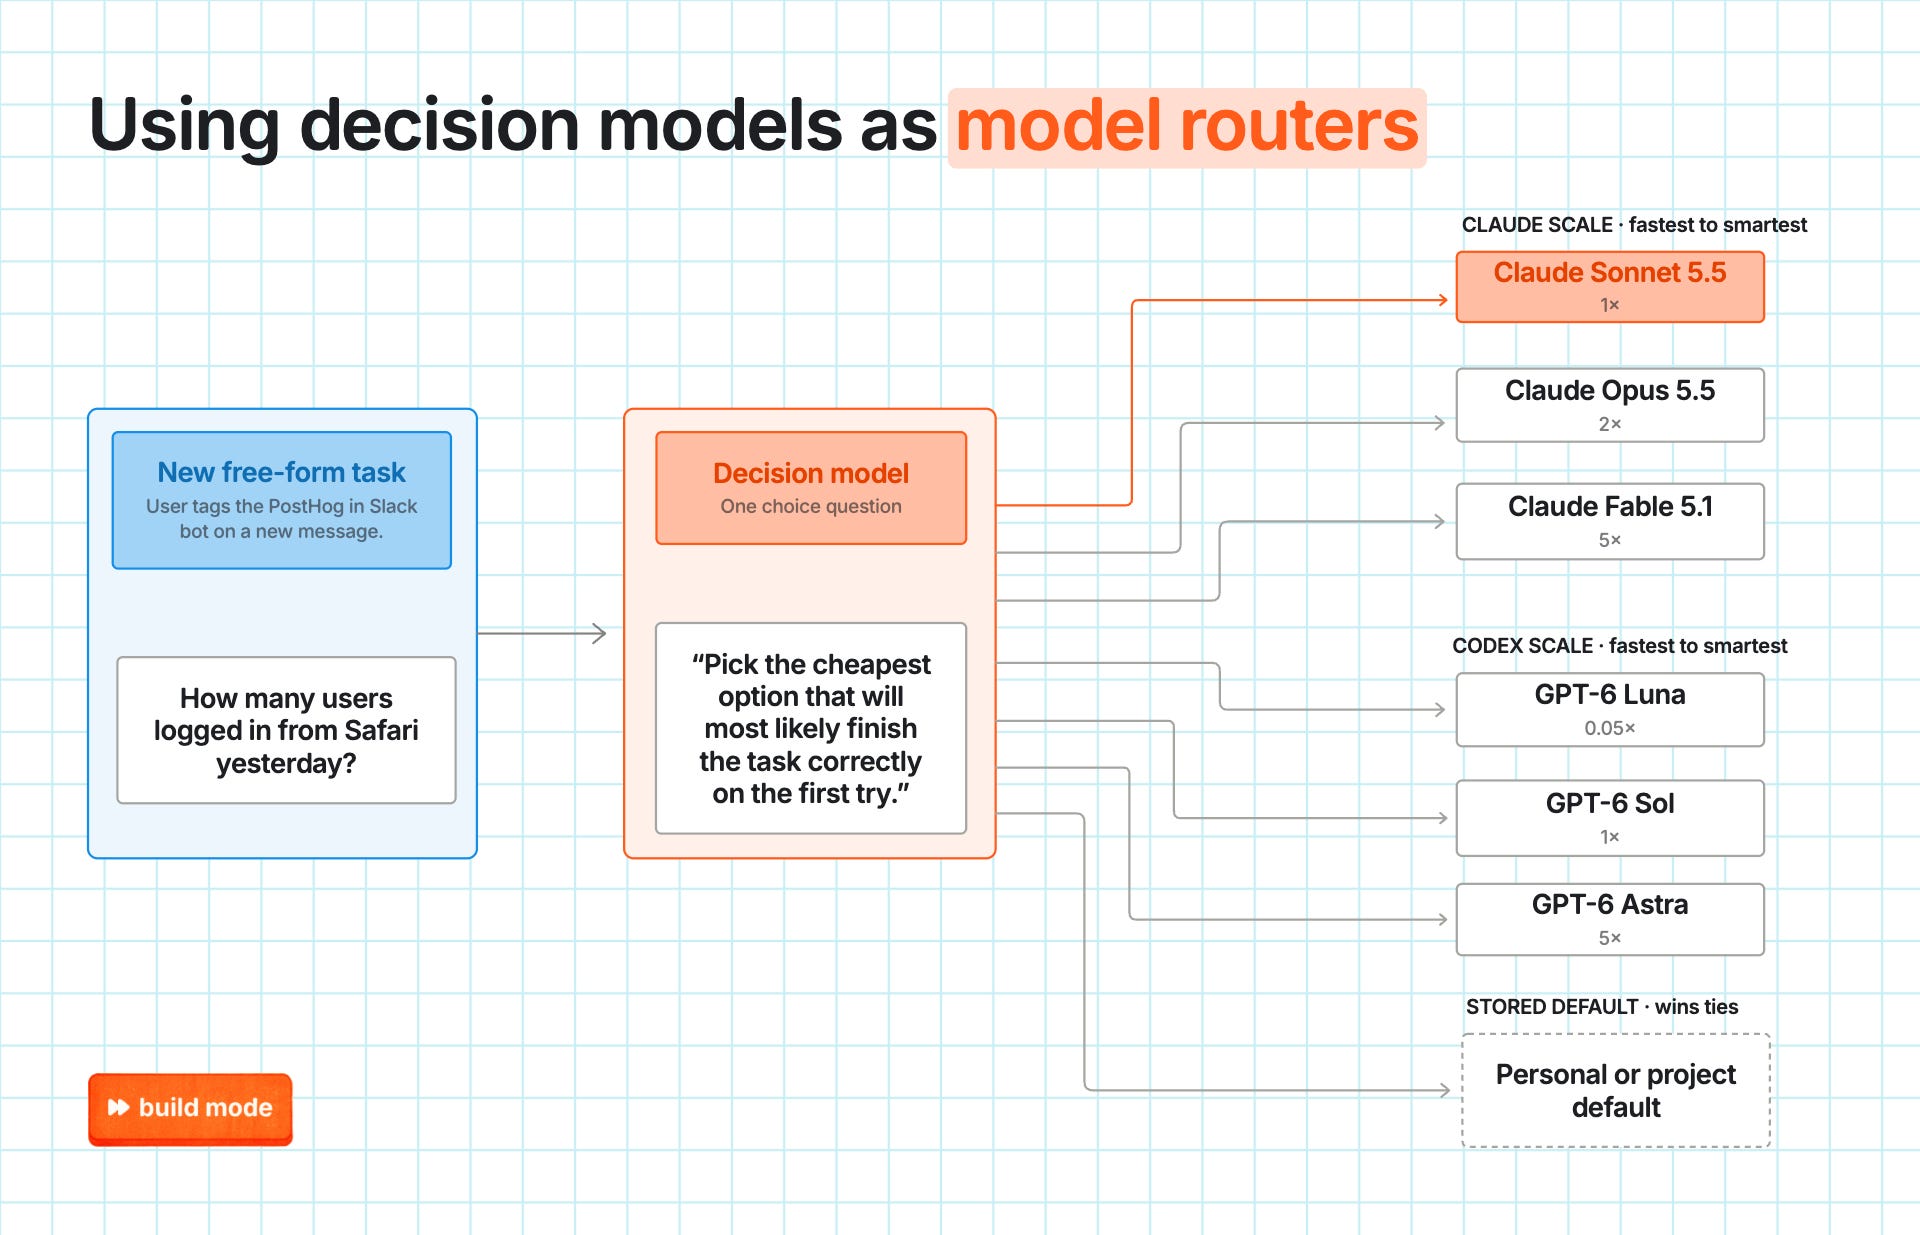
列表中的每个选项都附有简短说明,指出该模型擅长什么。GPT Luna 被描述为“一个轻量且非常便宜的模型。适合简短回答、查询、摘要和非常小的编辑。”决策模型随后会根据每个选项的文本对请求进行评分。
不同的任务、模型和提供商都有不同的阈值。
我们曾尝试用它们来自动合并错误追踪中的相似日志,结果发现同一模型的 v1 和 v2 之间阈值会发生变化。我们不得不让阈值可以按 PostHog 项目配置,并让评判器保持影子模式,同时基于人工标注数据重新校准。
这也是我们增长团队的Fernando早期就推动模型无关接口的原因之一。我们现在有一个内部 AI 网关,用于切换和测试模型,包括自托管模型。
要点:使用一个
choice问题将自由形式的 LLM 请求路由到能处理它的最便宜模型。请记住,阈值不能通用,因此要按任务和按模型分别设置。
如果一个问题需要更多上下文或推理链,最好使用 LLM。不过,如果你有办法将输入扁平化或预处理,使其可以在表面上被检查,你仍然可以使用决策模型。
在 Replay Vision 中,当用户搜索诸如 "onboarding friction" 这样的主题时,由于嵌入距离的工作方式,查询有可能返回一些意料之外的结果。
决策模型无法"对包含与用户搜索查询匹配的摘要的前 10 个会话进行排名"。这太复杂了。
因此,我们先用嵌入得出一个初始的会话录制列表,再传给决策模型。这样,决策模型剩下的唯一任务就是查看列表中每个结果与用户原始搜索词的匹配程度:
"这条摘要所描述的会话是否与搜索要找的内容匹配?"
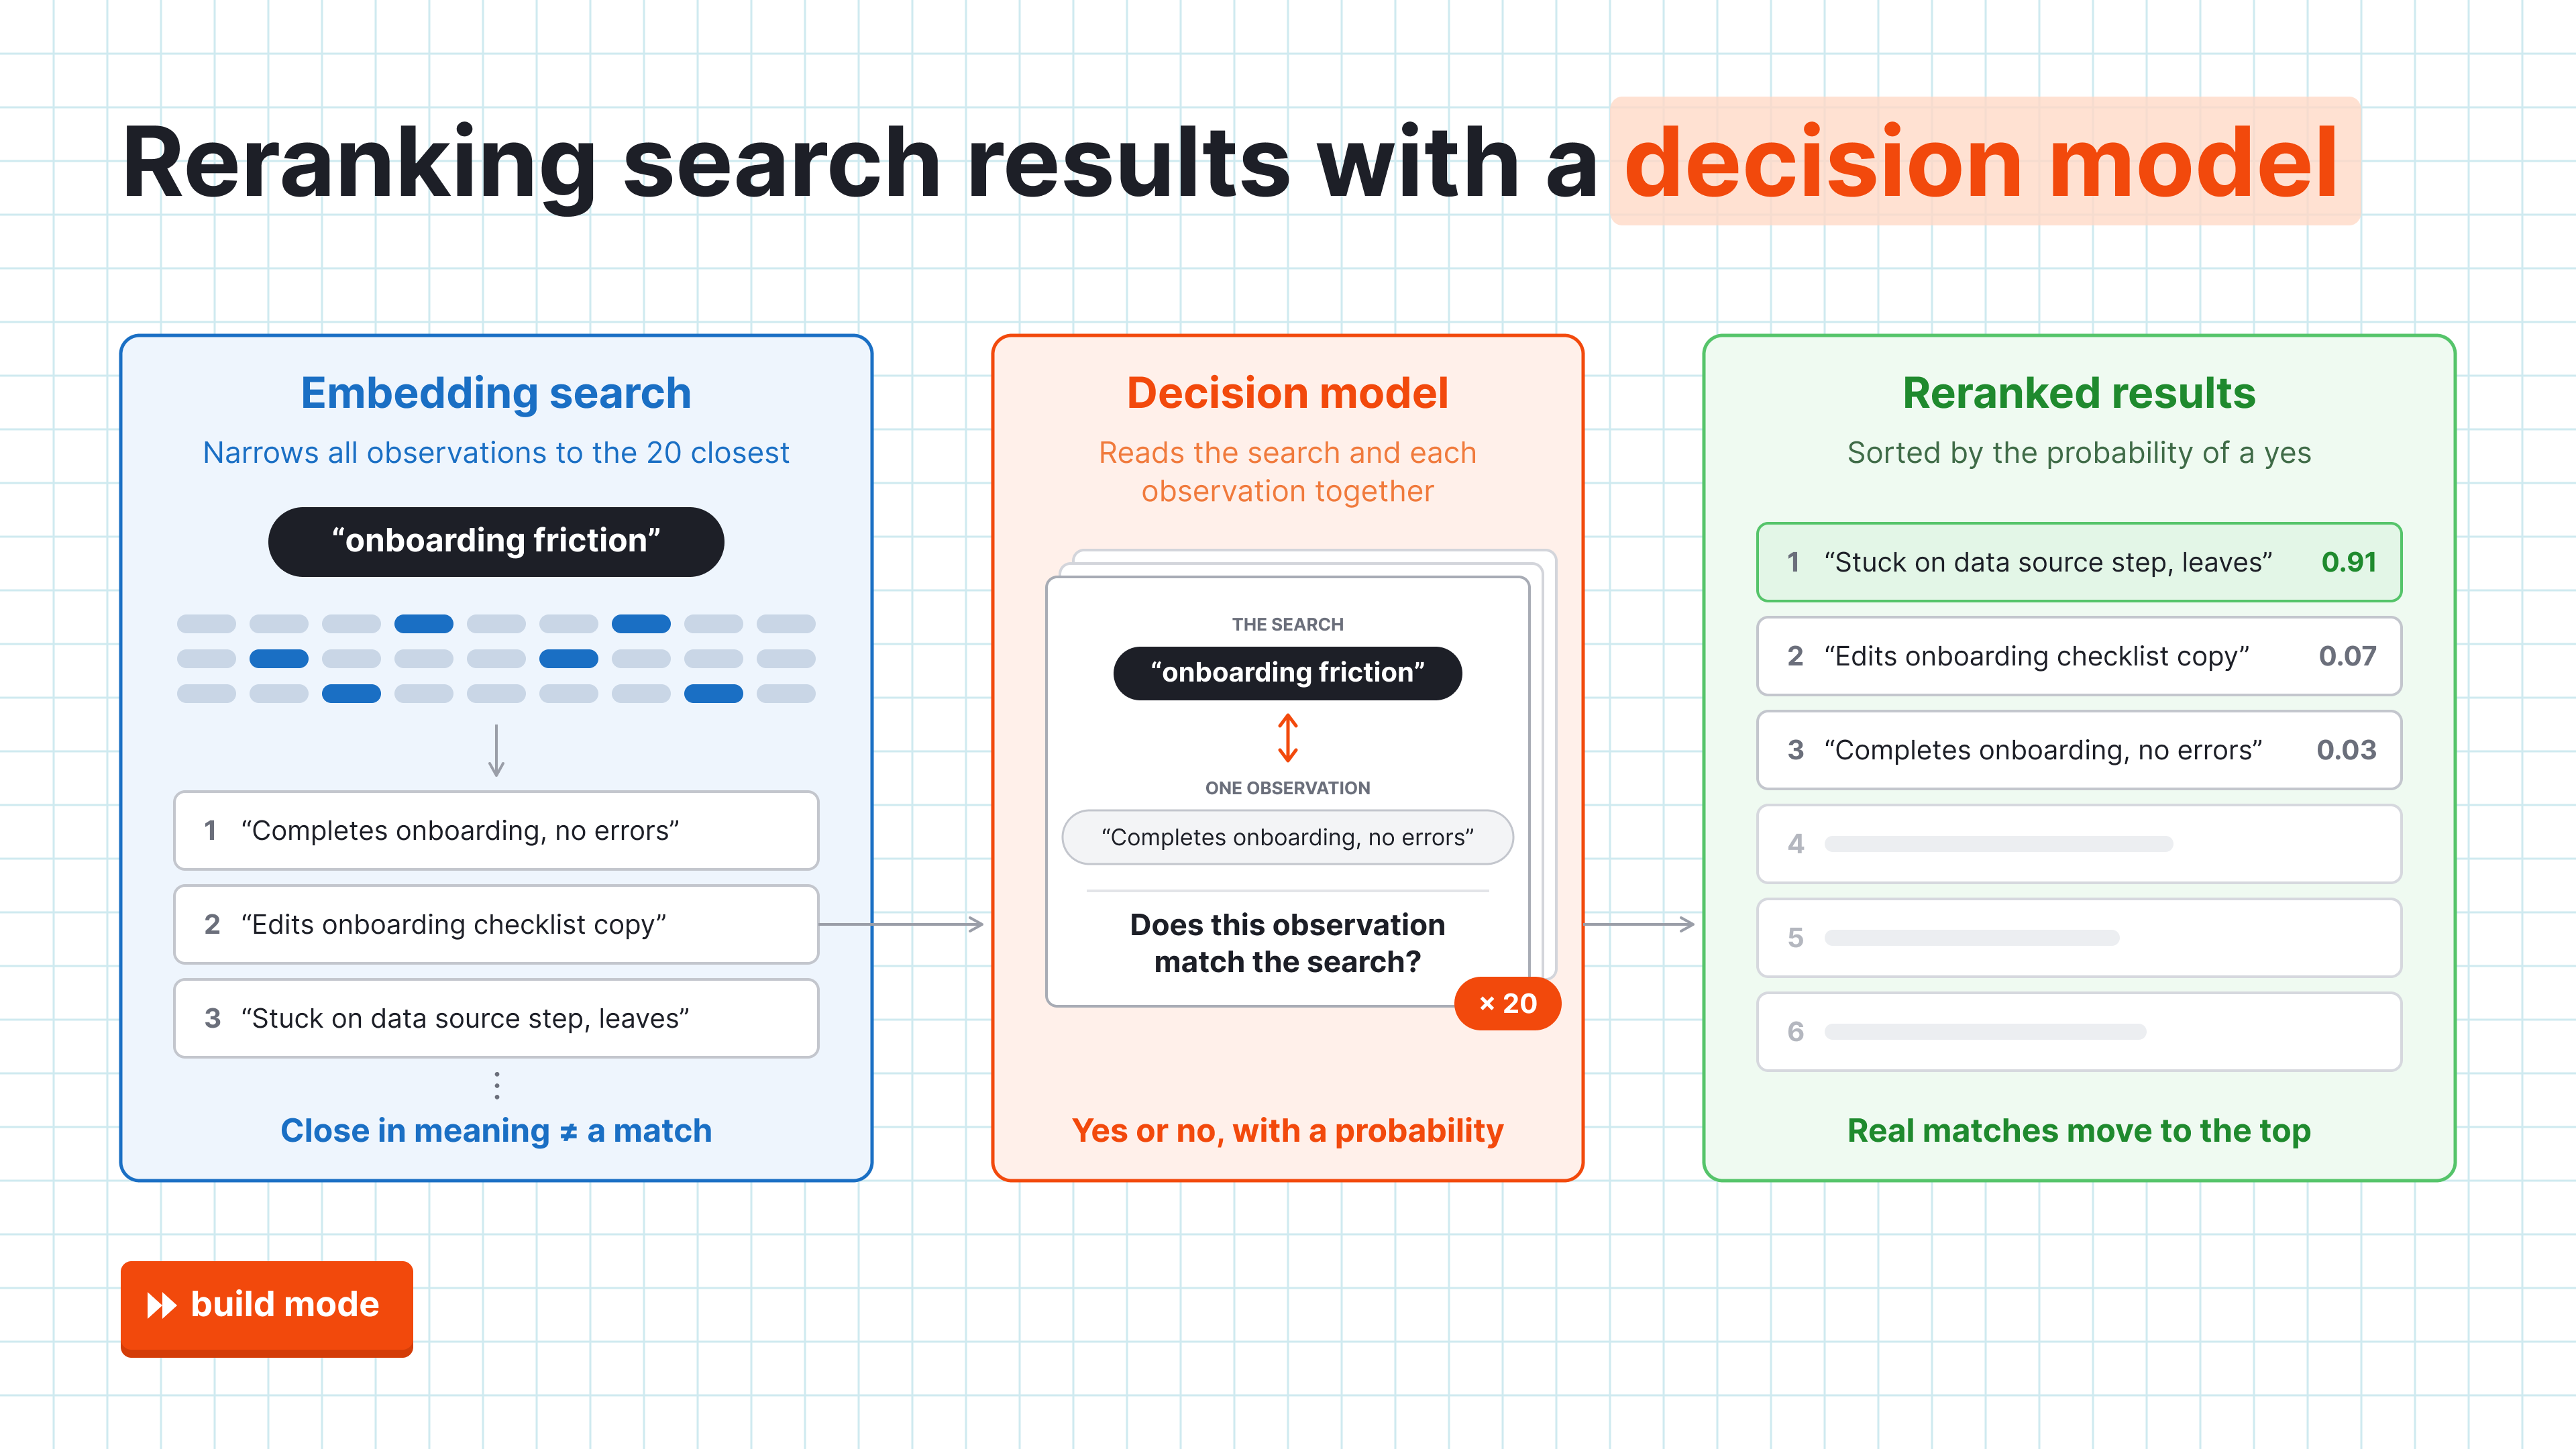
然后结果会重新排序依据该概率。在 20 条测试查询上,这使排序质量提升了约 25%。
我们之前尝试过使用决策模型进行多步推理。在 Replay Vision 的嵌入功能就绪之前,我们曾尝试对一个"亮点"信息流进行排名,筛选出值得用户花时间的会话。问题如下:
这个会话值得观看吗?
如果值得,为什么值得观看?(选项包括 "屏幕上出现错误"、"缓慢或卡住"、"用户困惑"、"用户放弃" 等)
按顺序处理这两个问题需要一个每小时运行的任务,发送大量请求——最多 32 个会话,每个 12-38k token——这会让模型服务器不堪重负,并阻塞其他产品的调用长达数小时。
所以,是的,从技术上讲,你可以把决策模型串联起来做多步判断,但在运营上并不值得。把这件事留给 LLM,或者像上面嵌入搜索的例子那样,在决策模型看到数据之前先完成繁重的工作。
要点:决策模型在一次处理中判断摆在它面前的内容。把多步推理留给 LLM。
凡是 LLM 属于大材小用的任务,决策模型都可以承担,无论是因为太慢还是太贵。
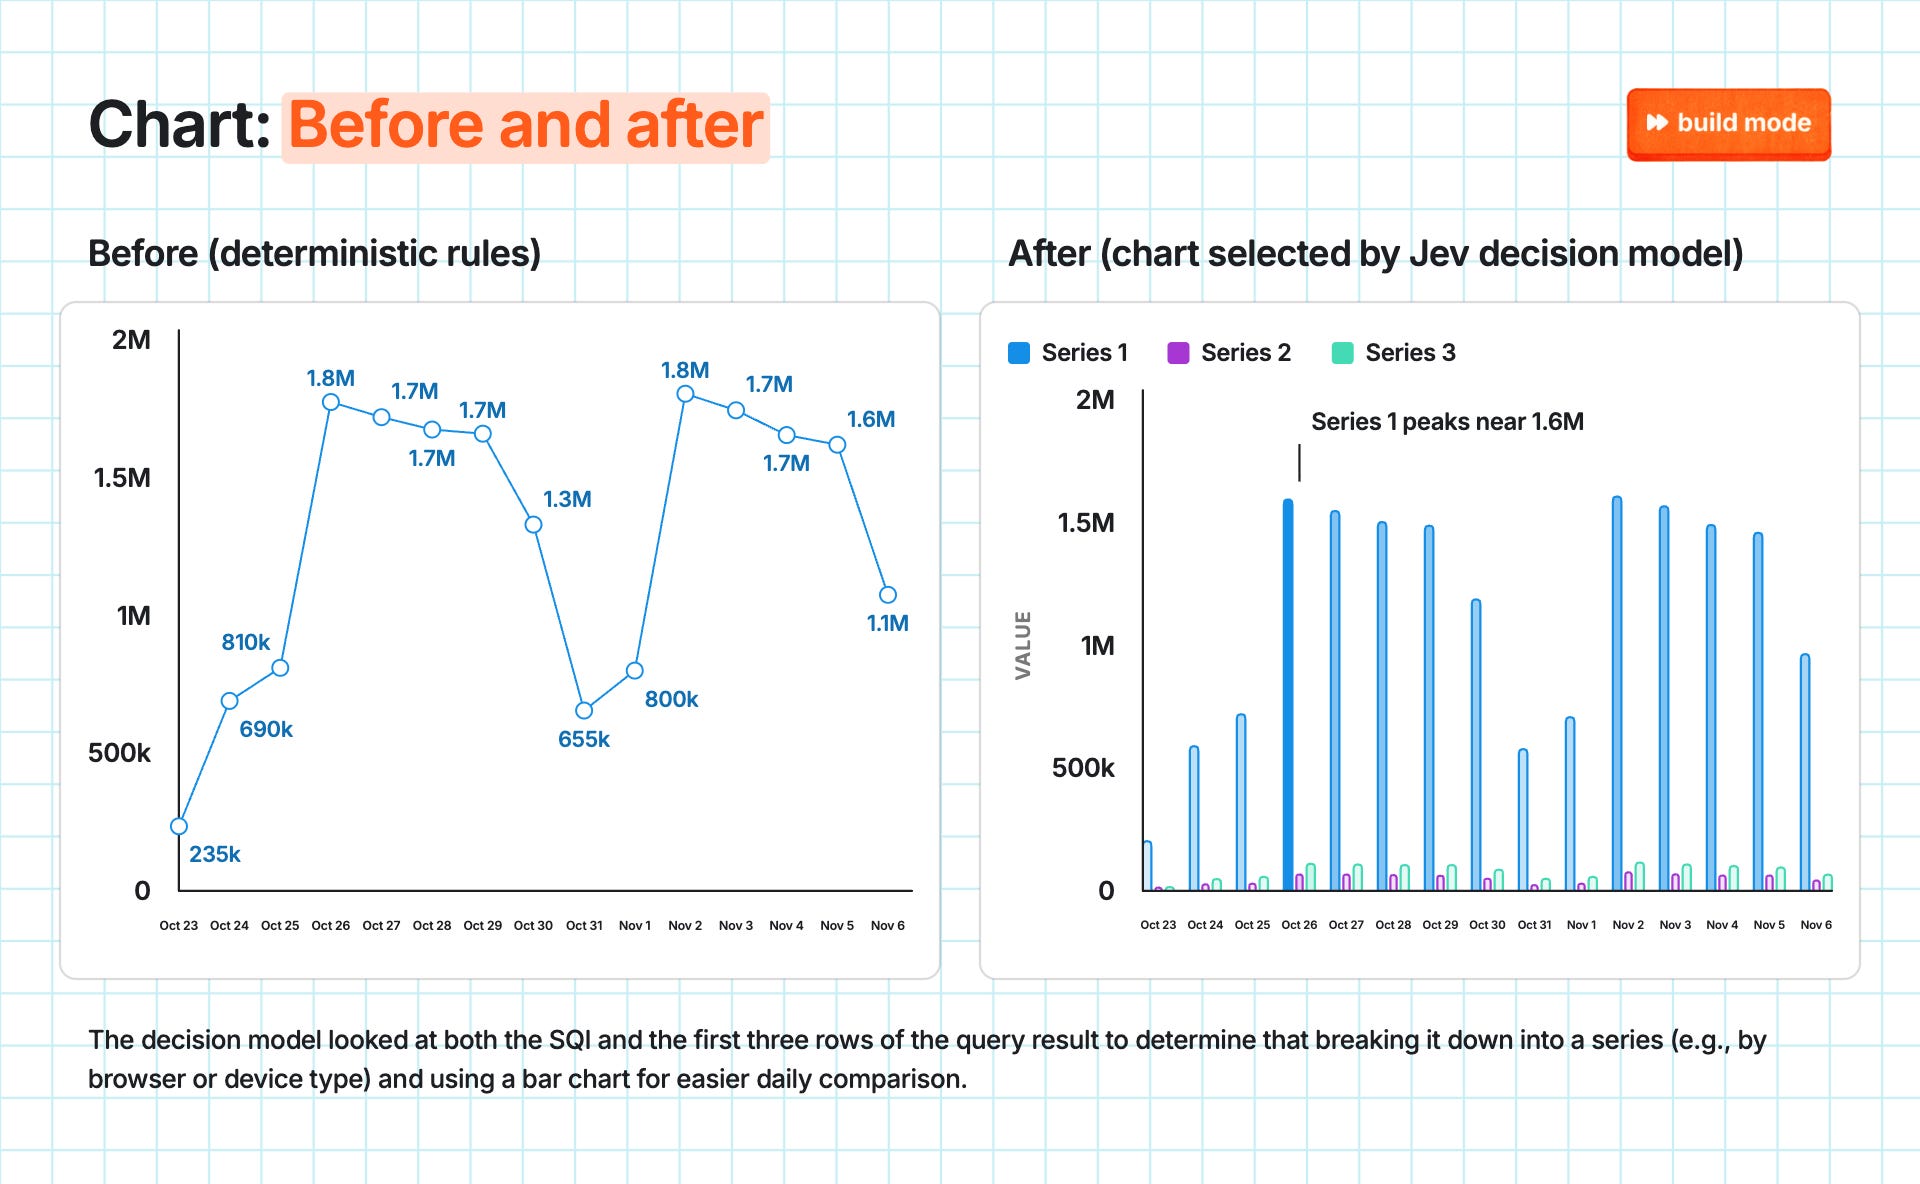
一个例子是我们更智能的图表选择器用于 SQL 查询。PostHog 过去使用确定性规则来选择可视化方式,例如:
一个日期列、一个数字列和多行 → 折线图
两个或更多文本列加一个数字 → 热力图
任意数字列 → 柱状图
现在,如果你的组织选择启用,决策模型会同时查看 SQL 本身以及结果的前三行,来建议更合适的图表。
下面的示例基于一个关于按浏览器统计页面浏览量的简单查询。原始规则选择了一个基础聚合折线图;使用 Jev 后,它选择了一个按浏览器拆分的柱状图:
任何更开放式的任务仍然应该交给 LLM。
不过,出于好奇,我们尝试用 Jev 对内部 PR 审查智能体的发现进行排序,使用了五个大致询问该变更是否值得开发者关注的 noul 问题。结果不确定,AUC 为 0.52。
如果 Jev 是 LLM,我们会通过发送更多上下文来解决这个问题,但 Jev 无法处理大型请求。它的长上下文模式也更慢且不够准确。2典型的决策模型并不是为这类推理而构建的。
像Jeeves这样的混合决策模型可以帮助弥合这一差距。由我们的内部 AI 研究团队开发,Jeeves 是一个决策模型,在不确定时会先推理再决定。
它现在是我们 PostHog 中任何未指定模型的决策调用的默认选择,其他开发者也有类似的变体,比如Kev。
要点:将决策模型用作评估器,适用于那些对语言模型来说太简单、但对正则表达式来说又太模糊的输入。任何更复杂的内容仍然过于复杂,无法交给决策模型。至少目前如此。
本文由 Jina Yoon 撰写,她预计这篇文章将在两个月内过时。
人们在 PostHog AI 中提示什么– Cleo Lant
软件背后的人– Karri Saarinen
为什么我们要将仓库产品从 DuckDB 迁移出去– Benjamin Knofe-Vider
睡眠框架:LLM 在持续学习中保留知识的新方法– Ali Behrouz, Vahab Mirrokni
我们使用预计算将实验查询速度提高了 4 倍– Juraj Majerik
Jev 默认每次请求接受 64k tokens,每个问题 32k。尽管 TypeSafe 添加了一个可选启用的请求头,将两者都提升到 262k,他们仍然警告说长上下文模式更慢且不够准确。来源:TypeSafe 文档