
今天我们发布Olmo-core 3,这是我们用于开发大型语言模型框架的一次重大升级,其特色是重新设计的开放混合专家(MoE)训练系统。
Olmo-core 3 旨在将 MoE 训练扩展到万亿参数级别,同时保持计算效率。它是下一代 Olmo 背后的核心系统之一,也是我们持续致力于开放每个新模型背后的工具和训练基础设施的一部分。
训练大型 AI 模型需要大量算力,这推高了成本和能耗,使许多学术研究人员和较小实验室无法进行先进模型的开发。MoE 模型提供了一种更高效的方法——它们可以包含多得多的学习组件(即参数),而无需让每个输入都使用全部参数。但完整模型仍然必须存储在 GPU 内存中并在训练期间更新,而在集群中将输入导向正确的专家——即 MoE 内的专门组件——会产生自身的通信和协调成本。随着 MoE 规模增长,这些成本可能侵蚀掉仅对每个输入使用部分模型所带来的大部分计算优势。
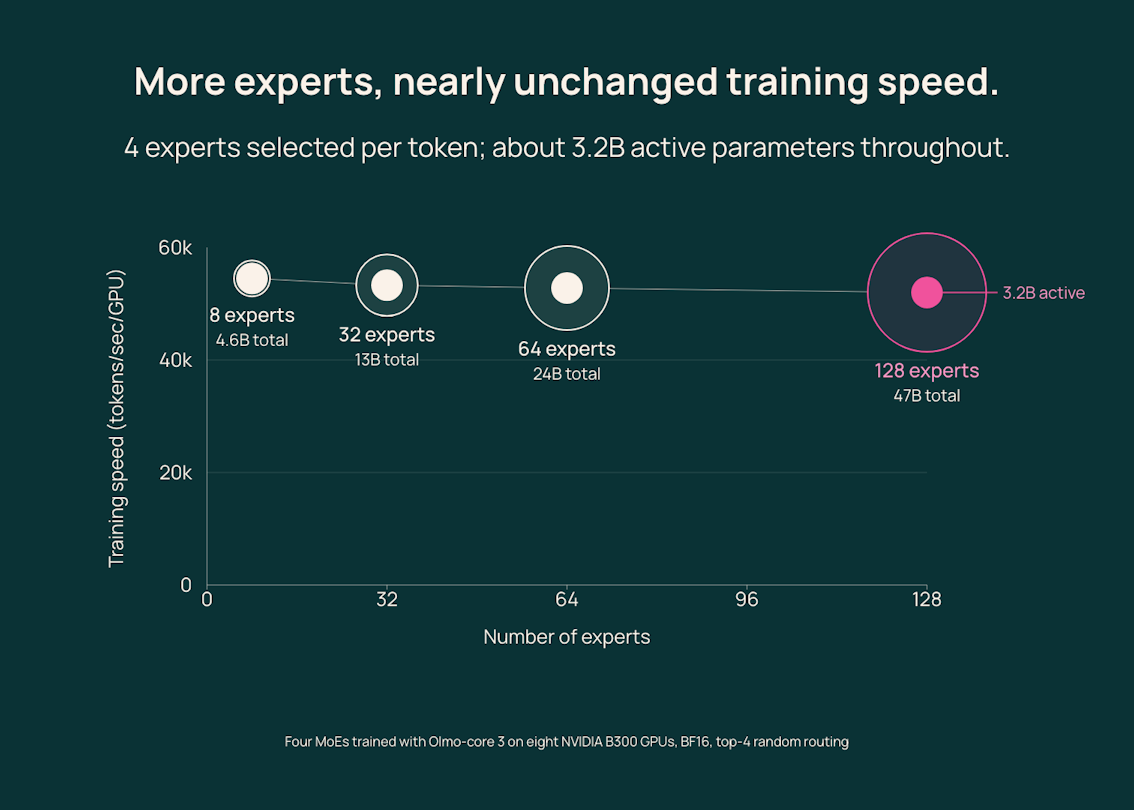
Olmo-core 3 的构建正是为了弥合这一差距。在一项基准测试中,我们将专家池从 8 个增加到 128 个,同时每个 token——语言模型处理的小段文本单位——仍然只选择四个专家,使每个 token 的活跃参数数量大致固定在约 3.2B。总参数容量从 4.6B 增长到 47B,而训练吞吐量下降不到 5%。
同一基础设施已在超过一万亿总参数的规模上进行了基准测试。
围绕 MoE 实际工作方式构建训练栈
Olmo-core 随着每一代 Olmo 不断演进。
我们在稀疏模型方面的工作可以追溯到OlmoE,它使用了带有 64 个路由专家的 MoE 架构。Olmo 3则相反,使用了稠密架构,这意味着几乎整个模型对每个 token 都是活跃的,其训练栈也是围绕该设计构建的。Olmo-core 3 通过一个专为更大规模 MoE 模型设计的训练系统扩展了该框架。
我们早期在 Olmo-core 中的 MoE 实现使用了完全分片数据并行(FSDP),配置为在每个小批量训练数据上收集并重新分片模型权重。Olmo-core 3 切换到一个基于分布式数据并行(DDP)的系统。它让专家常驻在 GPU 上,并将相关数据路由到它们那里,从而避免了反复收集权重。
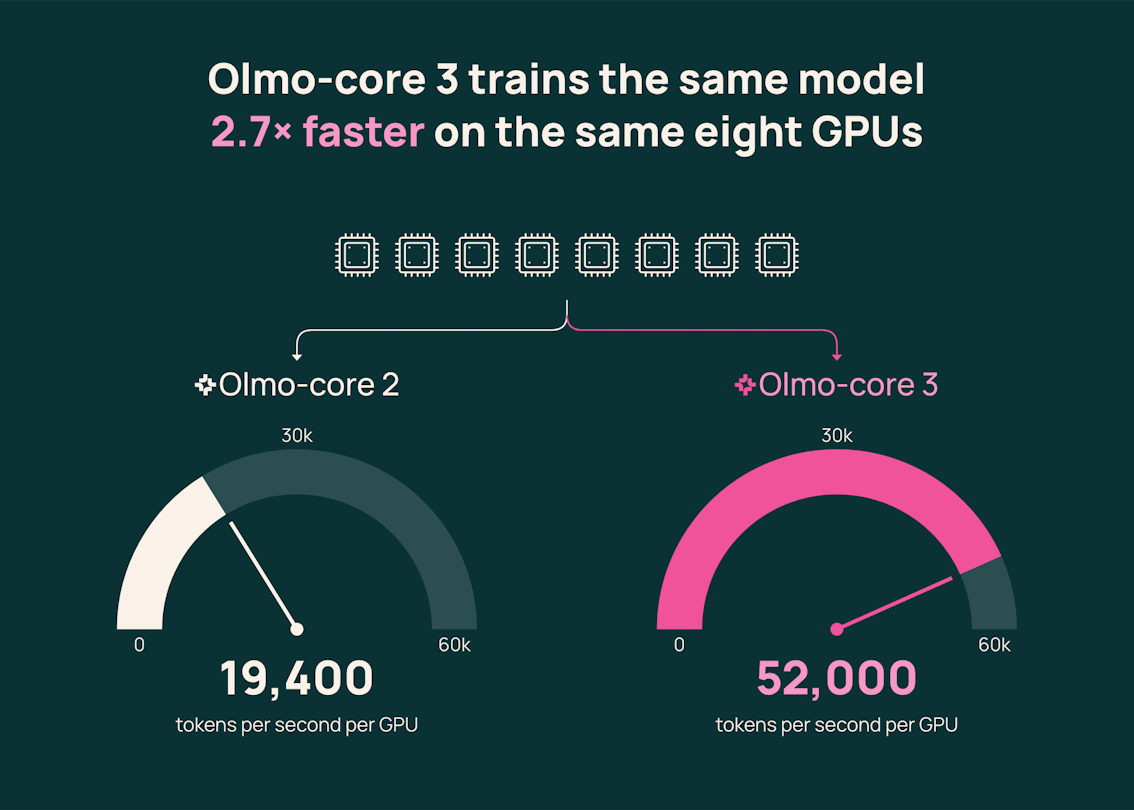
NVIDIA 的 Megatron-Core 是训练大型 MoE 的成熟选择。Olmo-core 3 为 Olmo 背后的框架带来了集成的 MoE 训练栈,其重新设计相比我们早先基于 FSDP 的实现提升了吞吐量。在八块 NVIDIA B300 GPU 上的初步测试中,一个 470 亿参数的 MoE 使用新栈每 GPU 每秒处理 52,000 个 token,而使用我们早先的实现为 19,400 个——约为 2.7 倍的吞吐量。
扩展和优化 MoE 训练
Olmo-core 3 结合了多种将大型 MoE 分布到 GPU 集群上的技术,以及使路由和计算更高效的优化。
有三种技术决定模型及其训练状态如何在硬件上拆分:
- 专家并行将专家分散到各 GPU 上,因此每块 GPU 只存储整个专家池的一部分。
- 流水线并行将模型的层——即依次转换输入的各个阶段——拆分到多组 GPU 上,减少每块 GPU 需要在内存中保留的模型部分。
- 分布式优化器将优化器状态——即训练期间用于计算和应用更新所附加的数据——分散到各 GPU 上,而不是在每块 GPU 上存储完整副本。
这些技术共同使 MoE 能够扩展,而无需每块 GPU 都在内存中保留整个模型及其训练状态。
Olmo-core 3 还降低了将数据路由到正确专家并运行其计算的开销。按行专家并行将路由后的数据直接放入专家输入缓冲区,最大限度地减少重新排列它所需的额外工作。GPU 常驻路由将路由元数据保留在 GPU 上,因此 CPU 可以排队工作,而无需等待该信息被复制回来。而分组 GEMM将许多小的专家计算合并起来,使 GPU 能更高效地执行它们。
最后,Olmo-core 3 支持MXFP8,一种低精度数字格式,用更少的位来表示某些值。只要节省的开销超过数字格式转换的成本,这就能减少计算量以及 GPU 之间传输的数据量。
我们在四块 NVIDIA B300 GPU 上进行了一项受控基准测试,将工作负载均匀分配到各个专家上,以此衡量 MXFP8 对端到端训练吞吐量的影响。在系统中最能受益的部分启用 MXFP8 后,训练吞吐量比我们用作基线的更高精度格式 BF16 高出约 21%,同时峰值活跃内存从 103 GiB 降至 95 GiB。大部分收益来自前馈计算以及专家之间的数据传输,而非仅来自注意力机制。
这些技术和优化必须协同工作。加速训练的某一部分可能会在其他地方产生开销;更快的计算可能需要更多的数据传输,而传输更少的位如果转换数据耗时过长也可能无济于事。Olmo-core 3 围绕整个训练过程中的这些权衡而构建,让我们——以及使用这套开源技术栈的研究人员——能够控制各个部分如何组合在一起。
探索我们的交互式演示,了解数据并行、专家并行和流水线并行如何协同工作,将 MoE 训练从单块 GPU 扩展到多块 GPU。

扩展到万亿参数级别
我们在 NVIDIA B300 GPU 上对 Olmo-core 3 进行了多种配置的基准测试,其中包括一个 1.2 万亿参数的模型,在 512 块 GPU 上每个 token 激活 583.6 亿参数。其观测到的最高吞吐量为 858 TFLOP/s/GPU——这是衡量每块 GPU 每秒有用模型计算量的指标。这些测试使用随机路由来衡量系统性能,而非衡量训练后模型的质量。
我们还试验了 DeepEP v2,这是一种在 GPU 之间处理专家间通信的替代方式,达到了总参数 2.38 万亿的配置。这是一次短容量测试,而非完整训练运行,因此它展示的是 Olmo-core 3 所能达到的规模,而非持续训练性能。
在这样的规模下,系统性能只是全貌的一部分。我们的技术报告还记录了那些为如何训练 MoE 以及衡量其性能提供依据的实验。例如:
- 一个旨在鼓励均衡路由的分数,甚至可能在实际工作负载变得不那么均衡时反而提高。我们把这种失败称为token gerrymandering。
- 降低专家的学习率——即其训练更新的幅度——因为它们处理的 token 更少,在我们测试的模型系列中并没有改善结果。
- 当被处理的值发生变化时,即使矩阵维度相同,GPU 计算所花费的时间也会不同。因此,性能比较不仅需要匹配形状,还需要匹配输入值。
- 在独立的 GPU 流上重叠通信和计算并不总能加快训练速度。在某些测试中,它反而拖慢了端到端执行——这提醒我们,更多的重叠并不一定意味着更高的吞吐量。
报告解释了这些发现,以及我们测试过并选择不采用的方法。
为下一代 Olmo 打造,向所有人开放
Olmo-core 3 是我们接下来要构建之物的基础。我们的下一代 Olmo 将采用 MoE 架构,我们的目标是让它成为迄今为止能力最强的 Olmo,在我们最大的数据集上训练,并拥有我们最长的上下文窗口。
这个新栈让我们能够超越以往的 MoE 工作实现扩展,同时为我们提供更多灵活性,以便随着模型和硬件的演进来调整训练。而且它完全开放——研究人员和开发者可以使用 Olmo-core 3 训练自己的 MoE,将其适配到不同的硬件,并试验路由、并行以及系统的其他部分。
这也是我们思考开放模型开发方式的一部分——当模型权重背后的基础设施和训练决策也开放时,模型权重才更有用。
如需更深入地了解系统设计、实验、消融以及我们一路测试过的方法,请阅读我们的技术报告并在 GitHub 上探索 Olmo-core 3。