2026 年 9 月 23 日
|
Gemini 3.8 Flash TTS 和 Gemini 3.8 Flash-Lite TTS 是我们迄今为止最具表现力的音频生成模型。在 Google AI Studio、Gemini API、Gemini Enterprise、Gemini Notebook 和 Google Vids 中生成自定义角色语音并指导场景对话。
Leland Rechis
集团产品经理
Alan Cowen
研究科学总监,代表 Gemini Audio 团队
今天,我们为 Gemini 家族引入两款新的文本转语音模型,将语音生成从静态预设转变为动态创意工作室。这些模型使创作者、开发者和企业能够创建更丰富、更具表现力的音频体验,同时改善诸如Gemini Notebook和Google Vids等产品中的用户体验。
- Gemini 3.8 Flash TTS:专为深度创意指导和角色设计而打造。使用自然语言提示从零开始创建全新的语音,让角色在游戏、沉浸式有声书、播客和互动媒体中栩栩如生。通过对话术提示、节奏、方言转换和附和语的精细控制,逐行指导每一句表演。
- Gemini 3.8 Flash-Lite TTS:专为高吞吐量、高成本效益的规模化而打造。针对大批量配音、音频内容创作和富有表现力的语音智能体进行了优化,可对语调、节奏和表现力细微差别进行细粒度控制。
这些模型补充了我们快速增长的 Gemini Audio 家族,紧随3.5 Live Translate、3.5 Transcribe、3.8 Live 和 3.8 Live Extended Thinking之后。
创建并自定义你自己的语音
从 30 种原创语音扩展到无限语音库。无论你需要完全原创的角色语音还是一致的品牌代言人,我们的 3.8 Flash TTS 模型都能驱动一个完整的语音工作室。这使你能够为每个时刻创建并使用富有表现力、听起来自然的语音,同时赋能开发者和企业轻松构建自定义音频体验。
- 生成式语音设计:借助 Gemini 3.8 Flash TTS,你可以通过自然语言提示,在 100 多种语言和方言中自定义角色、口音和声音特征,从零开始打造专属声音——无论你是想让一只戏剧性的喷火巨龙活灵活现,还是塑造一位带有鲜明地域韵律的魅力旁白。
- 丰富的声音库:访问 2,000 多种可直接用于生产的声音,覆盖广泛的语言——包括墨西哥西班牙语、魁北克法语和苏格兰英语等地区变体。
- 声音复刻:仅需一段 30 秒的音频样本,即可复刻出稳定一致的声音特征,样本可以是你自己的声音,也可以是你拥有使用权的他人声音;该功能内置同意验证、SynthID 水印和 C2PA 凭证,以同时保护开发者和他们的配音人才。
- 保存与扩展:保存并管理你设计的自定义声音,确保在持续进行的项目中保持一致的性能表现并将漂移降到最低。
- 声音混音:即将推出:从我们的声音库中挑选一个声音,微调音色、音高、语速和口音。使用提示来调整特征(例如“加入微妙的美国南方口音”或“让表达更柔和”)。
逐行指导表演
选定声音后,两个 TTS 模型都能让你精确控制每一行的表达方式。
- 逐行指导表演:你可以自己编写舞台指示,也可以让 Gemini 通过自然的脚本提示来引导表达——从冷静的客服智能体到低语的悬疑场景。
- 长音频生成:在长达数小时的连续音频中保持高音质、自然的节奏和角色音色,并将说话人漂移降到最低——非常适合播客和有声书。
- 原生双人场景编排:从单一脚本无缝指导多轮对话——无论是播客还是戏剧化叙事——同时让两个声音保持清晰区分,并实现自然的对话轮替。
- 脚本化的人声爆发与附和:使用非语言提示(如 <laughs>、<sigh>、<gasp>)和积极倾听的插话(如 |mhm| 或 |yeah|)添加逼真的对话质感,以实现精准的喜剧节奏和反应节拍。
获取为全球规模打造的表现力强、高质量语音生成能力
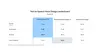
Gemini 3.8 Flash TTS 提供领先的语音定制能力,在以下方面夺得综合第一Hume AI 的Voice Design Benchmark(71.4),并在口音建模方面同样领先(60.8)。
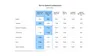
Gemini 3.8 Flash TTS 和 Gemini 3.8 Flash-Lite TTS 在不牺牲可靠性的前提下实现真正富有表现力的表演,并分别在 Hume AI 的 Overall Quality Index 上夺得第一和第二名。与 Gemini 3.1 Flash TTS 相比,该模型在长篇内容和双人剧本控制等广泛用例上展现出重大改进。
在盲测人类偏好评估中,Voice Arena上,Gemini 3.8 Flash 和 Flash-Lite TTS 在日语、巴西葡萄牙语、越南语、现代标准阿拉伯语(MSA)、墨西哥西班牙语和印地语等关键全球语言中,于竞争对手之间占据领先位置。这些模型支持超过 100 种语言,赋能创作者、开发者和企业在全球范围内构建高质量的多语言语音体验。

以信任、同意和透明为基础构建
我们在构建语音创建和复刻能力时采用了严格的保障措施,以帮助保护配音人才、尊重身份并确保内容透明。对于语音复刻,我们的系统利用同意验证:用户必须提供来自声音所有者的口头同意录音,且该录音需与参考说话人匹配,之后才能创建语音。
更广泛地说,我们的 Gemini Audio 模型生成的每一段音频片段都带有SynthID水印。这种不可感知的水印直接编织进音频输出中,确保 AI 生成的语音保持可检测,以帮助防止错误信息。有关我们安全与责任方法的更多细节,请查看模型卡。
试用我们全新的 Google AI Studio 音频游乐场
从今天起,开发者可以在语音生成中体验这些全新的Google AI Studio能力。它就像一个语音设计工作区,你可以从零开始提示全新的声音身份,或复刻你自己的声音1,然后直接将它们带入双人剧本编辑器,逐行指导演绎。
在 Google AI Studio 中试用语音复刻。


开始使用我们最新的 Gemini Audio 模型:
Gemini 3.8 Flash TTS 从今天开始逐步推出:
- 面向开发者:在Gemini API和Google AI Studio
- 面向企业:即将通过 API 在Gemini Enterprise
- 面向所有人:在Gemini Notebook。
Gemini 3.8 Flash-Lite TTS 从今天开始逐步推出:
- 面向开发者:在Gemini API和Google AI Studio
- 面向企业:即将通过 API 在Gemini Enterprise
- 面向所有人:在Google Vids