使用 SAM 2 进行实时多摄像头跟踪,可在一张或多张 GPU 上运行。
SAM 2 及其更小的兄弟 EdgeTAM 可以跟踪你指向的任何东西,但它们的代码是为一次处理一段录制视频而写的。
tamserve 是它们缺失的推理服务引擎:一份模型副本即可跟踪每台摄像头上的每个对象,只要摄像头还在运行就一直跟踪。
指向要跟踪的对象,或者说出它的名字("dog"、"the red mug"),tamserve 就能找到它。


为什么选择 tamserve·初次接触视频跟踪?·使用它·按名称跟踪·工作原理·结果·限制
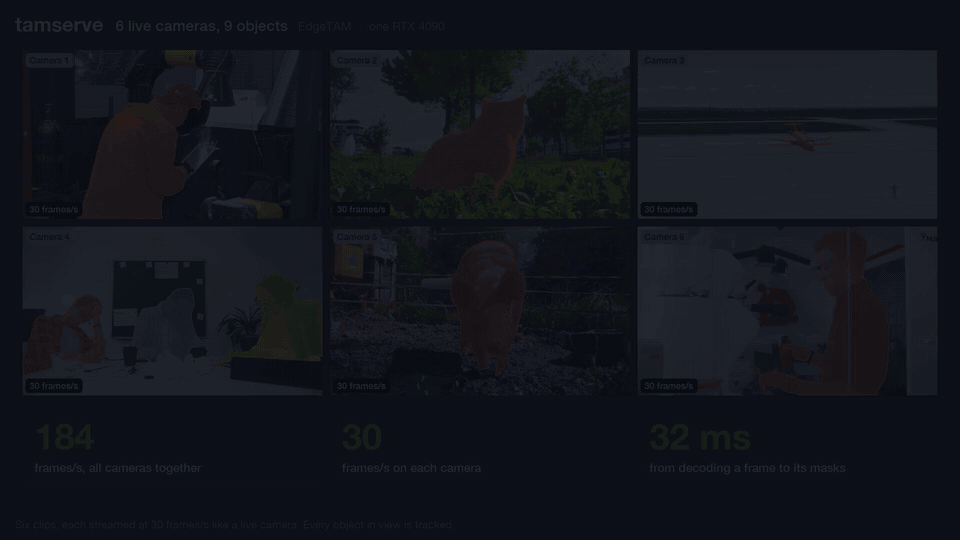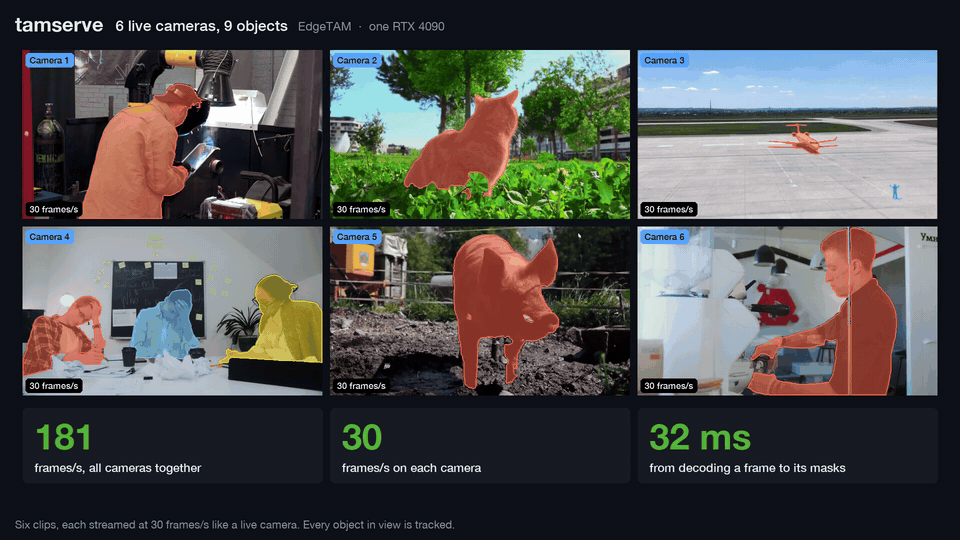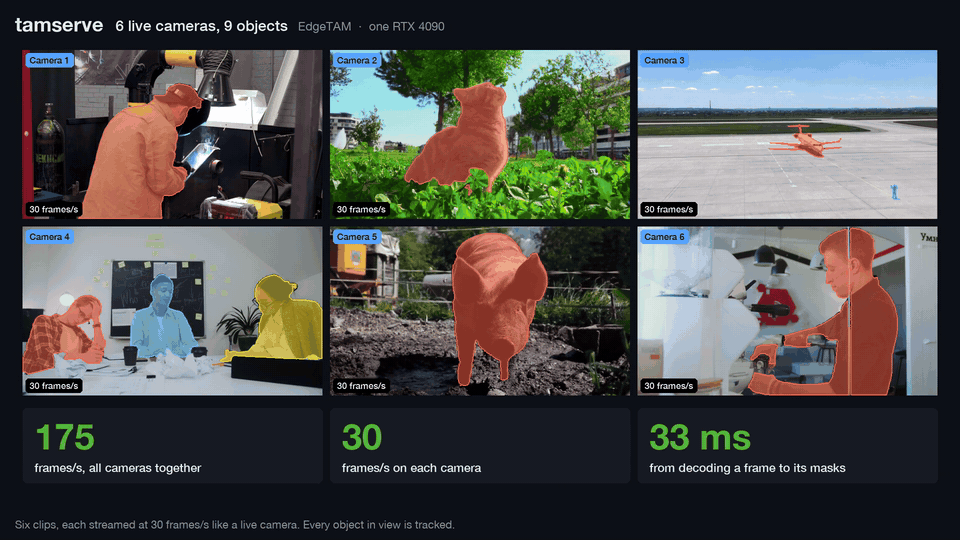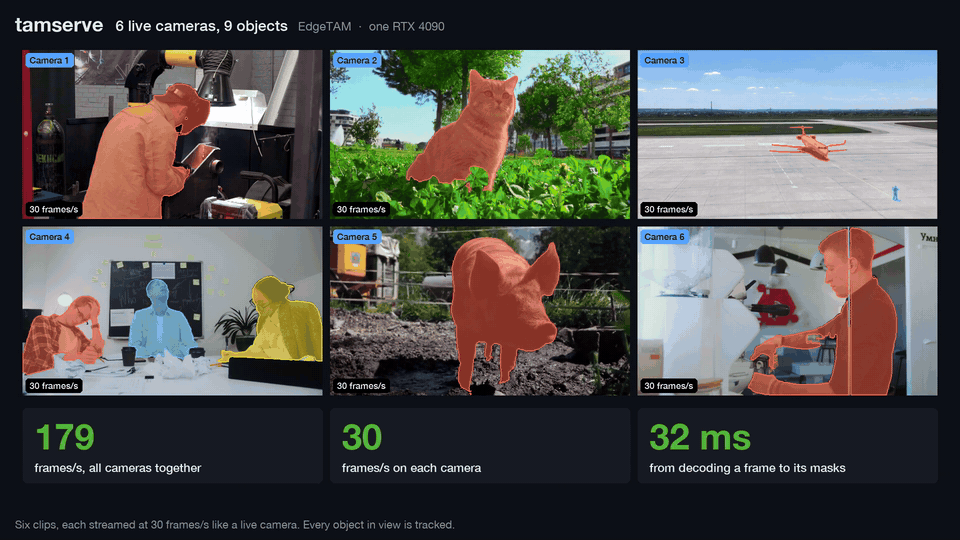
为什么选择 tamserve
这些模型非常出色。但随模型附带的代码是为编辑单段录制视频而写的,而将其用于多台摄像头的常见做法是为每台摄像头各运行一份独立的模型副本。每多一份副本、每多一分钟视频,内存都会不断累积。
tamserve 所做的,正是 vLLM 等 LLM 服务器为聊天所做的那样:每台摄像头共享同一份模型副本,某一时刻需要 GPU 的任务会一起通过它处理。事实证明,这不仅更轻量,也更快;而且由于模型本身未被改动,结果完全一致。
| 模型自带代码 | tamserve | |
|---|---|---|
| 多台摄像头 | 每台摄像头一份模型副本 | 所有摄像头共用一份 |
| GPU 内存,8 台摄像头 | 8.6 GB | 2.2 GB |
| 速度,1 台摄像头 | 177 帧/秒 | 219 帧/秒 |
| 速度,8 台摄像头 | 280 帧/秒 | 323 帧/秒 |
| 64 台摄像头 | 需要约 70 GB GPU 内存 | 5.7 GB 下达到 321 帧/秒 |
| 800 帧视频的 GPU 内存 | 9.8 GB | 0.28 GB,无论运行多久 |
| 在流中途开始跟踪新对象 | 不可能 | 任意帧均可 |
| 查找要跟踪的对象 | 你需要逐个指向每个对象 | 你指向它,或者说出名字,然后由Tracker自行找到并跟踪所有匹配项 |
| 多张 GPU | 你需要手动在它们之间分配摄像头 | 一个Router负责放置摄像头并汇总所有结果 |
| DAVIS 2017 上的准确率 | 0.8686 | 0.8685 |
以上数据为 EdgeTAM 在单张 RTX 4090 上的表现,对比对象是 EdgeTAM 自带代码的最快配置:编译后、每台摄像头一份副本、全部共享 GPU。速度为各摄像头合计,每台跟踪一个对象。对于更大的 SAM 2.1 模型,tamserve 的运行速度与 Meta 当前的 SAM 2 代码相同,GPU 内存占用约为其三分之一。结果有完整表格。
刚接触视频跟踪?
假设你有一段视频,你需要知道某个特定目标在每一帧中的位置:这个人、那台叉车、那只狗。这就是跟踪。SAM 2 及其更小的同类模型 EdgeTAM 和 SAM 2.1 是 Meta 的模型,在这方面做得非常好。你只需在某一帧上指向目标一次,模型就会在之后的每一帧上画出它的精确轮廓。
tamserve 位于这些模型之一和你的程序之间。你的程序把每台摄像头的最新帧交给它,然后取回每一帧中每个被跟踪对象的轮廓。你可以随时开始跟踪新目标或停止跟踪,摄像头也可以随时接入或断开。
它面向任何需要回答“这个东西现在在我的每一路视频流中究竟在哪里”的人:体育和广播图形、仓储和零售分析、机器人、野生动物和实验室监测、标注工具。
有两种方式说明要跟踪什么。你可以指向:由人点击画面,或由检测器指出目标的位置,然后 tamserve 接手。或者你可以命名它:一个Tracker接收一个词或短语,在每台摄像头上找到所有匹配的内容,并跟踪它。
下文会频繁出现四个词:
| 词 | 在这里的含义 |
|---|---|
| 帧 | 视频中的一张图像 |
| 掩码 | 某一帧中某个对象的答案:一个与帧尺寸相同的 True/False 网格,属于该对象的每个像素上为 True |
| 提示 | 你如何说明要跟踪什么:围绕它的框、在它上面的一次点击、它的粗略掩码,或者,配合一个Tracker,一个词或短语 |
| 原版 | 模型自身的代码:Meta 的 EdgeTAM 仓库中的跟踪器,完全按原样使用 |
使用它
安装
pip install tamserve
你需要 Python 3.10 或更新版本,以及一块 NVIDIA GPU。它确实可以在 CPU 上运行,这便于试用,但对于实时视频来说太慢了。
第一次加载模型时,tamserve 会把它下载到~/.cache/tamserve,因此那次运行需要联网。EdgeTAM 为 54 MB。下载被固定到某一个版本,并在加载任何部分之前进行校验。
实时循环
tamserve 不打开摄像头,也不运行自己的循环。你的程序可以按自己喜欢的方式读取帧,并在每一轮调用engine.step()一次,传入每台摄像头的最新帧,完全按照解码器给出的样子。这个示例使用 OpenCV 读取两台网络摄像头:
import threading

import cv2  # pip install opencv-python;任何帧来源都可以
from tamserve import Box, Engine, build_video_predictor


class Camera:
    """在自己的线程上读取一路视频流,并保留其最新一帧。"""

    def __init__(self, url):
        self.stream, self.newest, self.arrived = cv2.VideoCapture(url), None, threading.Event()
        threading.Thread(target=self.read, daemon=True).start()

    def read(self):
        while True:
            ok, picture = self.stream.read()
            if not ok:
                break  # 视频流已结束
            self.newest = cv2.cvtColor(picture, cv2.COLOR_BGR2RGB)  # OpenCV 输出 BGR,引擎接收 RGB
            self.arrived.set()

    def take(self):
        """等待循环尚未见过的一帧,并将其返回。"""
        self.arrived.wait()
        self.arrived.clear()
        return self.newest


engine = Engine(build_video_predictor("cuda"))  # 将 EdgeTAM 加载到 GPU 上
cameras = {"door": Camera("rtsp://door-camera/stream"), "yard": Camera("rtsp://yard-camera/stream")}

# 要跟踪什么,以及它在第一帧中的位置:一个框,格式为 (left, top, right, bottom),单位为像素。
# 在真实系统中,这来自检测器,或者来自有人在画面上手动绘制。
start = {"door": {"courier": Box(410, 120, 560, 480)}}

while True:
    # 1. 从每个摄像头取最新一帧。
    frames = {name: camera.take() for name, camera in cameras.items()}

    # 2. 一次调用即可跟踪这些帧中每一个帧里的每一个对象。
    masks = engine.step(frames, start)
    start = None  # 这个框只需要一次;从这里开始,引擎会自行跟踪快递员

    # 3. 使用结果。masks["door"]["courier"] 在快递员的像素上为 True,在其他所有位置为 False。
    for camera_name, objects in masks.items():
        for object_name, mask in objects.items():
            print(camera_name, object_name, "covers", int(mask.sum()), "pixels")
每次调用step()都会为每个摄像头取一帧,并在这些帧的掩码就绪后返回。引擎会在调用之间记住它正在跟踪的内容,这就是为什么框只传一次。摄像头名称和对象名称由你自行选择。
帧完全按照解码器给出的样子传入。引擎会将它们上传并在 GPU 上调整大小,每帧大约耗时半毫秒,而在 CPU 上调整大小需要 16 毫秒。Cameraclass 也是为了速度而存在:每台摄像头一个线程,在 GPU 跟踪当前帧的同时解码下一轮的帧。而且因为每台摄像头只保留最新的一帧,落后的循环会跳过帧而不会滞后。引擎从它拿到的任意一帧开始跟踪,不需要看到每一帧。
这个循环能跑多快?在 RTX 4090 上使用编译后的引擎,八台 720p 摄像头、每台一个目标,像这样的循环从视频到掩码每秒跟踪 273 帧,即每台摄像头 34 帧。使用 1080p 摄像头时是 238 帧。
指向目标
要开始跟踪某个东西,你给它一个名字,并在当前帧中指向它。有三种指向方式。它们都使用该帧自身的像素坐标,x 从左边边缘算起,y 从顶部算起。
| prompt | 它是什么 |
|---|---|
Box(left, top, right, bottom) |
围绕目标的一个矩形。这是最可靠的方式,也是检测器给你的结果。 |
Clicks([(x, y), ...]) |
目标上的一个或多个点,比如来自鼠标。第二个由 1 和 0 组成的列表可以把每个点标记为目标上(1)或刻意不在目标上(0)。 |
| 一个掩码 | 一个与帧尺寸相同的 True/False 数组,如果你已经从别处得到了轮廓。 |
你可以做的四件事
开始跟踪某个东西。传入它的名字和它所在的位置,以及它所在的帧。你只做一次。已经在跟踪的一切都不受影响地继续。
engine.step(frames, {"yard": {"dog": Box(300, 380, 420, 470)}})
停止跟踪某个东西。
engine.drop("door", "courier")  # 只针对 courier
engine.drop("door")             # door 摄像头上的所有目标
修正一条出错的跟踪。偶尔轮廓会漂移。它会滑到错误的人身上,或者只保留目标的一半。用同一个名字再次指向该目标,就像你开始跟踪时那样。跟踪会从新的框重新开始,旧的、错误的历史会被丢弃。
engine.step(frames, {"door": {"courier": Box(455, 130, 600, 500)}}) # 同一个名字,新的框
开始跟踪你刚处理的那一帧中注意到的某个东西。 step()会把每个被跟踪的目标向前推进一帧。假设一个检测器查看了你刚传入的那一帧,发现了一只狗。调用step()再次传入同一帧会把其他所有目标向前推进两次。add()会在那一帧上启动这只狗,而不影响其余目标。
engine.add(frames, {"yard": {"dog": Box(300, 380, 420, 470)}}) # frames:你刚刚传给 step() 的那些
按照你命名的
以上所有内容都始于有人指向那个东西。一个Tracker则接收词语。给它一个短语,或者几个短语,它就会在每一路摄像头上找到每一个匹配项,跟踪每一个,在新目标出现时将其纳入,并在目标离开时将其释放。
从 tamserve import Engine, Tracker, build_video_predictor

engine = Engine(build_video_predictor("cuda", "sam2.1-large"), compile=True)
tracker = Tracker(engine, {"door": ["person", "package"], "yard": "dog"})  # 加载 SAM 3,即负责找到目标的模型

while True:
    frames = {name: camera.take() for name, camera in cameras.items()}  # 与上面的实时循环相同
    masks = tracker.step(frames)
    # masks["door"] 是 {1: mask, 2: mask, 3: mask}:在 door 摄像头上找到的每个目标各对应一个 mask
    # tracker.names("door") 是 {1: "person", 2: "person", 3: "package"}:即它们各自是什么
在每一路摄像头上使用相同的短语,Tracker(engine, "dog")就足够了。每个目标都会获得一个编号,在每路摄像头上从 1 开始计数,并在被跟踪期间一直保留该编号。
它的工作原理是配对两个模型。SAM 3 是 Meta 的模型,能勾勒出你命名的任何东西。它准确但慢:在 RTX 4090 上,看一帧大约需要 65 ms。引擎内部的模型无法自行找到任何东西,但它跟踪给定目标的成本要低得多,使用 EdgeTAM 时每帧只需几毫秒,使用 SAM 2.1 large 时只需几十毫秒。因此 SAM 3 每三帧对每路摄像头查看一次,引擎在中间跟踪它找到的目标,并且这些查看被分散开来,使它们永远不会全部落在同一轮中。
SAM 3 也能自行在视频中跟踪目标。以下是在一块 RTX 4090 上对两者进行的并排对比,使用的是 Meta 自家 SAM 3 基准测试中的 117 个视频,每个视频都配有诸如 "the white scarf" 之类的短语(共 224 对,其中没有任何一对被用于选择任何设置)。安防摄像头是第二组视频:
| SAM 3 自带的跟踪器 | Tracker |
|
|---|---|---|
| 准确率(HOTA) | 59.4 | 56.3,即前者的 95% |
| 每帧 GPU 时间 | 101 ms | 41 ms |
| 使用更小的模型 EdgeTAM 进行跟踪 | 54.6,耗时26 ms | |
| 每秒帧数,在有目标可跟踪时 | 8,一次一个视频 | 单路摄像头 15,或 16 路摄像头各 1;使用 EdgeTAM 时翻倍 |
| 对一路摄像头询问多个目标 | 每个目标完整跑一遍 | 一次查看全部:一路摄像头两个目标时每个 30 ms,八个目标时每个 17 ms |
| 不移动的安防摄像头,对每个摄像头提出五件事 | 每个 116 ms | 每个 13 ms,并still=True |
| GPU 显存 | 随视频增长 | 16 个摄像头为 6.8 GB,19 分钟后仍相同 |
HOTA 是跟踪的常用评分,范围为 0 到 100。它综合了目标被找到的程度与每个目标保持同一编号的程度。因此Tracker牺牲几个百分点的准确率,成本只有五分之二,使用 EdgeTAM 时则为四分之一。它还做到了 SAM 3 的跟踪器无法做到的三件事:同时运行多个摄像头,向一个摄像头询问多个目标而额外成本很小,并且其显存不随视频增长。结果包含完整表格。
| 如果你想要 | 这样做 |
|---|---|
| 更低的成本,换取一点准确率 | 接着使用 EdgeTAM,即引擎的默认模型:Engine(build_video_predictor("cuda"), compile=True) |
| 不移动的摄像头以降低成本 | Tracker(engine, prompts, still=True)。摄像头仅在其画面发生变化时才重新查看,并且在没有任何移动时不被跟踪。在安防摄像头视频上,这将成本削减了五分之二,并使答案变化约一个点。 |
| 更早发现新目标 | Tracker(engine, prompts, look_every=1)。它的成本约为两倍,且不会提高准确率。 |
| 让离开视野的目标保持其编号更长时间 | Tracker(engine, prompts, hold=900):目标在未被看到后仍被跟踪的帧数。默认值为 300。在该时间内看到的所有目标仍在被跟踪,因此在繁忙的摄像头上,较短的保持时间成本更低。 |
Tracker和PeopleTracker是附加组件。它们需要 Meta 的 SAM 3,除非你主动要求,否则 tamserve 不会附带它:
pip install "tamserve[sam3]"
hf auth login  #一次:SAM 3 的权重是受限的
在权重下载之前,请在 Hugging Face 上的facebook/sam3页面接受 Meta 的许可证。它们为 3.5 GB,会在跟踪器首次启动时获取。SAM 3 有自己的许可证,并非 Apache-2.0,因此在基于它构建之前请先阅读。
跟踪人物
人物是摄像头最常被询问的对象,因此它们有自己的跟踪器。一个PeopleTracker的作用与Tracker相同,但规则针对人物进行了调整:它的查看频率低五倍,并且比 SAM 3 自带的跟踪器更准确且成本低得多。
from tamserve import Engine, PeopleTracker, build_video_predictor

engine = Engine(build_video_predictor("cuda"), compile=True)
people = PeopleTracker(engine)  # 加载 SAM 3,即找到人物的模型

while True:
    frames = {name: camera.take() for name, camera in cameras.items()}  # 如同上面的实时循环
    masks = people.step(frames)
    # masks["door"] 是 {1: mask, 2: mask}:门禁摄像头上视野内的每个人各对应一个 mask
每个人都会分配一个编号,在每个摄像头上从 1 开始计数,并且只要被持续跟踪就一直保留该编号。某人短暂被遮挡——比如躲在门后或另一个人身后——再次出现时仍是同一个编号。
它把同样的两个模型配对使用。相对于画面尺寸,人的移动很慢,而且 SAM 3 对他们很有把握,所以每 15 帧看一次就够了;而最小的模型 EdgeTAM 每帧跟踪他们约需 4 ms。
SAM 3 也能自己通过视频跟踪人物。下面是在一块 RTX 4090 上、用相同视频做的并排对比:
| SAM 3 自带的跟踪器 | PeopleTracker |
|
|---|---|---|
| 家庭场景,116 个视频:准确率(HOTA) | 87.8 | 89.6 |
| 每帧 GPU 时间 | 126 ms | 8.9 ms |
| 同时处理的摄像头数 | 一次一个视频 | 16 路各 5 帧/秒,或 64 路各 1.4 帧/秒 |
| 处理 3,000 帧视频期间的 GPU 显存 | 在第 423 帧时显存耗尽 | 从开始到结束始终为 3.5 GB |
| 拥挤街道:准确率(HOTA) | 77.7 | 78.3每帧都看时为 72.6,使用默认设置时 |
| 每帧 GPU 时间 | 521 ms | 183 ms,使用默认设置时为 44 ms |
结果有完整的表格。
| 如果你想要 | 这样做 |
|---|---|
| 人群中的人更早被发现、换号更少 | PeopleTracker(engine, look_every=1)。SAM 3 随后会看每一帧,代价更高。默认值 15 适合人少的房间。 |
| 让离开视野的人保留编号更久 | PeopleTracker(engine, hold=90):一个人未被看到后仍被跟踪的帧数。默认是 30。 |
| 用你自己的检测器替代 SAM 3 | PeopleTracker(engine, finder=my_detector):任何接受一组帧、并为每帧返回一组 mask 的东西 |
选项
| 如果你想要 | 这样做 |
|---|---|
| 换一个模型 | build_video_predictor("cuda", "sam2.1-tiny")。同样适用于-small、-base-plus和-large。 |
| mask 留在 GPU 上而不复制到 CPU | Engine(predictor, gpu_masks=True) |
| mask 与原生实现逐位完全相同 | Engine(predictor, exact=True),并让每一帧先经过prepare(frame):它在 CPU 上完全按原生方式缩放,而引擎自己在 GPU 上的缩放可能在某个像素值上偏差 1 |
为速度而编译
Engine(predictor, compile=True)为你的 GPU 编译模型。本页所有速度数据都使用了它,代价是首次启动较慢。
compile= |
在机器上的首次启动 | 后续启动 | 速度 |
|---|---|---|---|
True |
约 20 分钟 | 约 95 秒 | 最快 |
"default" |
不到 3 分钟 | 约一分钟 | 从 4 路摄像头起慢 3% 到 8%,两路时慢 20%,一路时只有一半速度 |
| 关闭 | 2 秒 | 2 秒 | 一路摄像头时 55 帧/秒,四路起约 200 帧/秒 |
后续启动很快,因为 PyTorch 会把编译后的代码保存在磁盘上。默认情况下它保存在/tmp,所以请把TORCHINDUCTOR_CACHE_DIR指向一个重启后仍然存在的文件夹。编译仅在 Linux 上测试过。
多块 GPU
一个引擎驱动一块 GPU。若要在单机或多机上使用多块 GPU,请使用Router。它在每块 GPU 上运行一个 worker,把每个摄像头分配到剩余空间最大的那块 GPU 上,并在一处汇总所有摄像头的结果。每个 worker 自行打开并解码自己的摄像头,因此视频从不在它们之间传输。
从 tamserve 导入 Box, Router


def main():
    router = Router(compile=True)  # 在本机每块 GPU 上各启动一个 worker
    router.add_camera("dock-1", "rtsp://10.1.0.21/stream")
    router.add_camera("dock-2", "rtsp://10.1.0.22/stream")
    router.start("dock-1", "forklift", Box(410, 120, 560, 480))

    for update in router.results():  # 所有摄像头,无论由哪块 GPU 跟踪
        for name, mask in update.masks.items():
            print(update.camera, update.frame, name, mask.box, mask.area)


if __name__ == "__main__":  # 每个 worker 都是一个新的 Python 进程,它在启动时会导入此文件
    main()
路由器自行读取摄像头,因此你提供的是每个摄像头的地址,而不是把帧交给它。按地址打开视频流需要 OpenCV(pip install opencv-python-headless)。start()、stop()和remove_camera()的用法与在引擎上相同。
在两块 RTX 4090 上,每个摄像头一个对象时,一个路由器从 32 路 720p 视频中每秒跟踪 476 帧,而单块 GPU 上为 241 帧。当摄像头掉线或某个 worker 停止时,路由器仍能继续运行,且其 worker 可以位于其他机器上:多块 GPU涵盖这两种情况。
工作原理
对于每一帧,一个 SAM 2 风格的跟踪器会编码图像,在其近期帧记忆中查找该对象,绘制掩码,并把该帧写入该记忆。tamserve 在每一步对每个摄像头上的每个对象运行同样的这四个模块。
flowchart LR
    A[Newest frame from<br>each camera] --> B[Image encoder<br>frames batched]
    B --> C[Memory attention<br>one row per object]
    M[(Per-object memory<br>prompt frame, 6 frames,<br>15 summaries)] --> C
    C --> D[Mask decoder]
    D --> E[Masks out]
    D --> F[Memory encoder]
    F --> M
有五点让它变快。它们都不改变模型计算的内容;至多改变浮点舍入。
- 每个对象都是同一个批次中的一行。这就是连续批处理,正如 LLM 服务器所做的那样:每个有新帧的对象共享一次模型前向计算。
- 一个对象只保留模型会读取的记忆。即它被提示的那一帧、最近 6 帧以及最近 15 帧的简短摘要,无论摄像头已运行多久。
- CPU 从不在一个步骤内等待。GPU 通过 CPU 填充的队列来工作,某些操作会让 CPU 停下来直到队列为空。每步十二次这样的等待变成了一次。
- 一个位置编码,而不是每帧一个。这让一步快了 4% 到 7%,并在 64 路摄像头下把 GPU 内存几乎减半。
- 为不断变化大小的批次编译代码。引擎把每个批次切成 2 的幂大小的块,并预先编译全部五种大小,因此运行中不会有任何编译。
完整说明在docs/how-it-works.md。每项改动带来了什么,以及尝试过又放弃了什么,都在docs/results.md。
结果
下面的表格在Why tamserve是简短版本,关于命名事物和人的部分各有自己的说明。每一项测量,连同运行它的机器和复现它的命令,都在docs/results.md:从 1 到 64 路摄像头的速度、全部五个模型的准确率、内存、SAM 2.1 对比 Meta 当前代码、实时视频、两块 GPU,以及两个跟踪器对比 SAM 3 自带的跟踪器。
限制
tamserve 不做的事:
- 向后跟踪。它只在时间上向前推进,而这正是实时摄像头所需要的。Stock 也可以在录制的片段中从提示向后运行。
- 在不重启的情况下调整掩码。修正跟踪意味着再次指向该对象,跟踪从那里重新开始。Stock 也可以用额外一次点击微调掩码,或在多帧上接受提示。
- 在没有 SAM 3 的情况下自行寻找目标。引擎跟随它所指向的目标,当对象离开视野时,它的掩码返回为空。按名称寻找目标是
Tracker和PeopleTracker的工作,两者都需要安装 SAM 3。 - 在所有方面都达到 SAM 3 的准确率。在人上,
PeopleTracker的得分高于 SAM 3 自带的跟踪器。在其他对象上,Tracker达到其得分的 95%。 - 通过增加摄像头来降低单次查看的成本。以下内容跨摄像头批处理,而查看则不是。因此使用
Tracker一块 RTX 4090 用 EdgeTAM 总共每秒跟踪约 30 帧,用 SAM 2.1 large 为 16 帧,无论多少摄像头共享它们:用 EdgeTAM 是六路摄像头各每秒 5 帧,或用 SAM 2.1 large 是三路。look_every和still是扩展它的方法。 - 跨摄像头或在长时间缺席后识别同一对象。两个跟踪器都在每路摄像头上分别给对象编号,而某物消失超过
hold帧会以新的编号返回。它们运行在一个引擎上,因此只用一块 GPU:它们不通过Router目前还不行。 - 在拥挤的人群中跟踪每一个人。每帧有 90 人时,
PeopleTracker能跟踪到视野中可见者的 72%。PeopleTracker(engine, start=0.5)将这一数字提升到 84%,并且交换编号的频率几乎翻倍。
实际使用中会怎样:
- 目标越多,开销越大。本页的速度是每个摄像头一个目标时的数据,每多一个目标,每轮大约增加 2.4 ms。
- 首次编译启动大约需要 20 分钟。之后大约需要 95 秒,前提是 PyTorch 的编译代码缓存仍然存在。
compile="default"不到 3 分钟即可就绪。 - 其他 GPU 会给出不同的数字。tamserve 可在 PyTorch 支持的任何 NVIDIA GPU 上运行,并在这些 GPU 上给出相同的掩码,但本页的所有速度数据都来自一块 RTX 4090。不支持 bf16(模型运行所用的数字格式)硬件加速的老旧 GPU,其速度远低于按年代所预期的水平:在 Colab 免费提供的 T4 上,SAM 3 的一次检测需要 3 秒。
了解更多
| 涵盖内容 | |
|---|---|
| 工作原理 | 模型、连续批处理、每一处速度变化及其为何精确、代码在哪里 |
| 结果 | 每一项测量及其命令、启动时间、各阶段性能分析、尝试过又放弃的方案 |
| 多 GPU | 路由器返回什么、摄像头或工作进程故障时会发生什么、其他机器上的工作进程 |
| 演示视频 | 每个场景展示什么、如何录制、素材来源 |
致谢与许可
tamserve 采用 Apache-2.0 许可。它运行EdgeTAM和SAM 2.1(均由 Meta 开发,均为 Apache-2.0 许可),它会下载这些模型但不重新分发。准确率在DAVIS 2017上测量,该数据集仅供研究使用;用于其他用途前请先查看其许可。Tracker和PeopleTracker调用 Meta 的SAM 3,它有自己的许可,不属于 tamserve 的一部分,仅在你主动请求时才会安装和下载。它们的评分基于SA-Co/VEval、BURST、MOTS20 和 MOT20以及MEVA(CC BY 4.0),各自遵循其自身条款。演示视频的素材来自Pexels,遵循 Pexels 许可;来源列于docs/demo.md。