本文通过介绍 RoPE 等经典与当代方法,解释 LLM 如何编码和处理 token 位置信息。这本质上是一段全面的旅程,我们将借助可视化示例、少量数学推导和一个小的 PyTorch 实现来梳理这些机制。当然,之后我们还会看看现代架构如何调整或省略显式的位置编码。
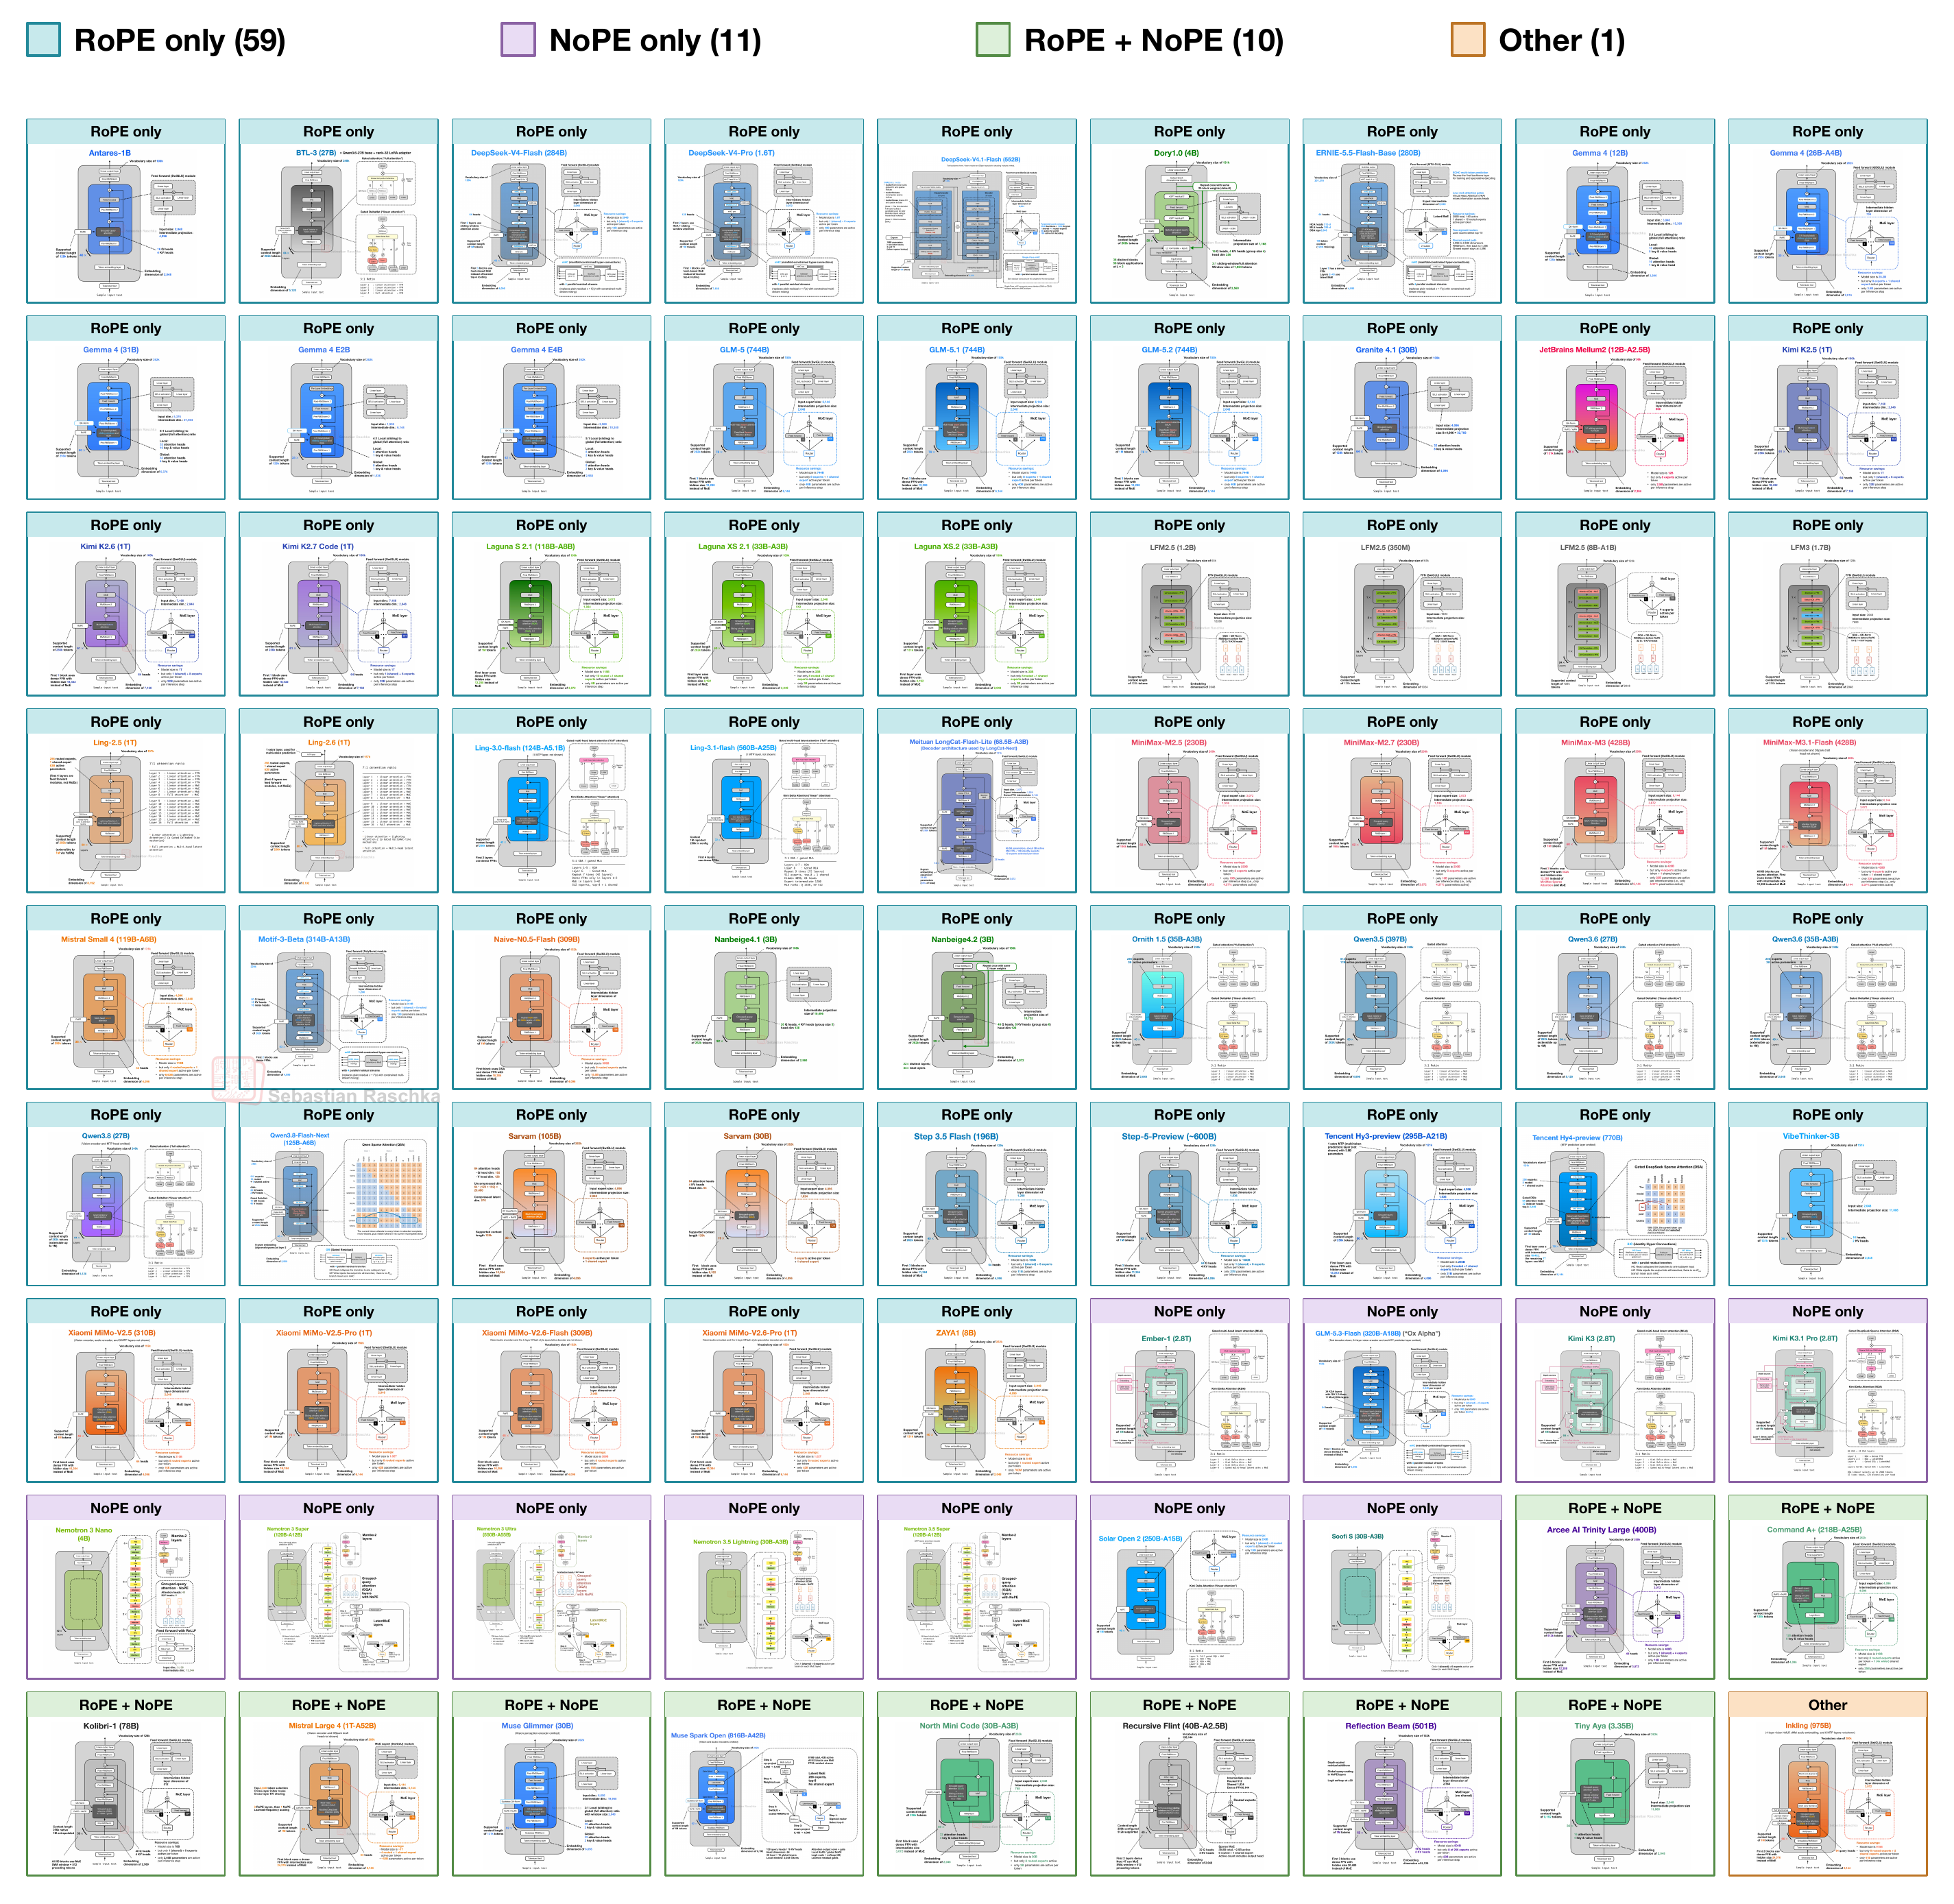
下面你可以看到 2026 年开源权重模型采用了哪些位置嵌入选择的预览。我们会在介绍完底层机制之后再讨论这些选择。
但为什么要花这么多时间撰写/阅读这个相对次要的构建模块呢?LLM 一直在演进,而当我准备今年一篇关于最新 LLM 架构趋势的新文章时,我意识到自己此前从未在任何文章中介绍过 LLM 所使用的位置信息方法。因此,与其让另一篇文章变得臃肿失控,我想不如把它作为一篇独立的构建模块文章发布,为即将到来的 LLM 架构与趋势分析做铺垫。
另外,这些年来,许多读者一直希望我写一篇关于相对位置嵌入(即 RoPE)的教程,作为对 GPT 中所用可学习绝对嵌入的后续。这件事在我的待办清单上已经很久了,所以我终于重新翻出旧草稿,整理出了这篇讲解,内容将涵盖
LLM 中不同的位置方法;
(终于)RoPE 是如何工作的;
近期开源 LLM 使用了哪些方法。
请注意,本文假定读者对基础 LLM 架构有一定了解,很适合作为以下内容的后续阅读:《从零构建大语言模型》。如果对注意力内部机制的概念和计算,尤其是 query、key 和 value 向量,还有些模糊,我建议回顾一下我的自注意力讲解作为复习:

本文技术性也很强,对一些人来说可能过于详细。不过,我确实很想把这一基础内容发布出来,供未来的文章引用。别担心,下一篇会回到更轻松的風格。
PS:我开始尝试 Substack 新的“perks”系统。作为对支持者的感谢,我添加了图像导出和元数据来自架构图库,供你在自己的分析中使用。
PPS:如果你已经熟悉位置嵌入的工作原理,可以直接跳到第 6 节,现代架构中的位置选择。
请注意,这篇文章在网页浏览器中阅读可能比在邮件客户端中更好。我建议查看网页版,它的左侧还有一个导航栏。
让我们从整体架构开始。分词器将输入文本编码为 token ID。接下来,LLM 的输入 token 嵌入层将每个 ID 映射为一个数字向量。我们通常将该向量中的这些条目称为“特征”(类似于经典 ML)。然后,LLM 内部的 transformer 块使用注意力和前馈层修改这些向量。最后,模型的输出层为下一个 token 生成 logit 分数(转换为概率)。
下图展示了这一路径在 GPT-2(一个相对经典的 LLM)和 MiniMax-M3(今年发布的一个较新的 LLM;作为大多数其他近期 LLM 的占位符)中的情况。正如我们所见,这些架构彼此差别不大,但在进入位置信息部分之前,让我们先关注橙色块(token 嵌入层)及其上方的 transformer 块;其他架构差异对于本解释并不需要。
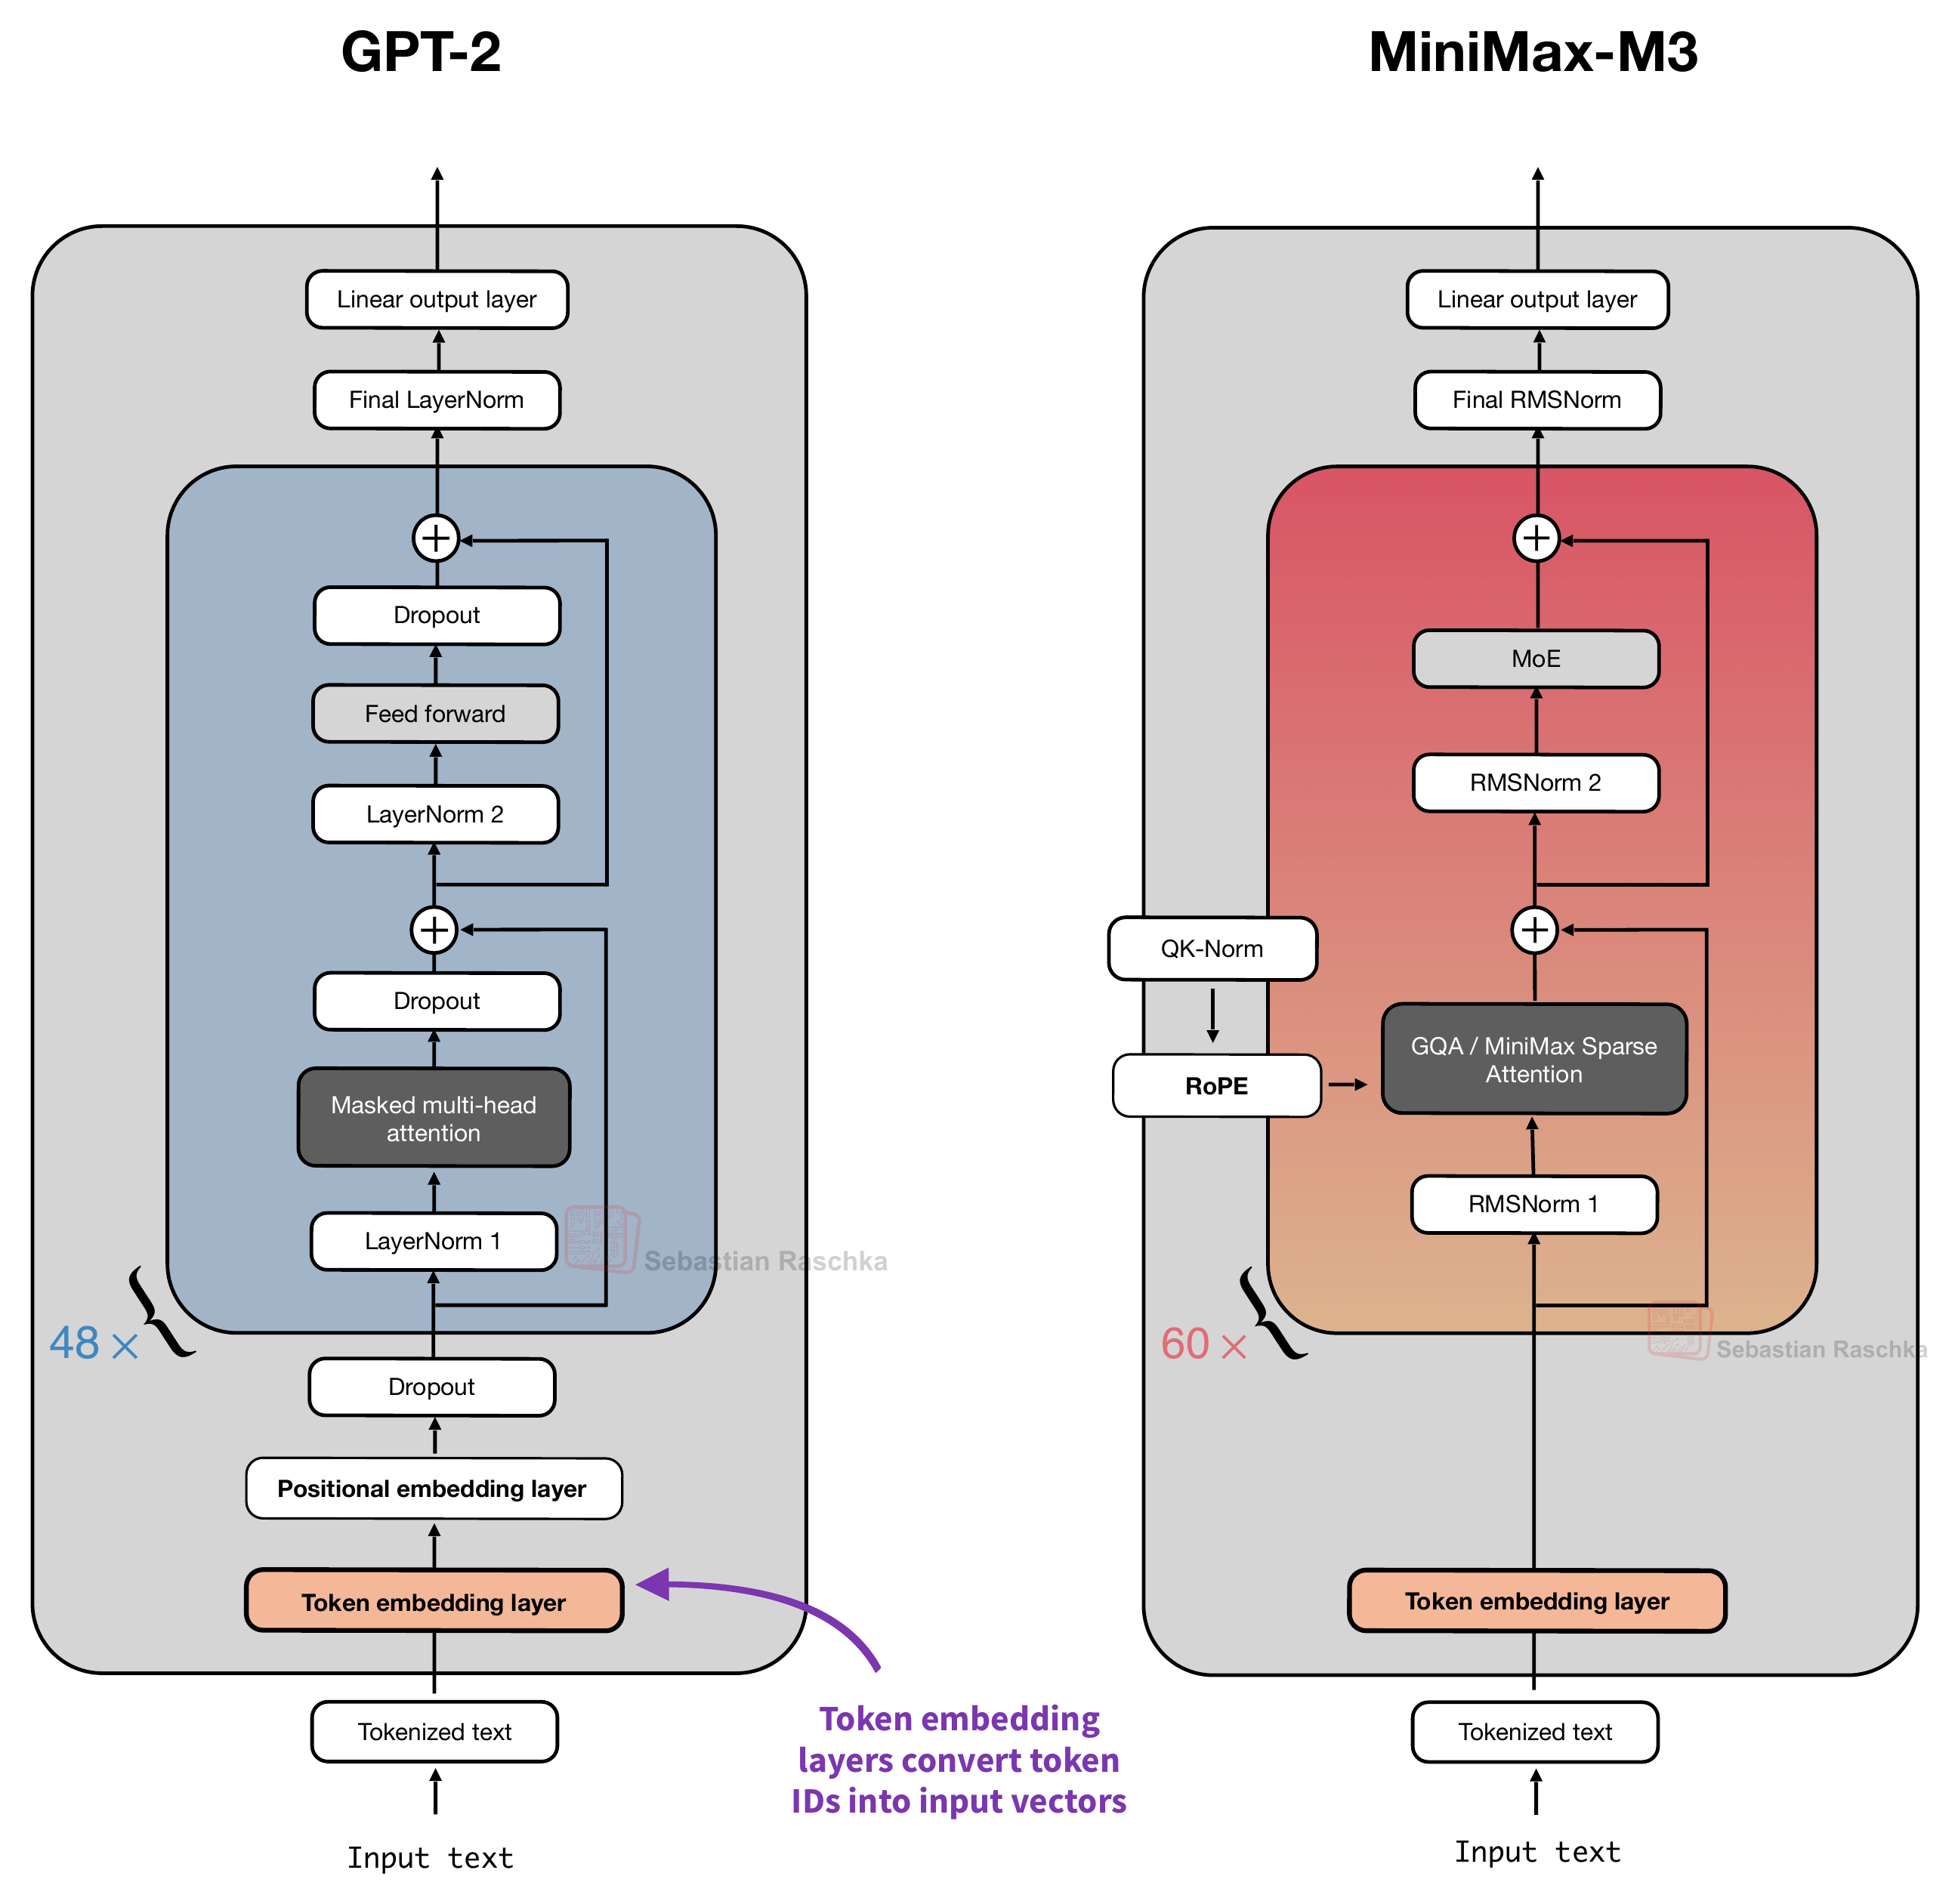
如上图所示,token 嵌入层将每个 token ID 映射为一个向量。随后再添加位置信息。具体来说,正如我们稍后将更详细讨论的,GPT-2 在修改后的嵌入进入第一个 transformer 块之前,为每个 token 嵌入添加一个位置向量。另一方面,MiniMax-M3 在注意力内部使用一种称为 RoPE 的方法,在每个 transformer 块中添加位置信息。
我们稍后会详细讨论这些方法,但首先,让我们从整体图景开始,解释为什么需要或添加显式的位置信息。
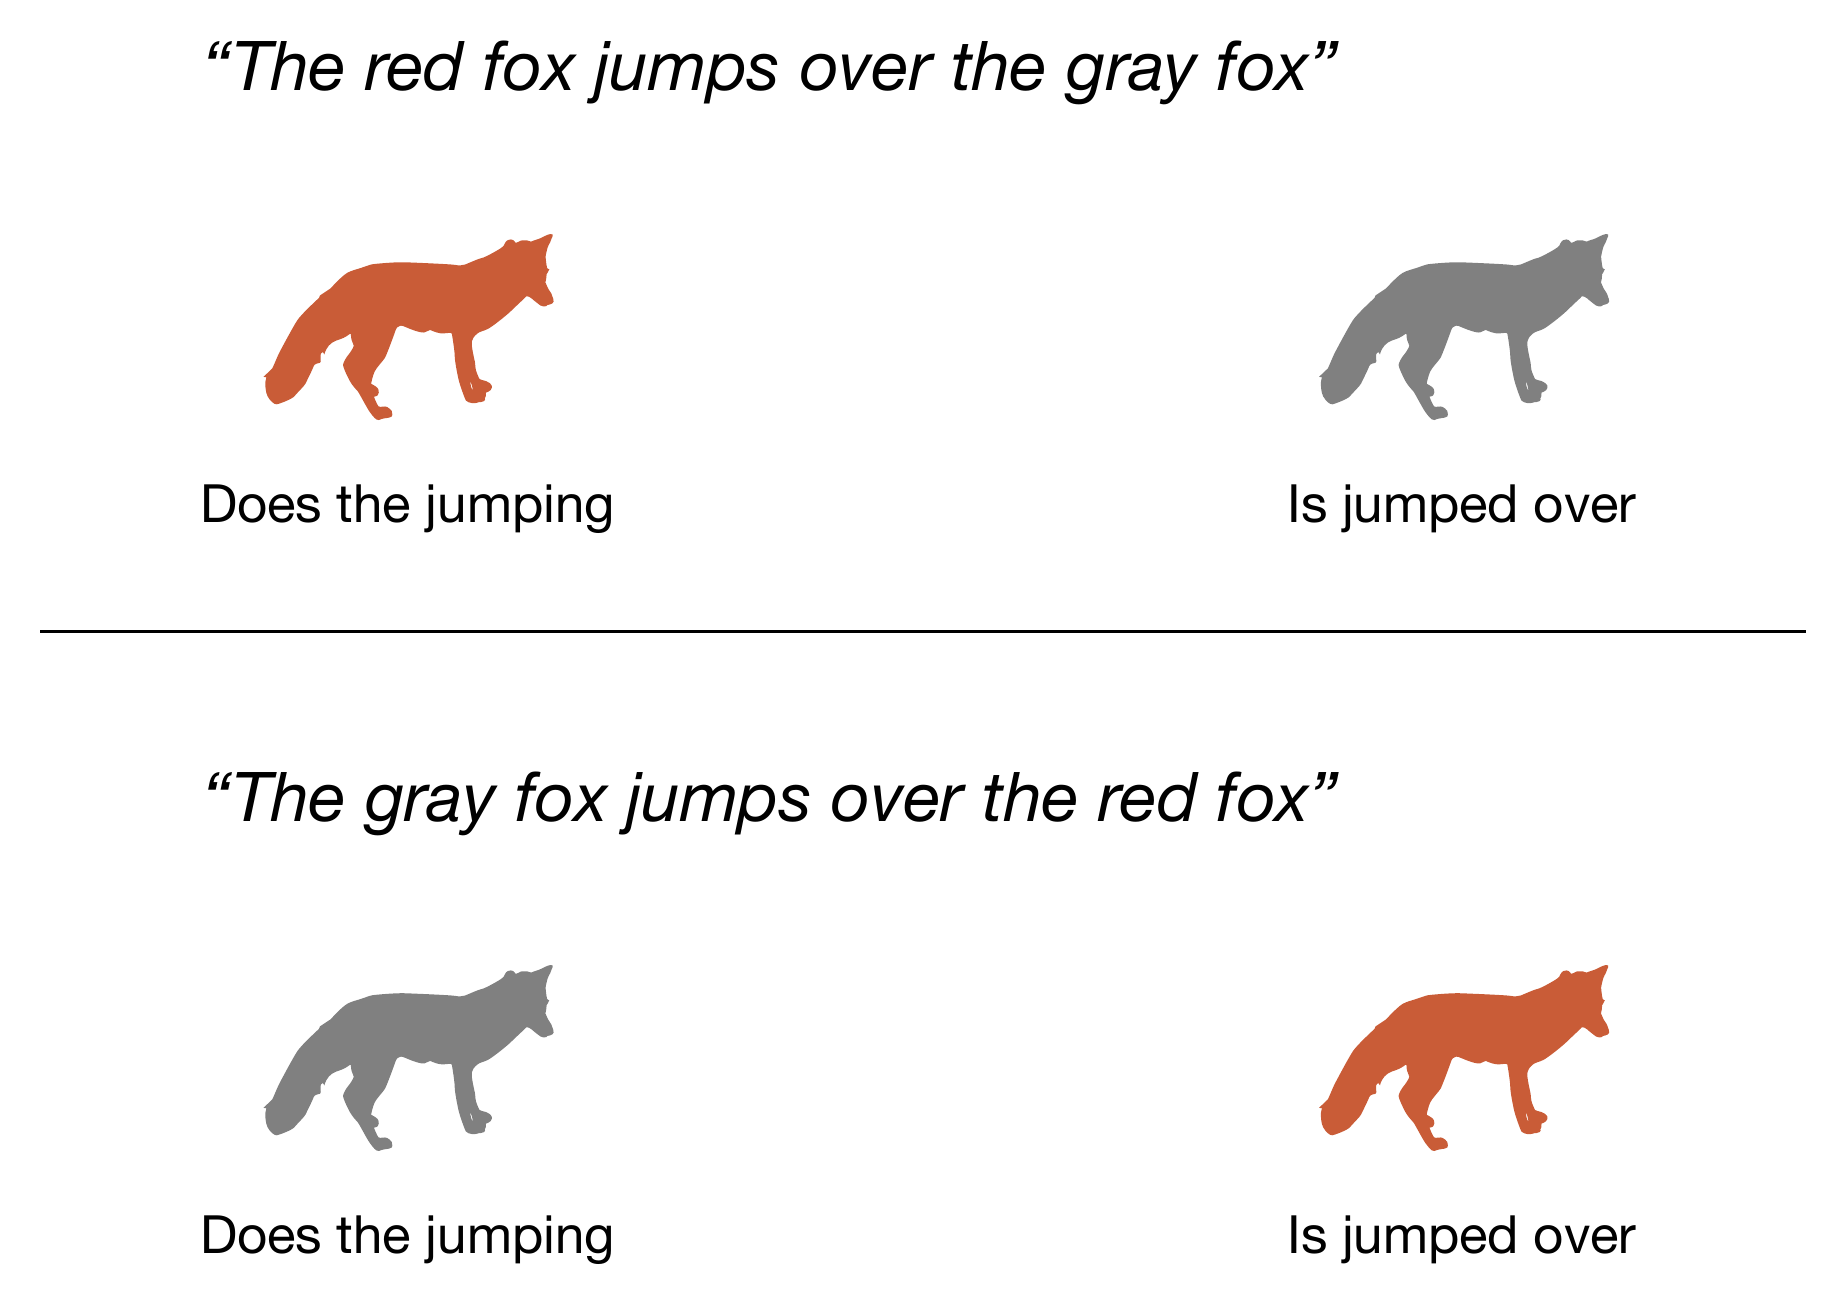
考虑以下两个输入句子作为简单示例:
“The red fox jumps over the gray fox.”
“The gray fox jumps over the red fox.”
改变词序会改变哪只狐狸在跳跃,如下图所示。
对于本文中的示例,为简单起见,我们将每个单词视为一个 token。(如你所知,真实的分词器可以将单词拆分为更小的子词 token。)那么第一个句子有八个 token 位置,从 0 到 7。

(如果你对词汇表如何构建感兴趣,可以查看我的GitHub 上的分词器资料。)
注意,“fox”在输入句子中出现两次,在两种情况下都获得相同的 token ID 2。并且由于它们具有相同的 token ID,无论其在输入句子中的位置如何,它们都会从嵌入层获得相同的嵌入向量。
现在,让我们考虑一个没有位置编码(也没有因果掩码)的常规自注意力机制,其中每个输入 token 都可以关注输入中的其他所有 token。在这种情况下,交换任意两个单词,比如“red”和“gray”,仍然会导致每个 token 对之间产生相同的嵌入和注意力分数。
GPT 风格的模型确实使用因果(自回归)掩码,这将每个 token 限制为只能关注自身和更早的 token。有趣的是,这种因果掩码为计算提供了一些隐式的顺序信息。在我们的示例中,“jumps”在第一个句子中可以关注“red”,在第二个句子中可以关注“gray”。因此,因果 LLM 理论上即使没有显式的位置嵌入也能区分这些句子。(我们稍后在讨论“NoPE”概念时会回到这个想法。)
尽管如此,GPT-2 和大多数较新的 LLM 都包含显式位置信息,因为它为注意力提供了关于位置的直接信号。这是因为,尽管因果掩码决定了哪些 token 可被访问并提供了隐式顺序信息,但它无法区分一个位置的间隔与十个位置的间隔。因此,显式位置方法仍然有用(甚至必不可少),因为它们提供了这一信息。
如果这一切听起来令人困惑,别担心,它更多是作为一个概述,我们将在剩余的文章中更缓慢地逐步讲解这些概念。
我们简要讨论了隐式通过因果注意力掩码获得的位置信息(我们稍后会再次更详细地讨论这一点)。然而,我们现在转换话题,来谈谈显式添加位置信息的方式。
也许最简单、最直接(但并非“最廉价”)的方法是给每个序列位置分配一个自己的向量。我们将该向量加到 token 嵌入上,因此得到的、修改后的嵌入向量随后被传入第一个 transformer 块。这一具体过程将在以下小节中讨论。
为了说明将显式的、学习到的位置向量用于输入嵌入,让我们以 GPT-2 作为具体例子。GPT-2 在训练期间学习一个位置向量表。下图展示了这些向量在架构中的使用位置,即紧接在 token 嵌入查找之后、第一个 transformer 块之前。
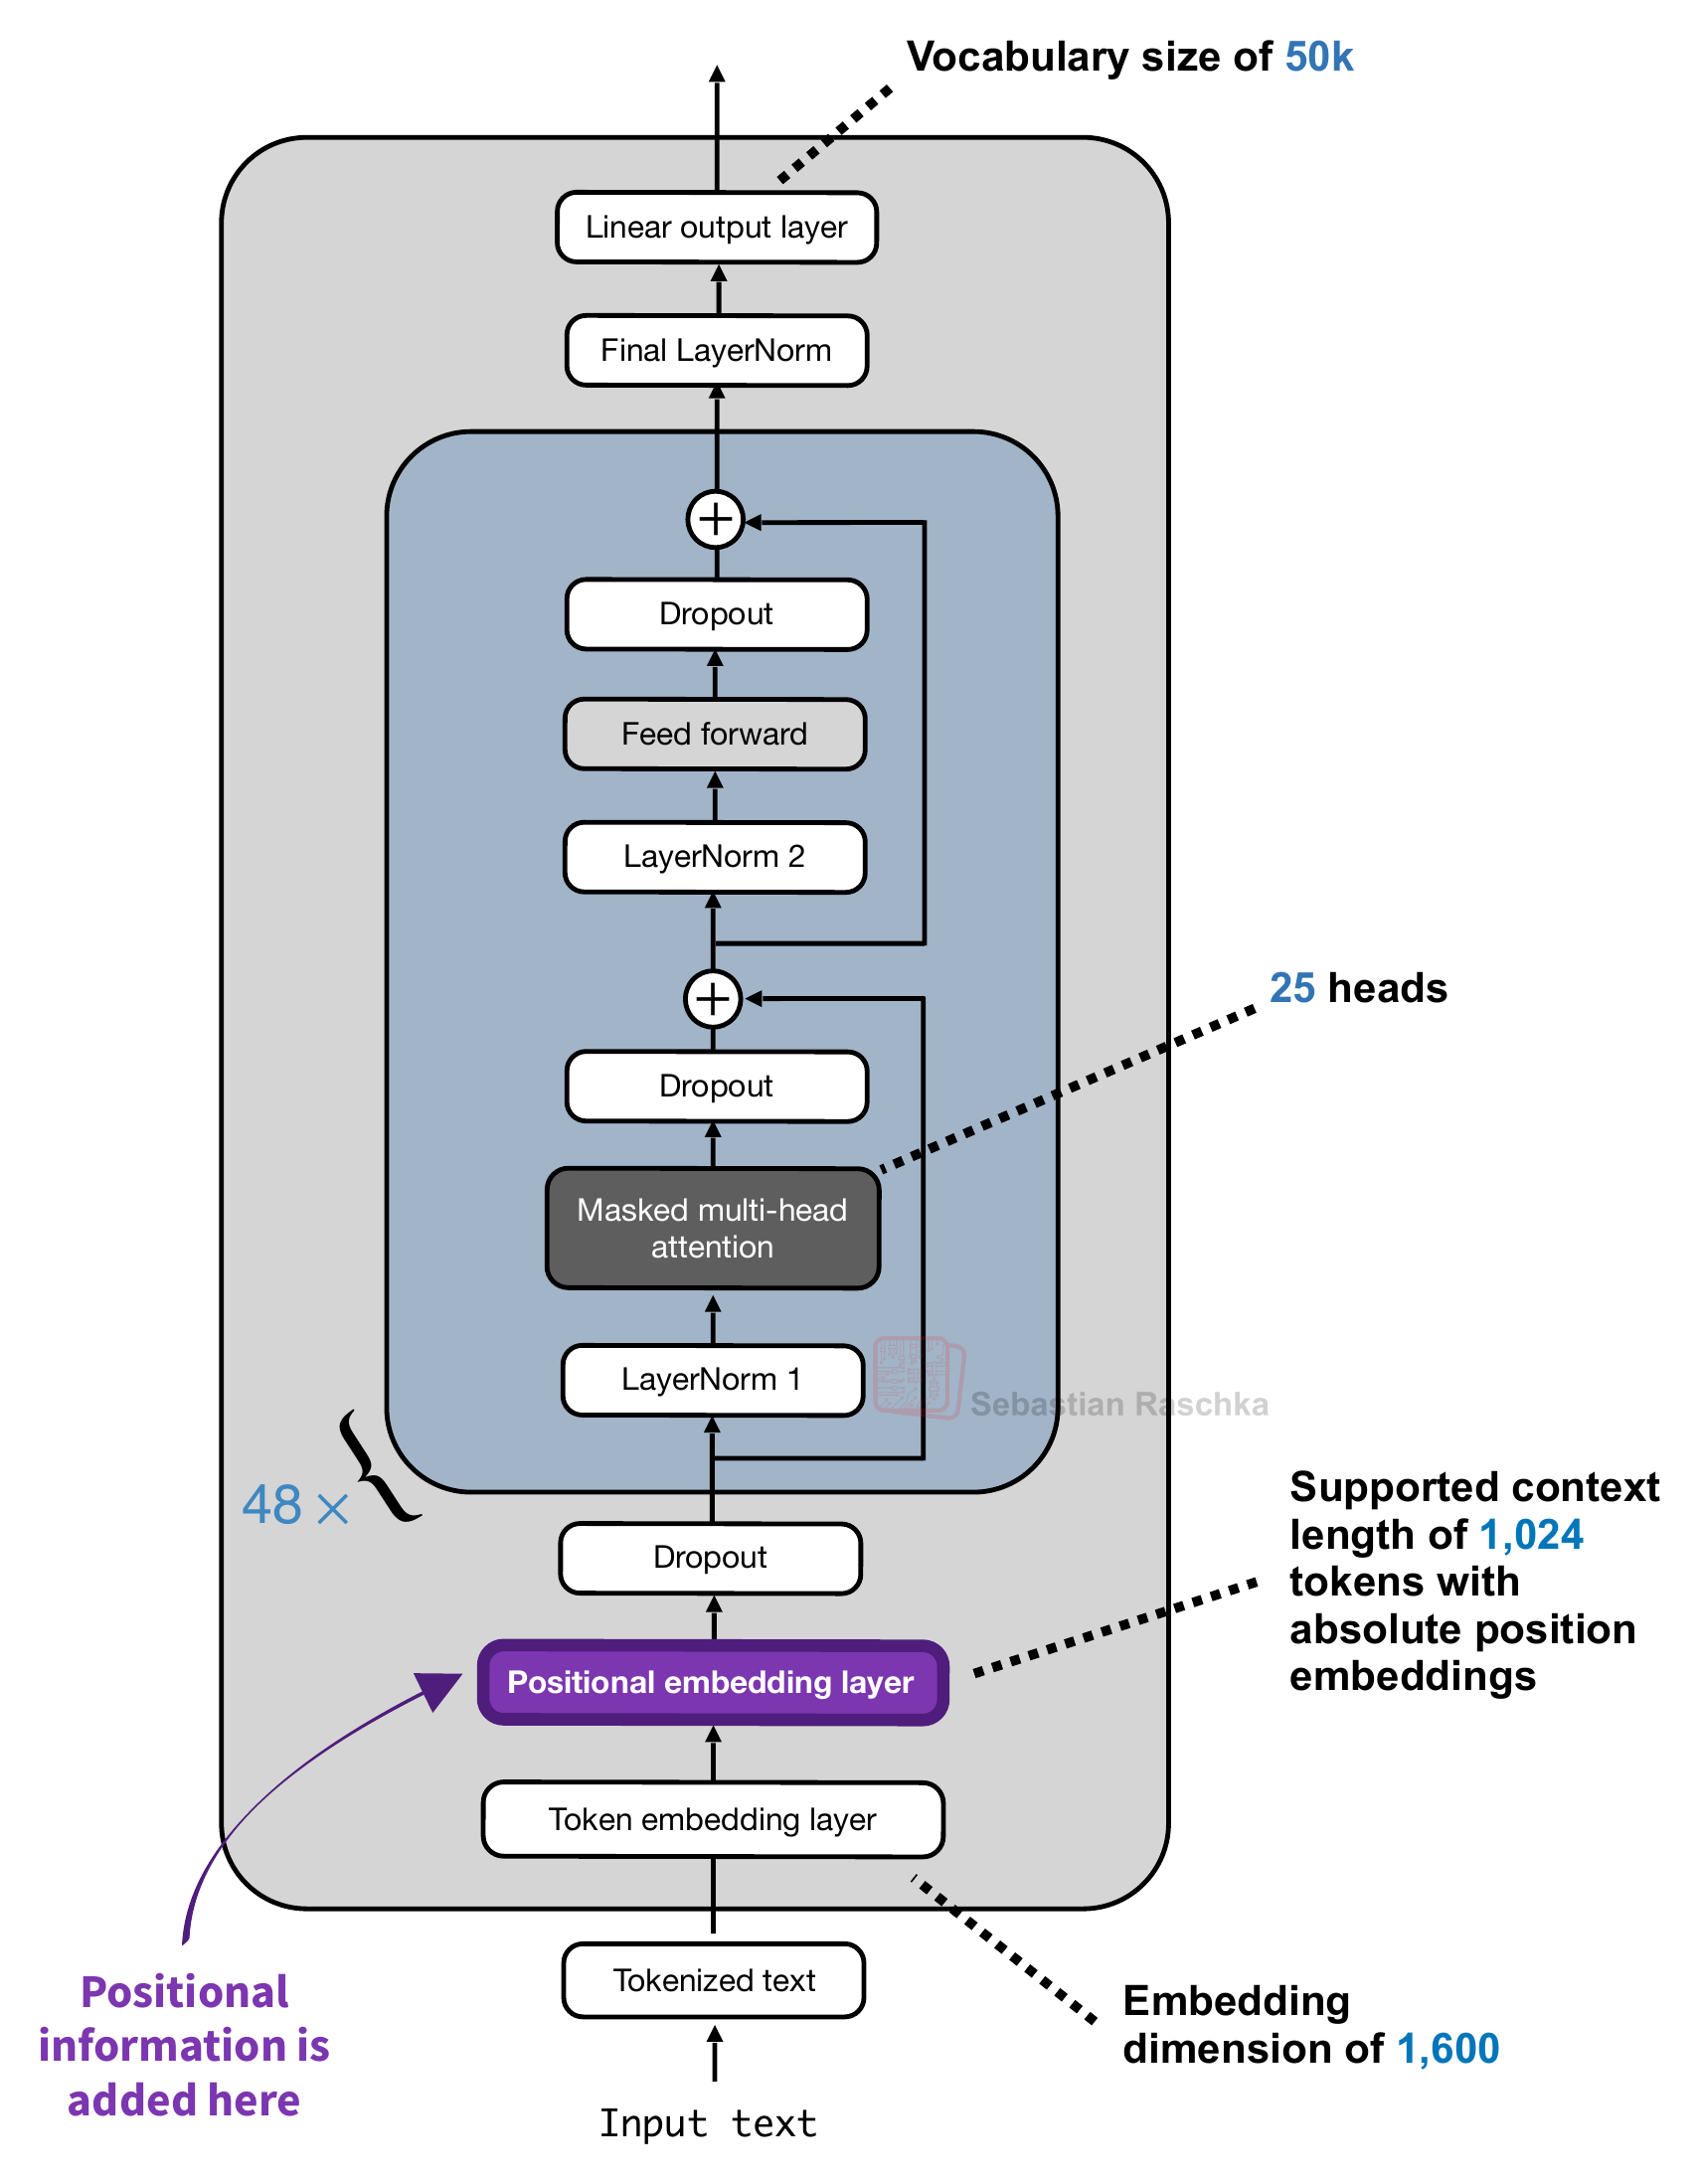
上图中描绘的位置嵌入层遵循与 token 嵌入层相同的实现,即它们具有完全相同的输出维度,以便得到的输入向量可以相互相加。下面的代码通过一段 GPT-2 代码实现展示了这一点:
用数学术语来说,我们可以将其写如下。令m为位置索引,xm为该位置上的 token ID。第一个块的输入是

这里,
Etoken是嵌入层,
Pm是由以下方式选择的位置信息向量m,
和hm是求和得到的嵌入向量与位置向量。
这两个向量宽度相同,因此我们逐元素相加它们的条目。下面的图 6 用一个小型数值示例直观地展示了这一点。
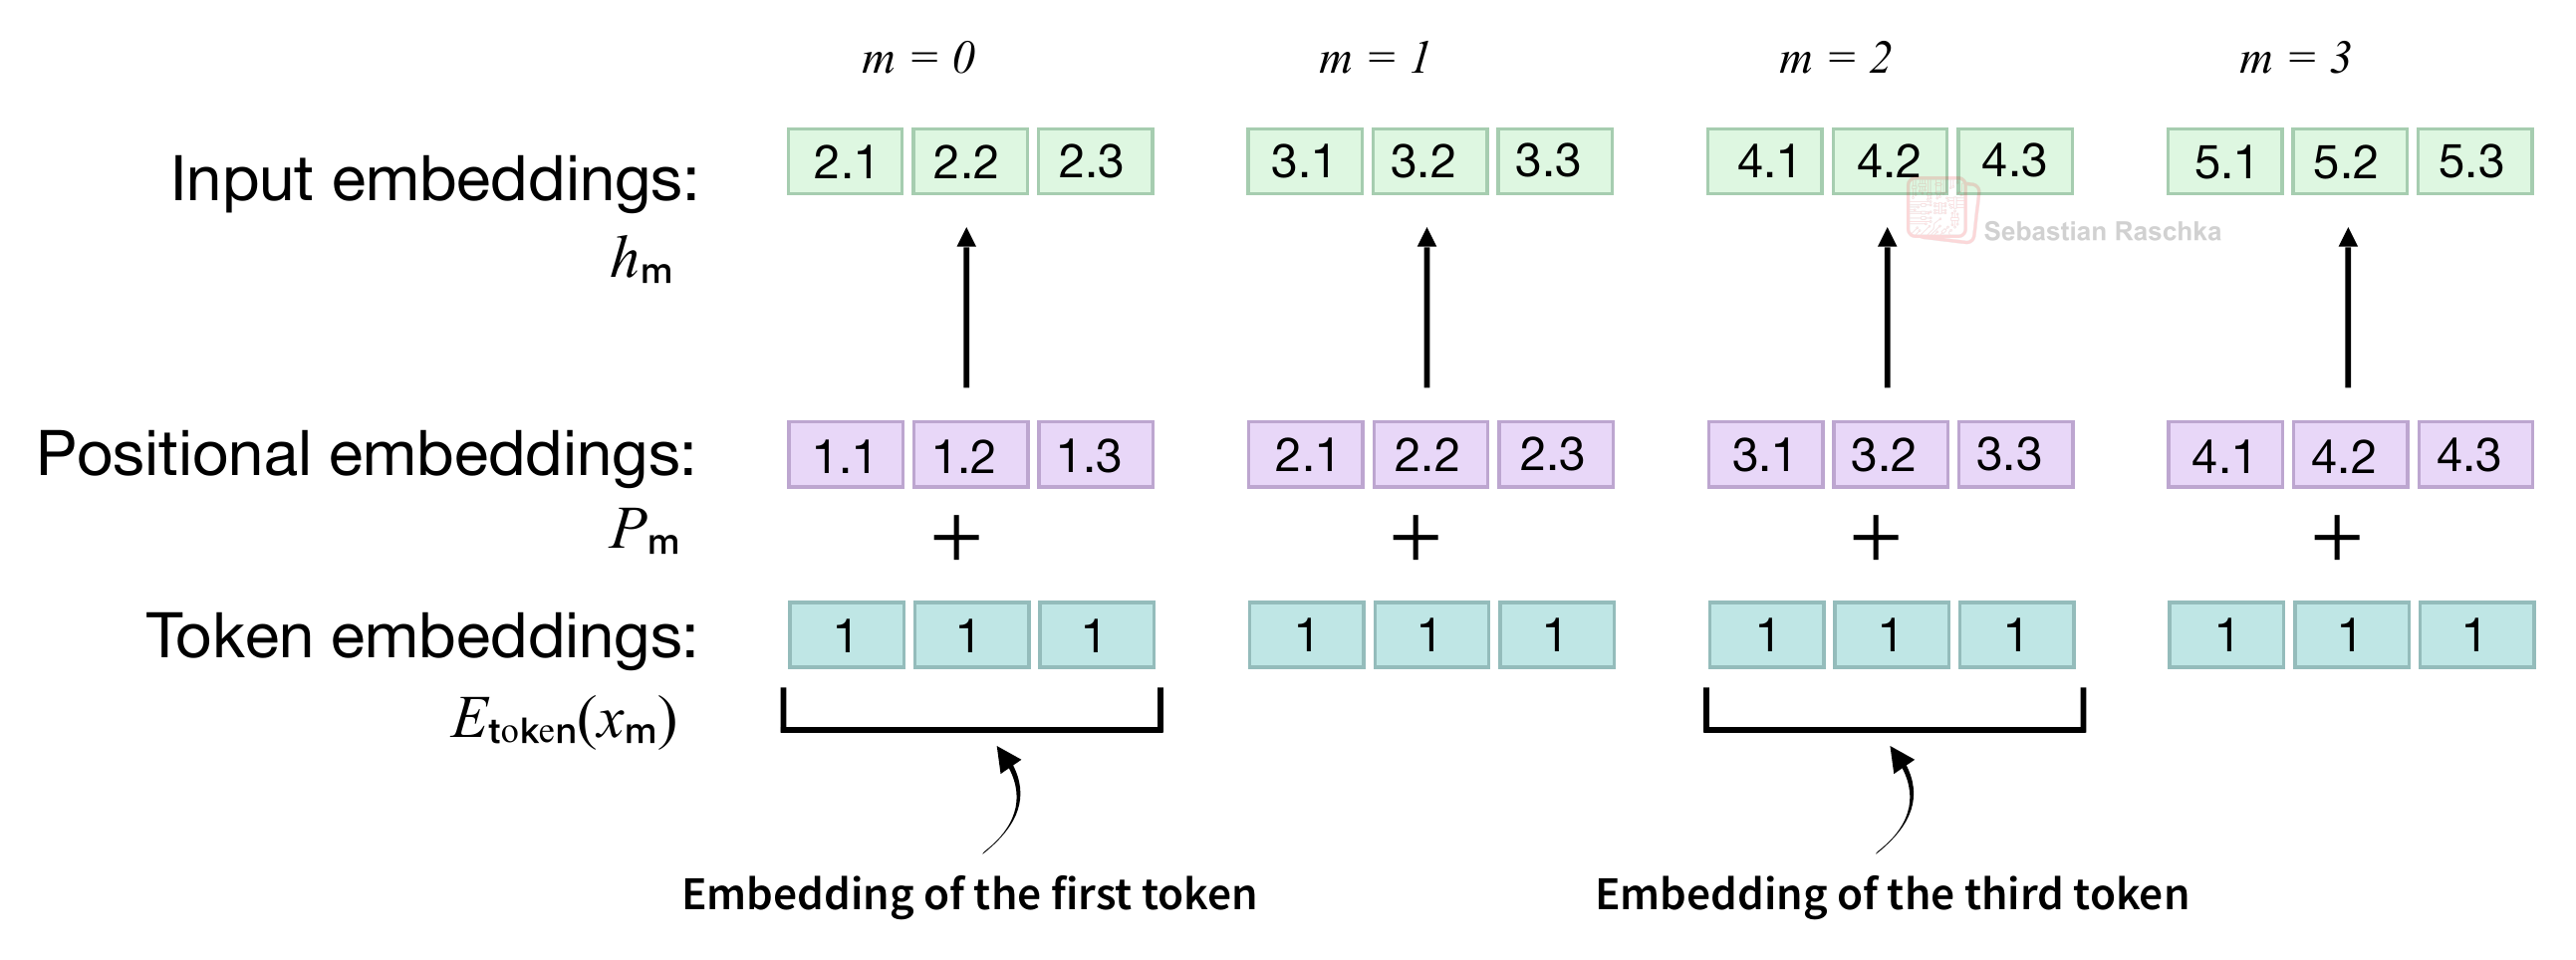
在上图中,在位置 0 处,将词元嵌入[1, 1, 1]加到位置嵌入[1.1, 1.2, 1.3]得到[2.1, 2.2, 2.3]。顺便说一下,图中的数值是为了简化图示而选取的;在真实示例中,两个嵌入层(表)都用小的随机值初始化,并在训练过程中学习。
所以,我们在本节中介绍的是所谓的绝对位置方法,因为位置嵌入Pm取决于词元自身的位置m。在前面的示例句子中,两个“fox”词元最初具有相同的词元嵌入,但由于我们加上了不同的位置向量P2和P7,它们在进入第一个 transformer 块之前就具有了不同的值。因此,注意力机制内部的查询、键和值向量随后也会接收到已经包含位置信息的表示。
请注意,原始的GPT-2 实现有 1,024 个学习到的位置向量。这意味着它只能处理 1024 个或更少词元的输入。如果我们想扩展上下文窗口,就必须扩展这个嵌入表。而且由于嵌入表(层)在训练期间像其他任何层一样被更新,上下文长度必须在训练开始之前就确定下来。
扩展上下文会非常昂贵,因为表可能变得非常大。例如,在 GPT-2 Medium 的情况下,在 1,024 个位置时,位置嵌入层的权重仅占总权重的 0.30%。然而,如果我们将上下文长度增加到如今常见的 100k 范围,它们将占模型总权重的 >22%,这将非常不经济。
原始的“Attention Is All You Need”2017 年的 transformer 早于 GPT,它使用相同的加法机制,但用固定的正弦和余弦函数来计算位置向量。下面的图 7 展示了在编码器和解码器堆叠之前进行的这一加法。编码器处理输入序列,解码器生成输出序列。(这里引入它的原因是,正弦和余弦函数在之后讨论 RoPE 时会再次变得相关。)
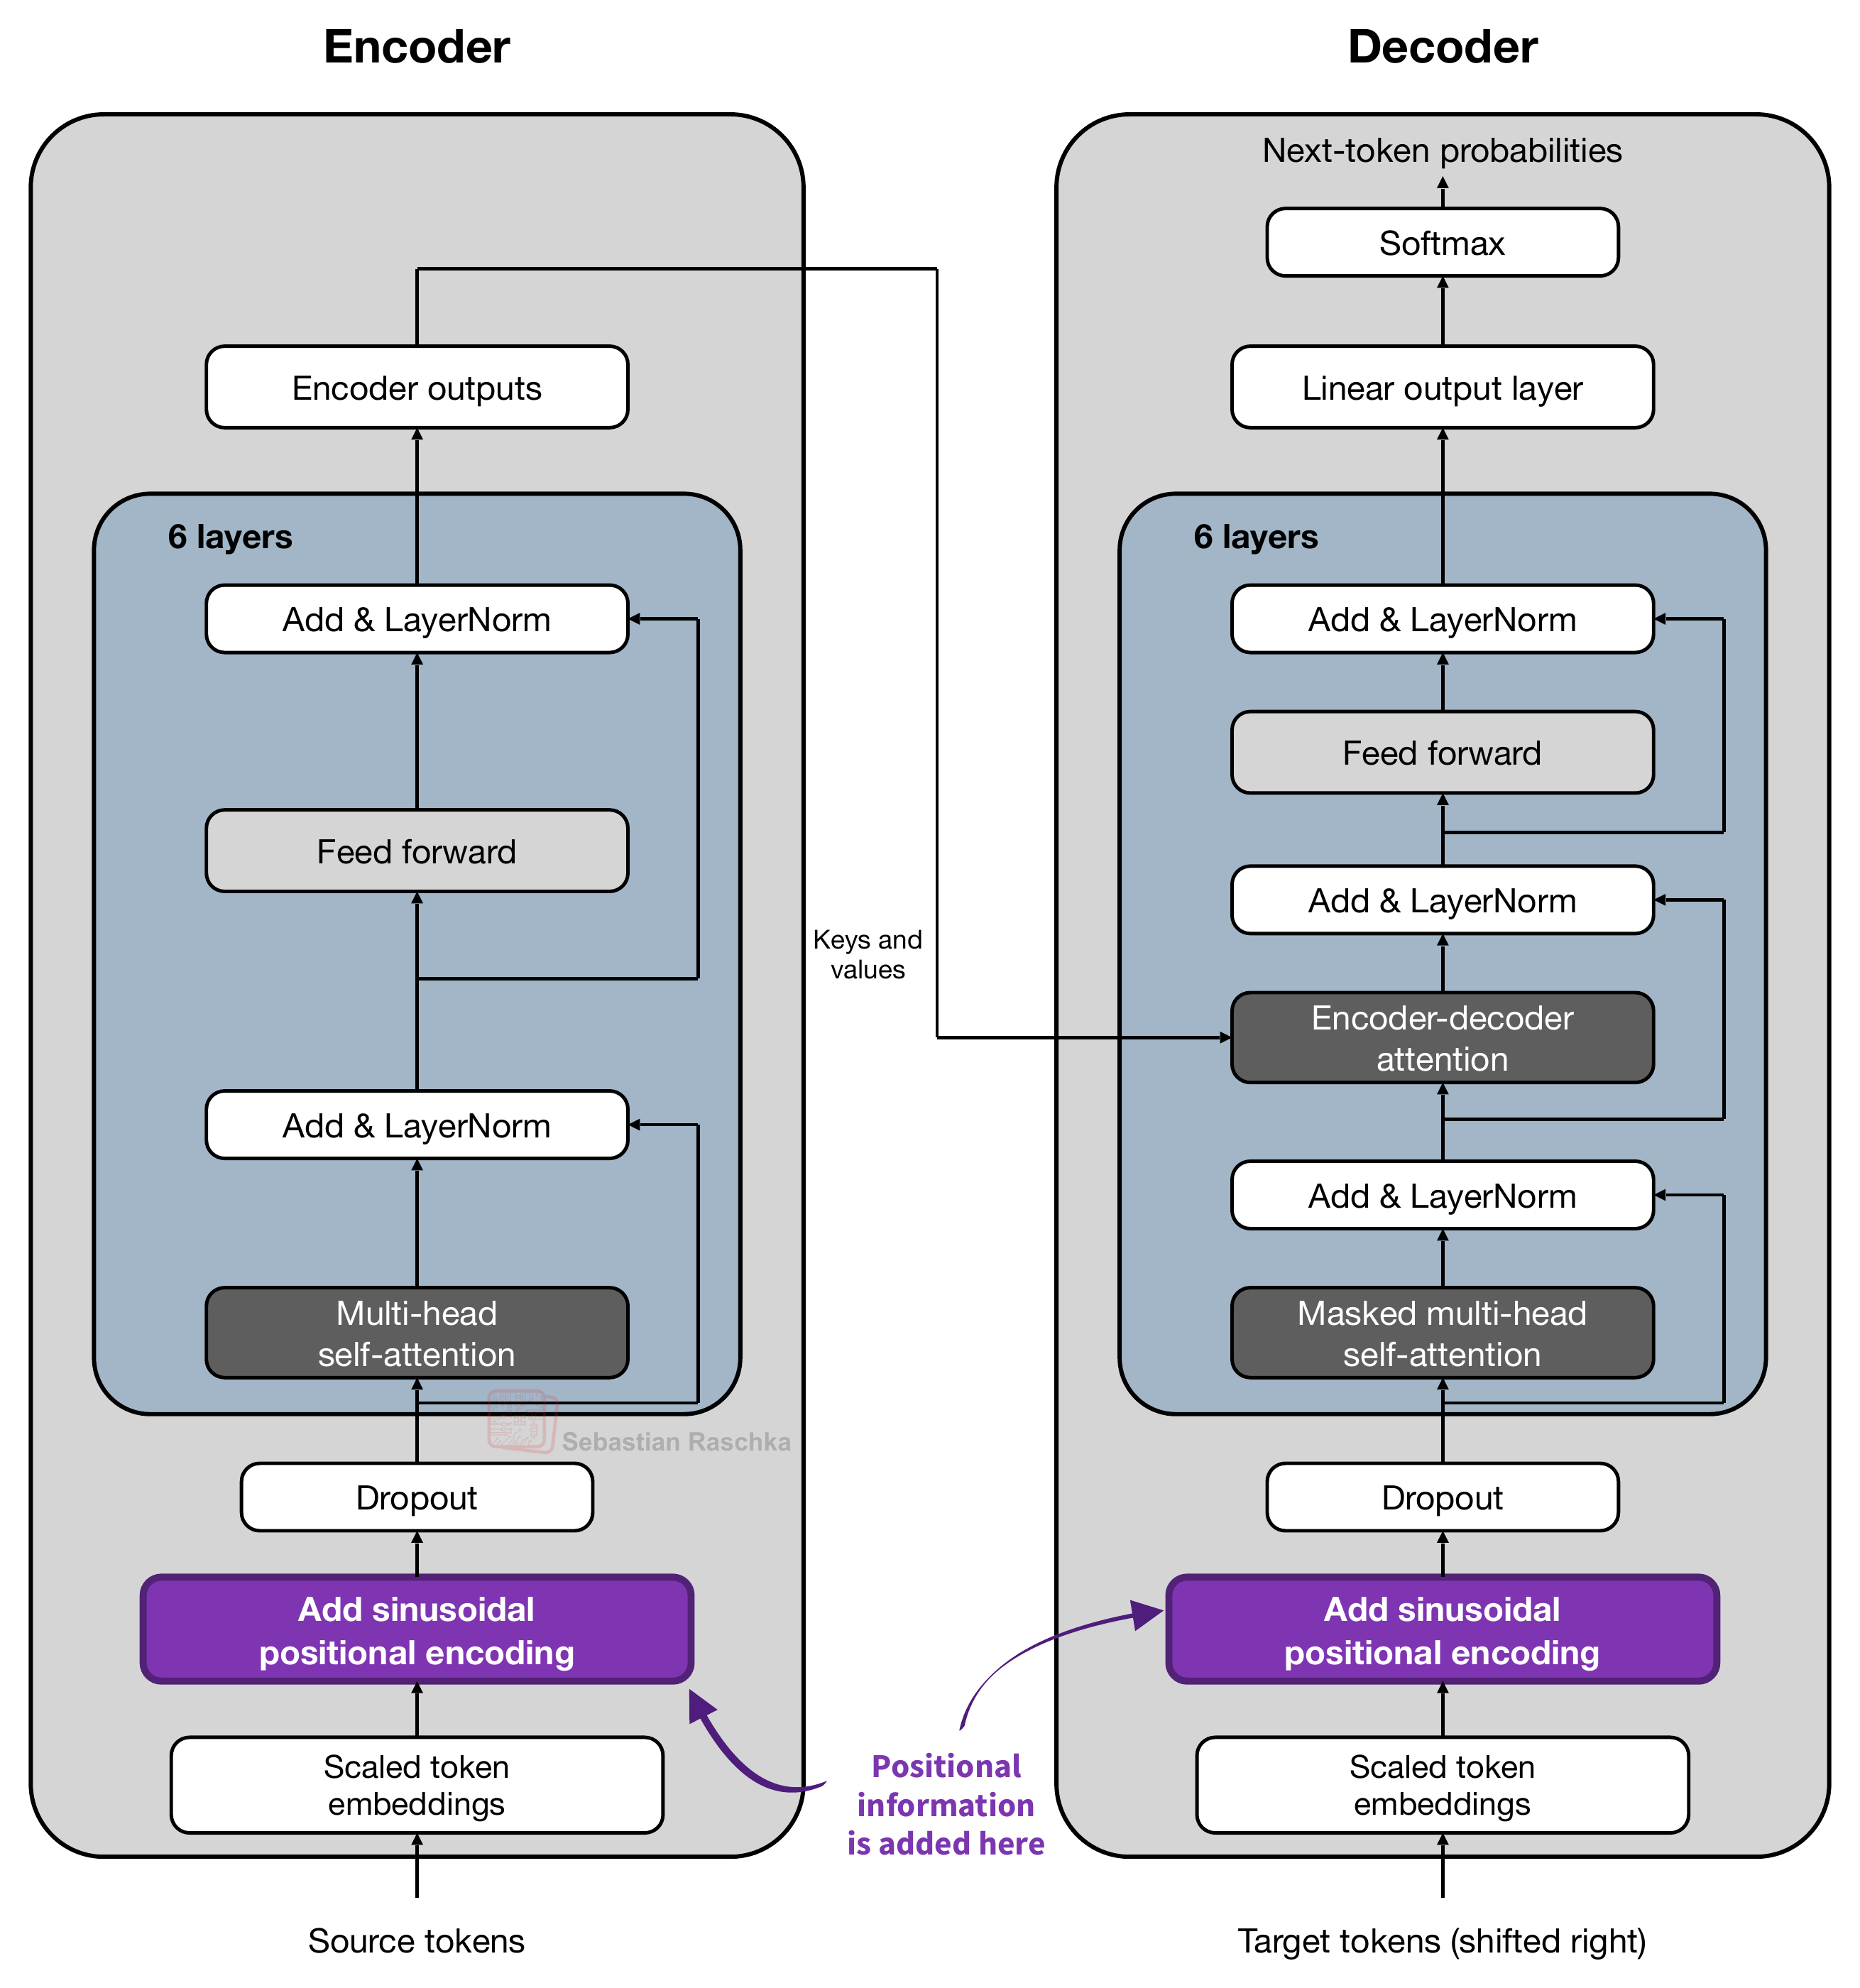
原始 transformer 还会在添加位置向量之前,将其 token 嵌入按 √(dmodel) 进行缩放,其中dmodel是嵌入宽度。
因此,上一节中的 GPT-2 使用的公式是
而原始 transformer 中使用的公式(如图 7 所示)是:

这种按 √(dmodel) 的缩放是一个次要的技术细节,但对于好奇的人来说,transformer 论文中并未解释这一缩放因子背后的动机,不过正如我多年前在 Twitter 线程中与同事讨论的那样,它很可能是为了在初始化时让 token 嵌入和正弦位置编码处于可比较的数值尺度上,这样当我们把它们相加时,位置向量就不会在求和中占据主导地位。
在 GPT-2 的情况下,这种缩放并非必要,因为原始 GPT-2 代码将 token 嵌入初始化为初始标准差 0.02,将位置嵌入初始化为初始标准差 0.01,因此它们已经大致处于相同的尺度上。
现在,更有趣的一点是位置嵌入Pm是如何计算的。
具体来说,每个位置向量具有以下条目:

和之前一样,m表示位置。索引i索引向量内的一对特征。
这里,一个特征就是位置向量中的一个数字。例如,假设我们有一个包含 8 个值的小向量(dmodel= 8),其条目编号为 0 到 7。(在原始论文中,小模型为 512,大模型为 1024,而不是 8,但那样难以可视化。)我们将它们分成四对,使得i从 0 到 3。
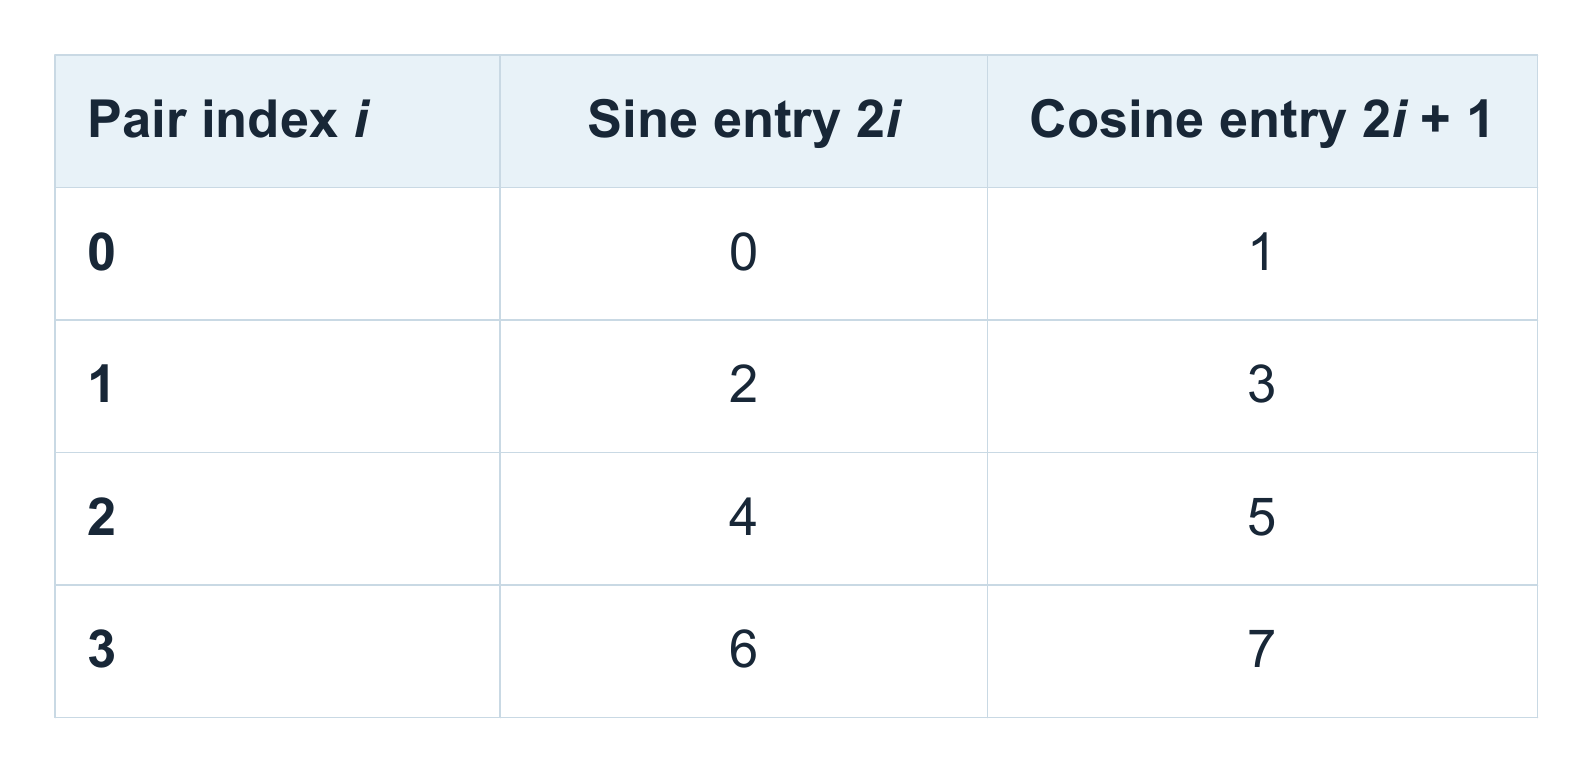
这里,索引 2i和 2i+ 1 选择与 pair 对应的两个条目i。
如前面的等式所示,位置m处的角度随后被输入正弦或余弦函数,以分别得到Pm,2i或Pm,2i+ 1,其计算方式如下:

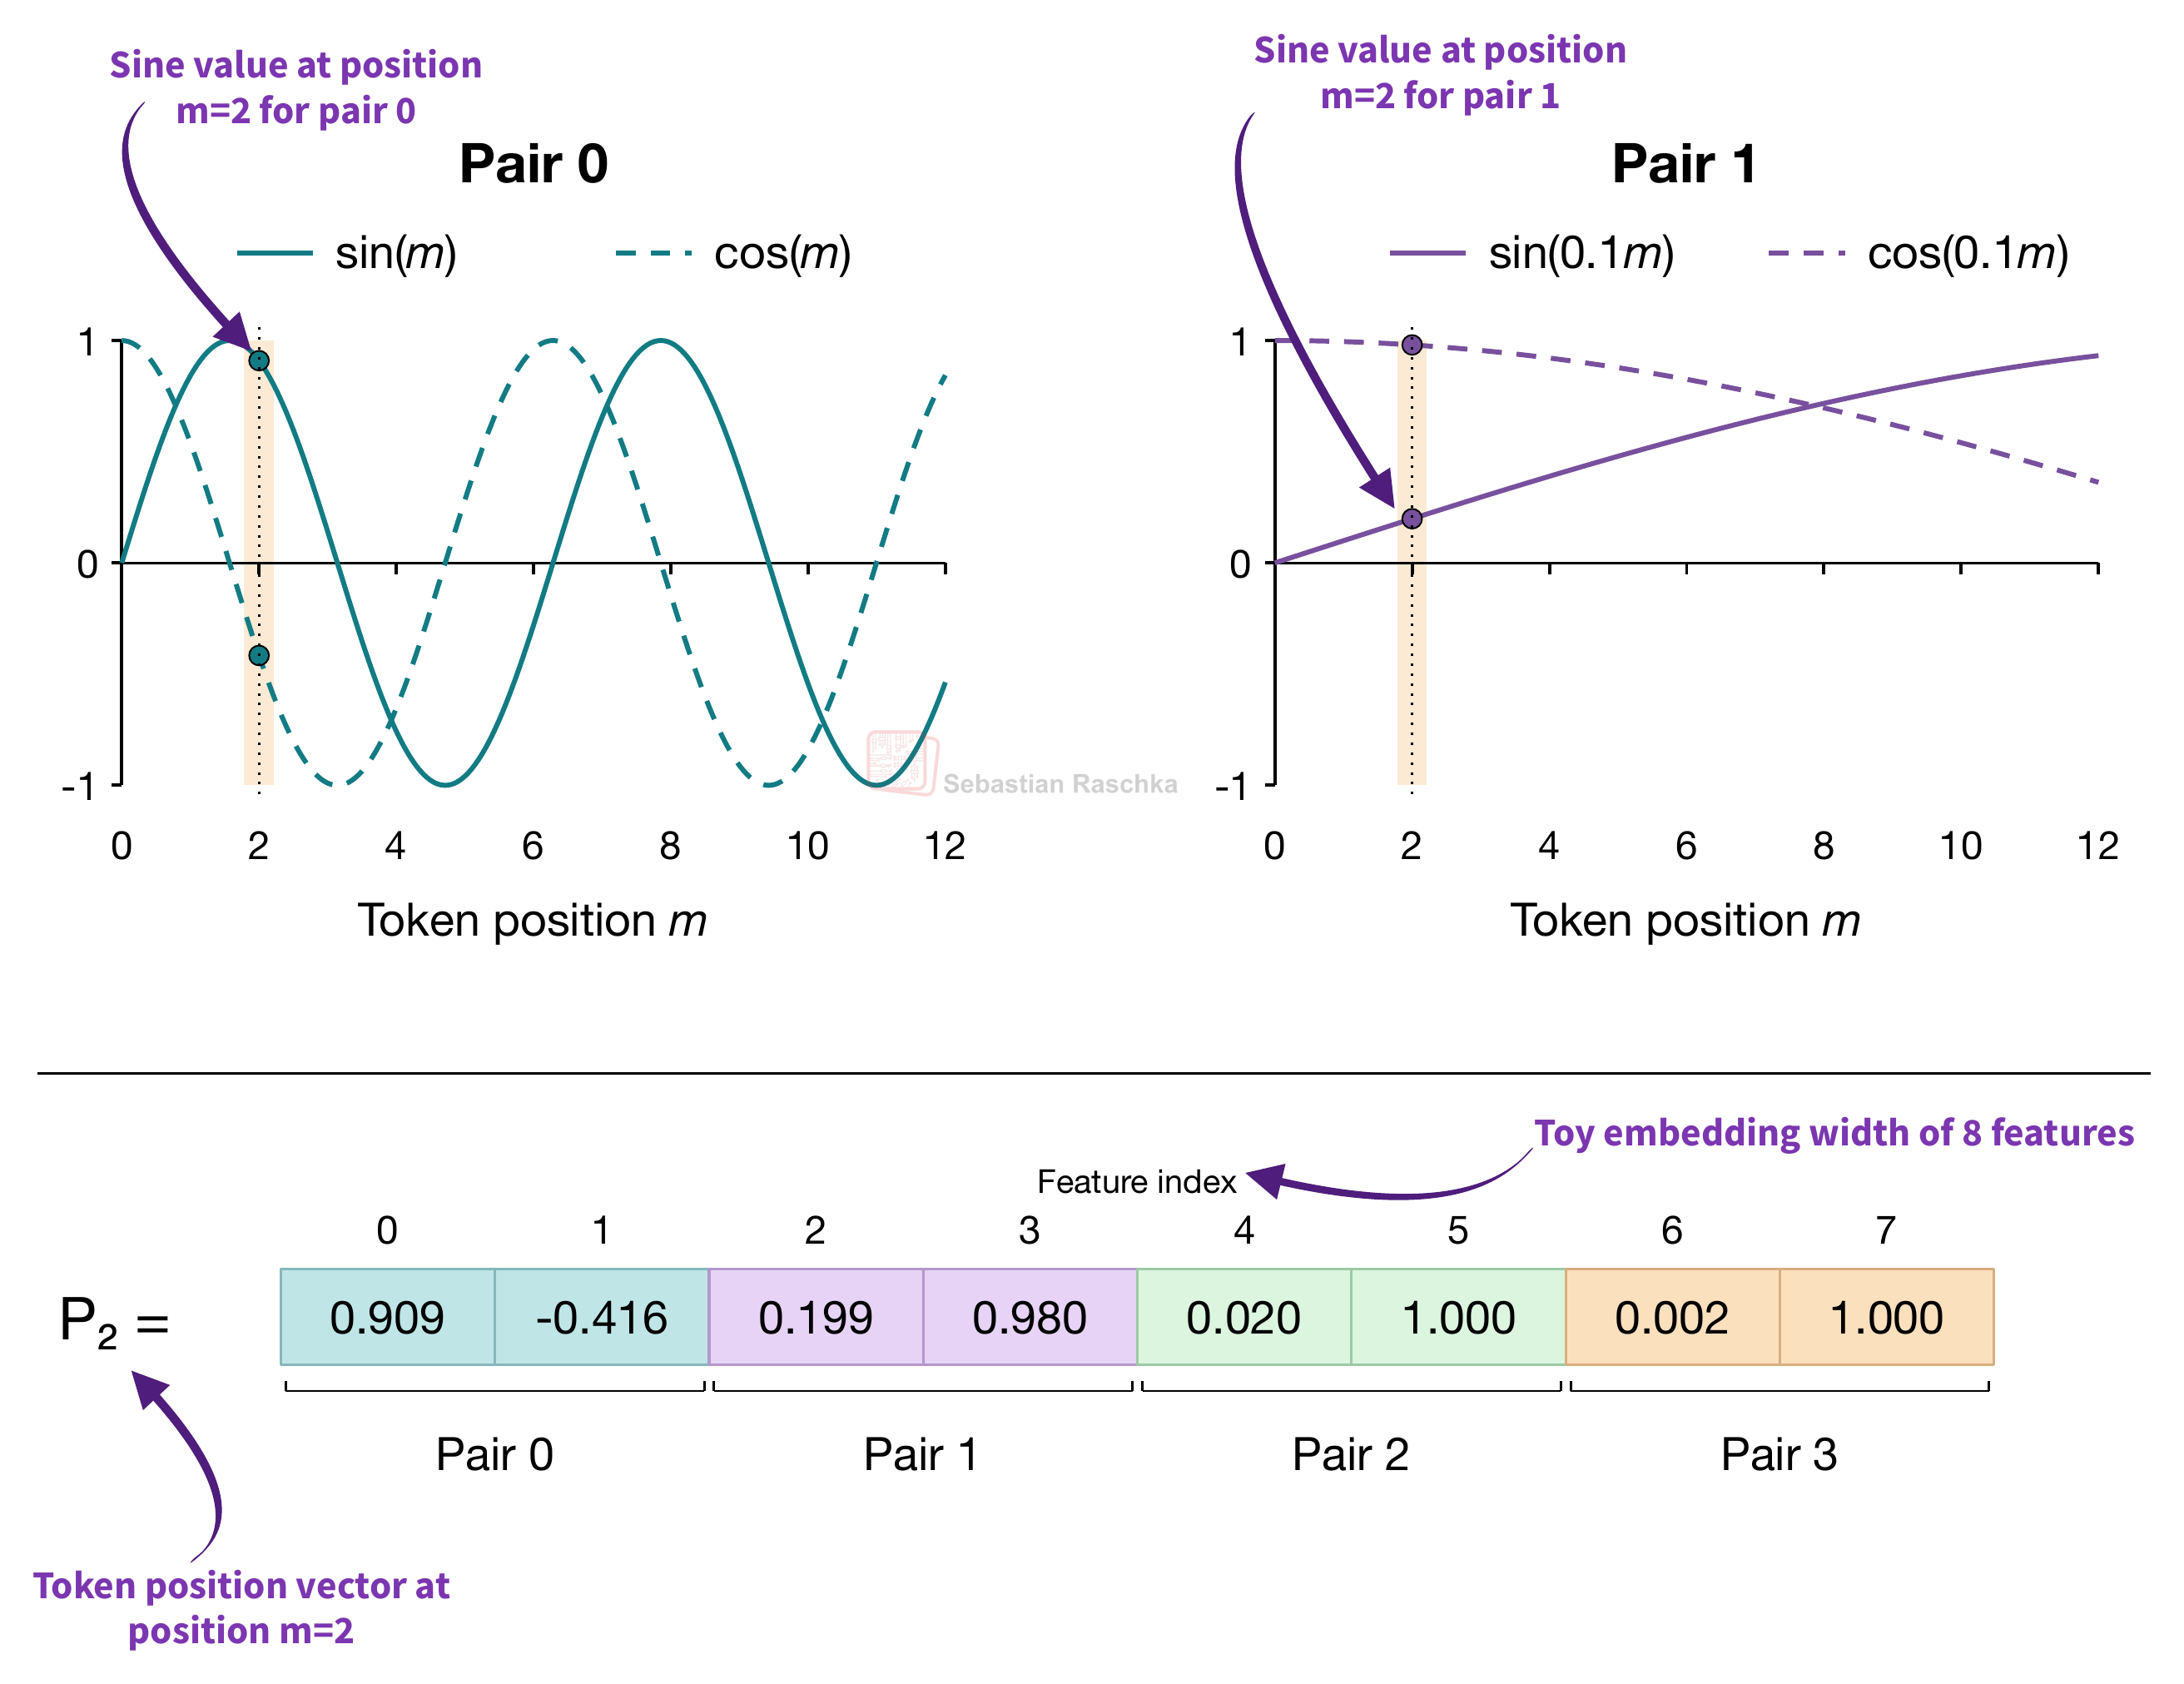
图 10 展示了我们 8 特征示例中全部四对在位置m= 2 时的这一计算。
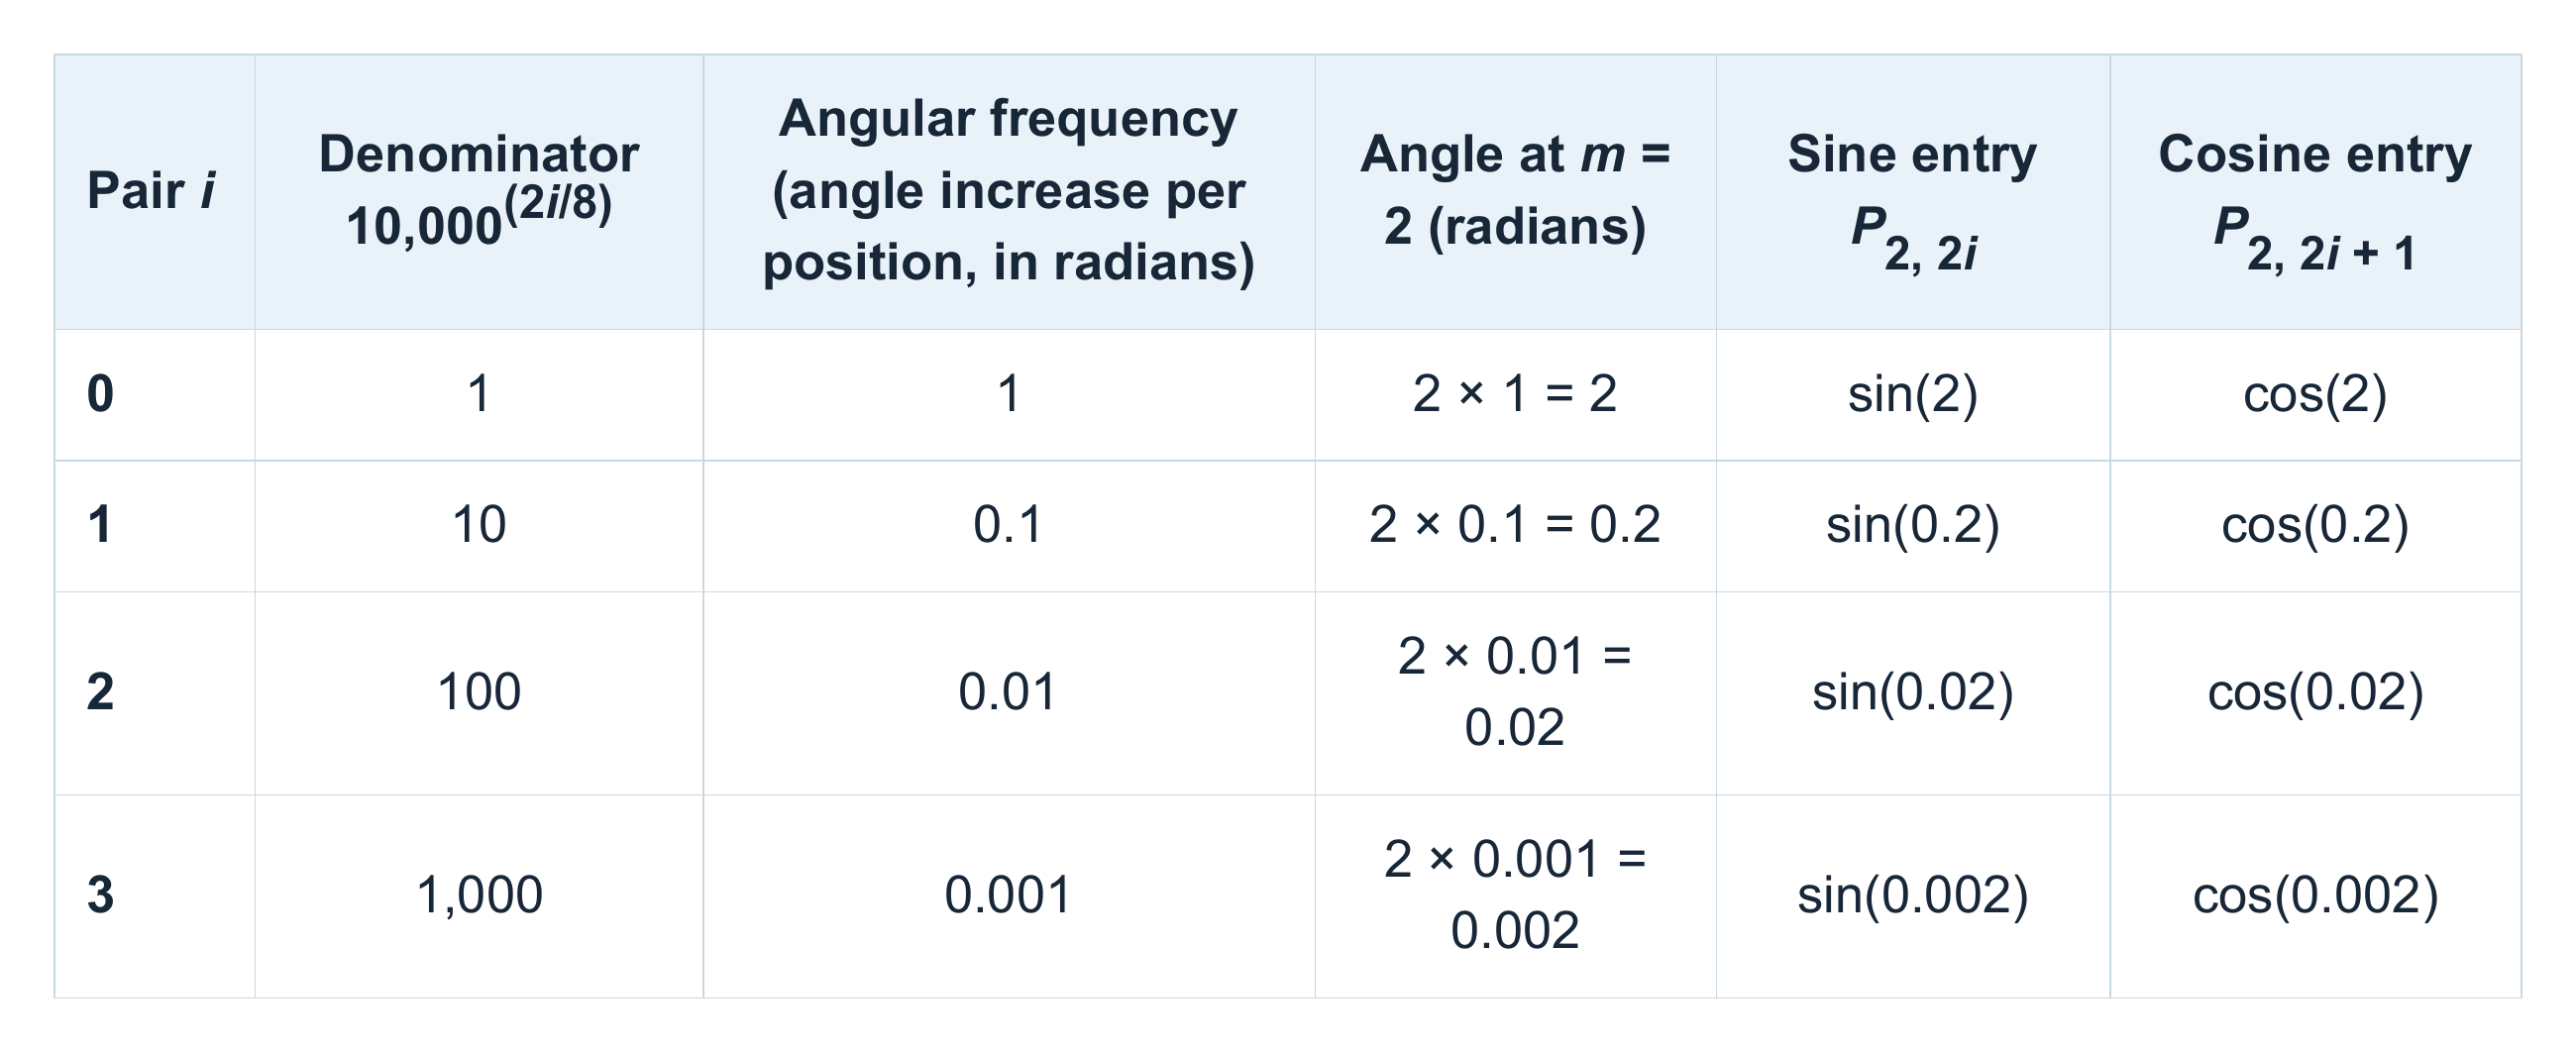
对于一个八特征嵌入,四个频率分别为每位置 1、0.1、0.01 和 0.001 弧度。在位置 2 处,第 1 行中的第一对是 (sin 2, cos 2) ≈ (0.909, −0.416)。
第二对位于第 2 行,变化更慢,得到 (sin 0.2, cos 0.2) ≈ (0.199, 0.980)。
下图可视化了不同对的正弦和余弦计算,这些结果随后被收集到一个位置向量中。
简而言之,与前面讨论的 GPT-2 方法相比,这种方法是获取位置嵌入向量的一种(更复杂的)替代方案。
与 GPT-2 嵌入类似,这些也是绝对嵌入,因为每个向量都根据其自身位置计算得出。然而,与 GPT-2 方法不同的是,正弦和余弦函数在训练期间保持固定。(此外,它们可以扩展到训练位置之外进行评估,例如超出 1024 的上下文长度,但仅此并不能保证模型在那里表现良好,因为模型在训练期间没有见过那些位置。)
总结一下,下面的图 12 比较了我们目前讨论的两种获取位置向量的方式。
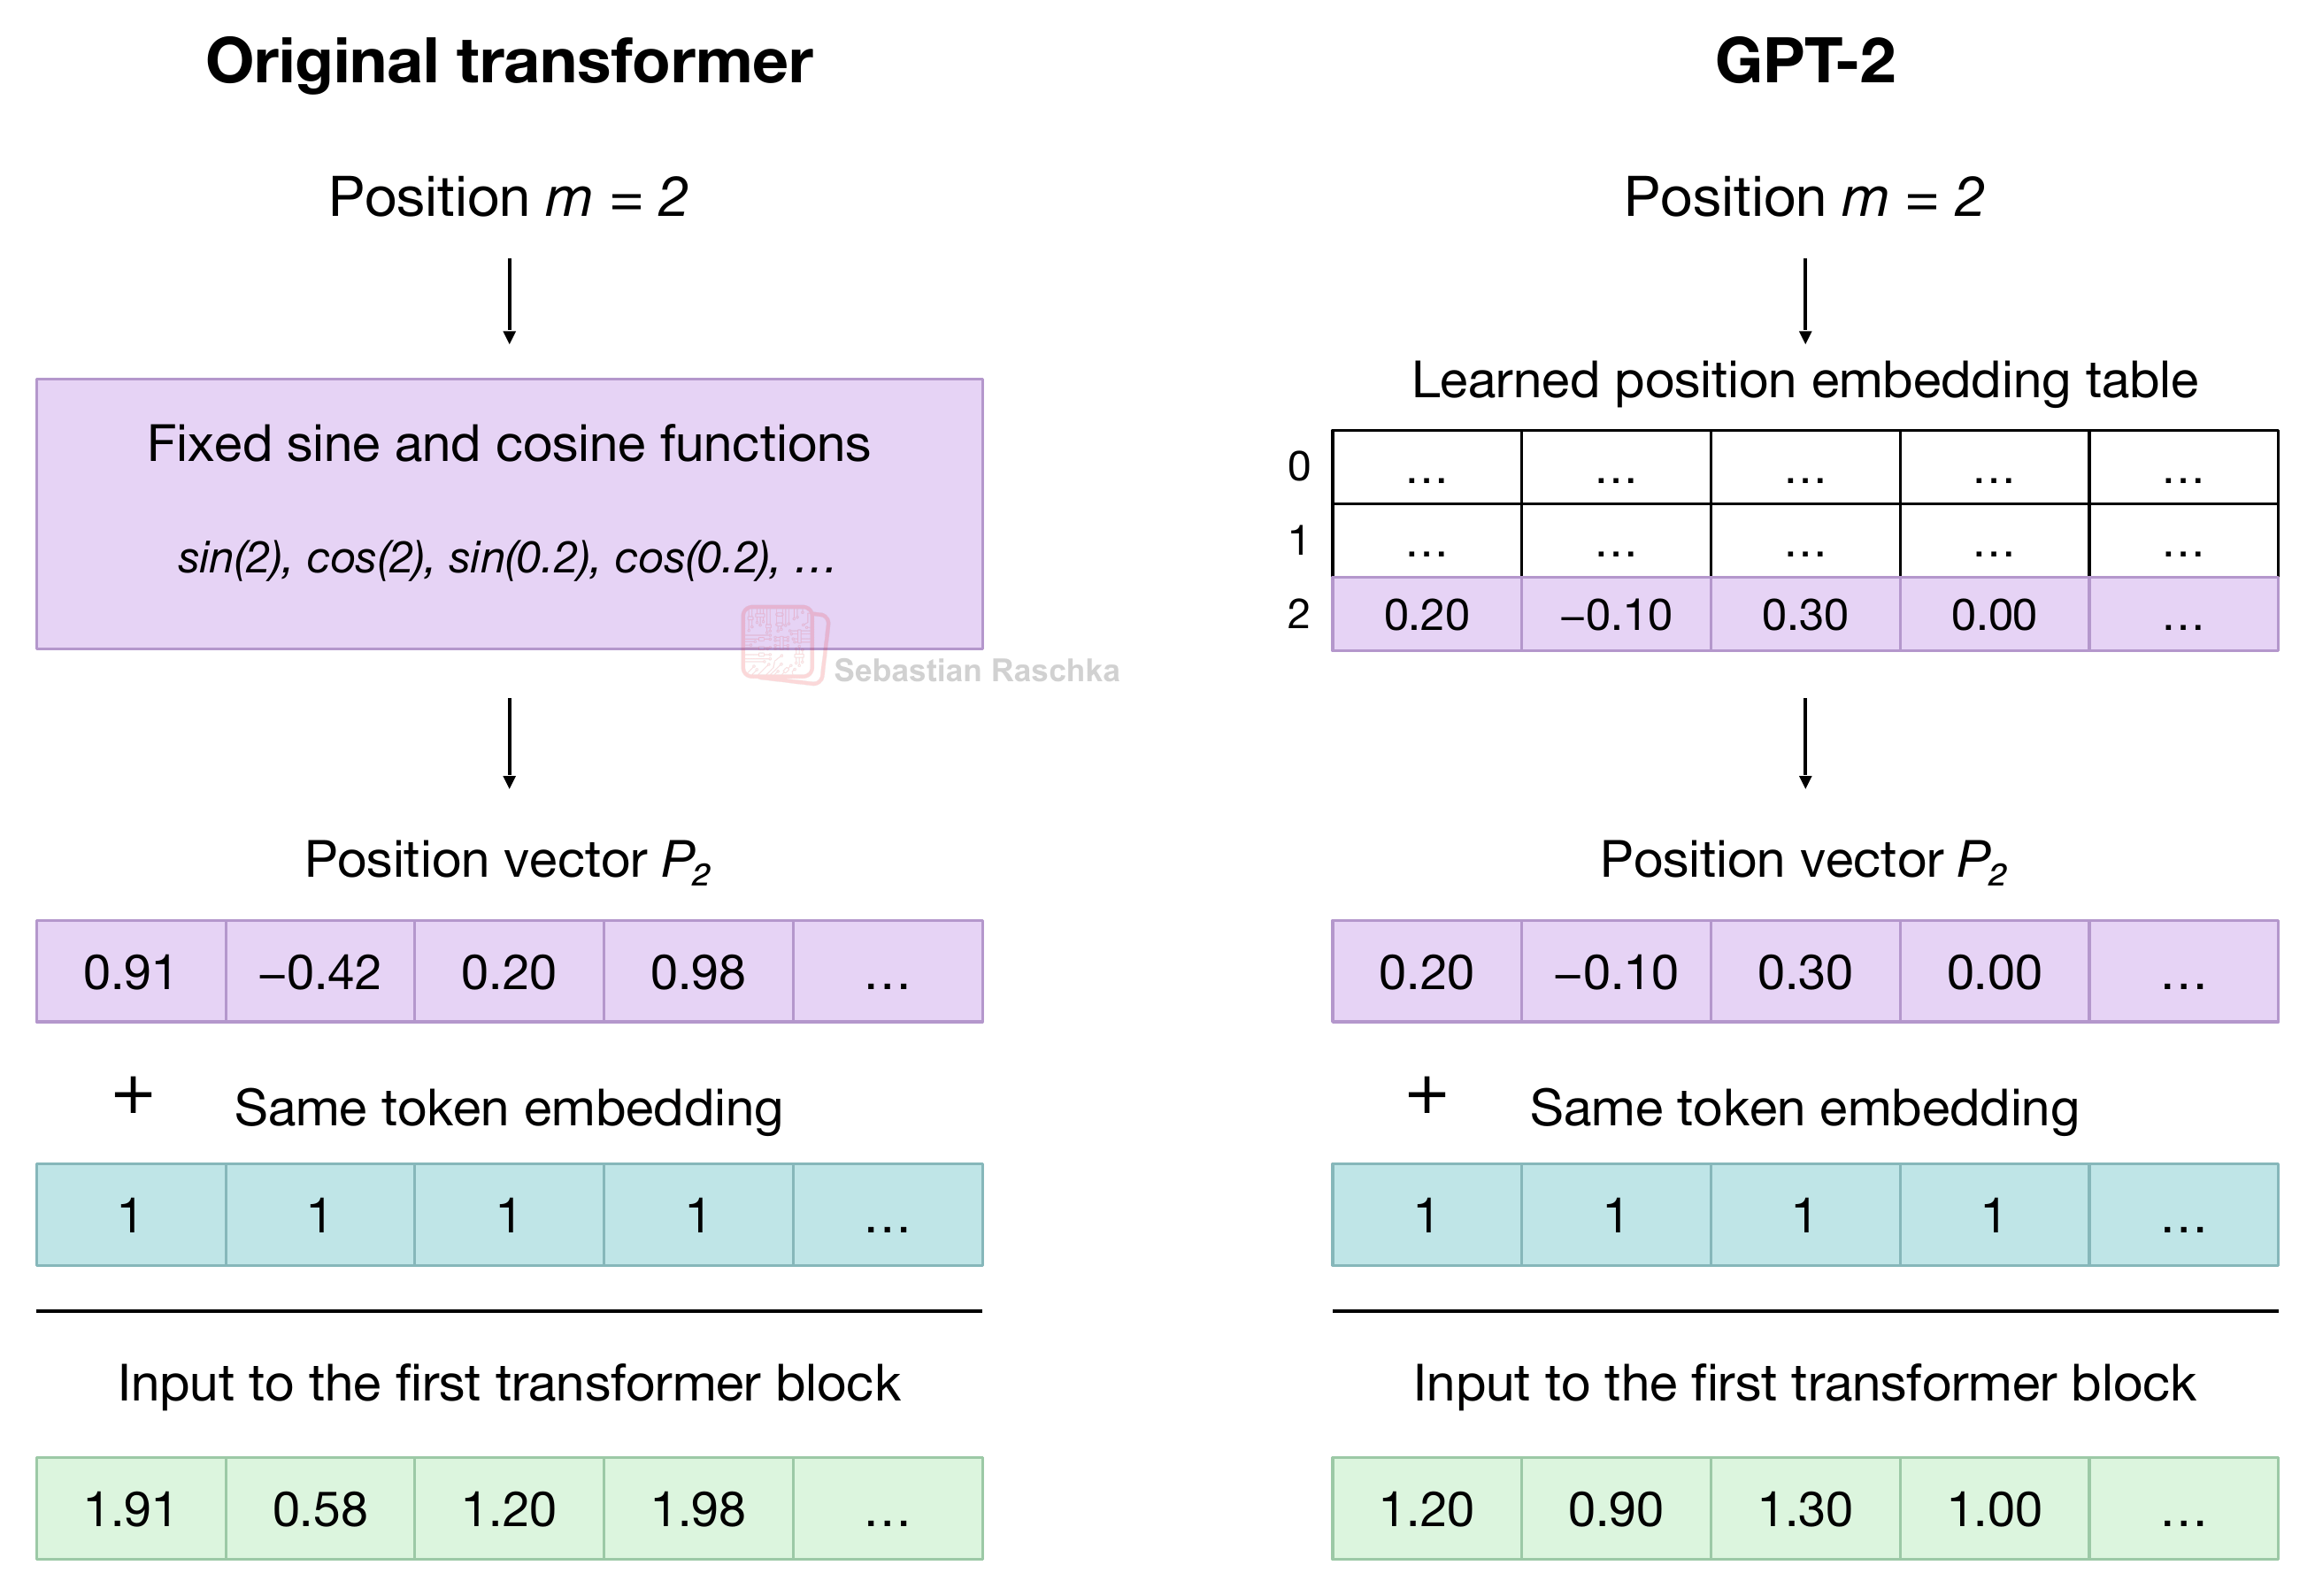
这种正弦式方法看起来可能是一种过于复杂的获取位置嵌入的方式,然而,理解它对于下一节讨论 RoPE 会很有用。
此外,这背后也有一些道理。作者选择正弦和余弦,是因为它们使得按某个偏移量平移会产生某个确定性的差异。例如,位置 2 到 5 之间的差异与位置 102 到 105 之间的差异都是 3,因此会产生相同的旋转。
根据Attention Is All You Need论文:
“……很容易学会按相对位置进行关注,因为对于任何固定偏移量k,PEpos +k都可以表示为PEpos的线性函数。”
或者用不那么技术性的说法,作者假设这一性质会让注意力更容易学习诸如“早三个 token”这样的关系。
下面的图 13 以一对正弦/余弦为例说明了这一点。旋转是一种线性变换,而两个三位置的平移使用的是相同的旋转。
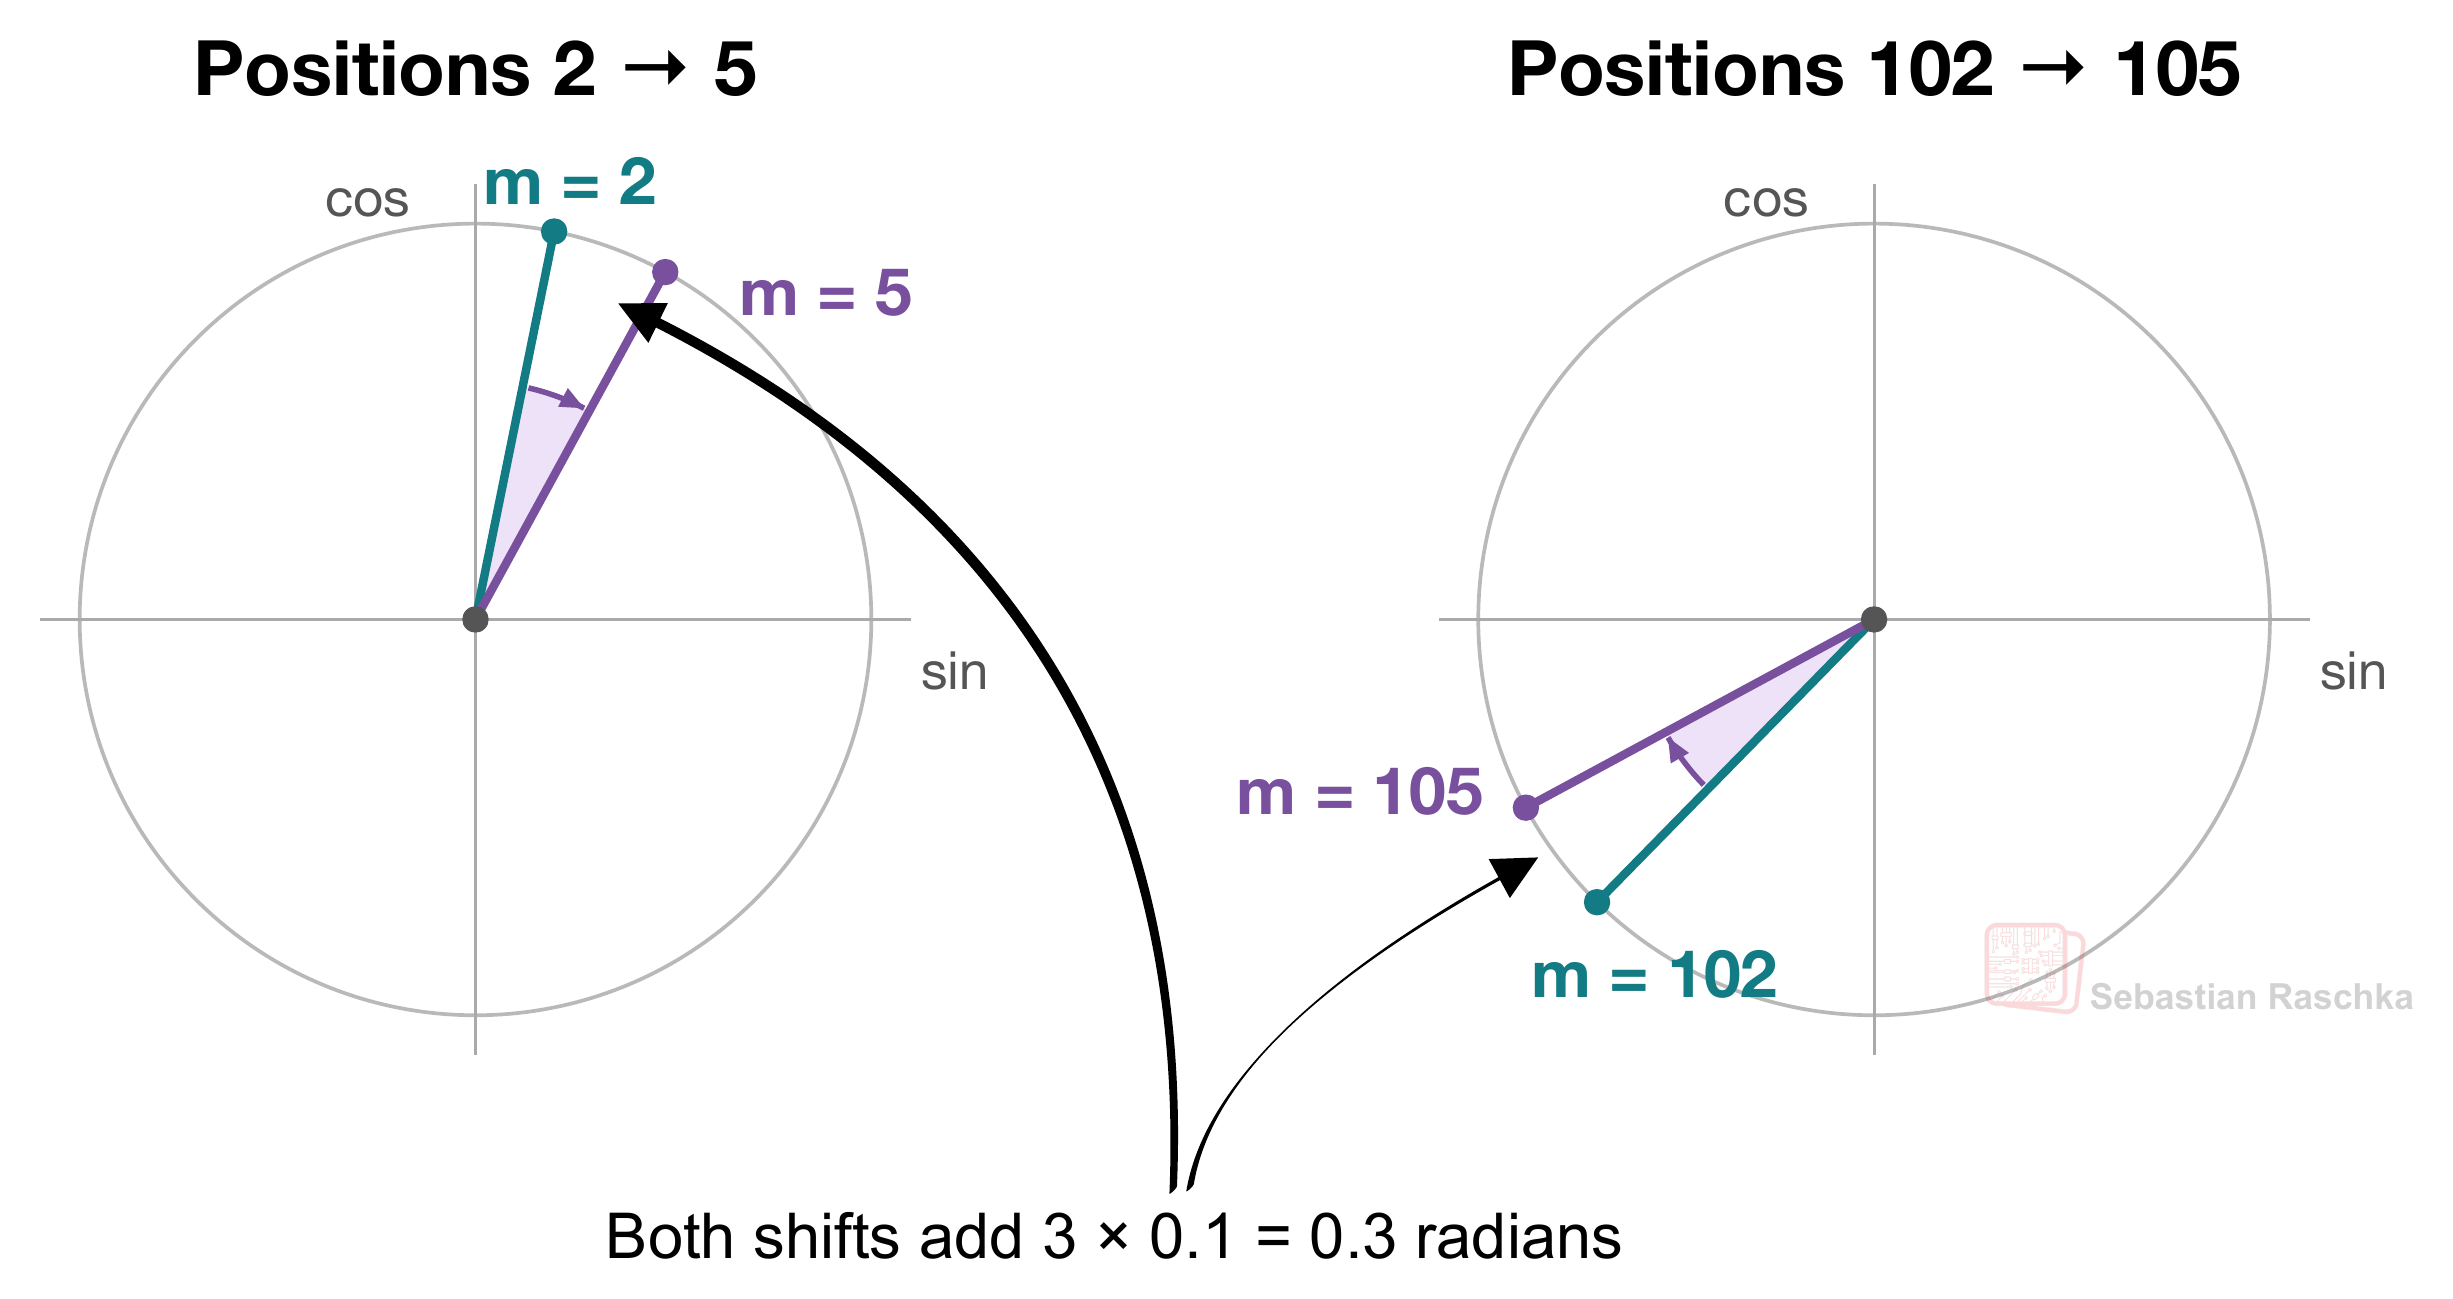
因此,上述正弦方法仍被视为绝对位置编码,因为添加到每个 token 嵌入上的向量表示的是该 token 从序列开头算起的位置。
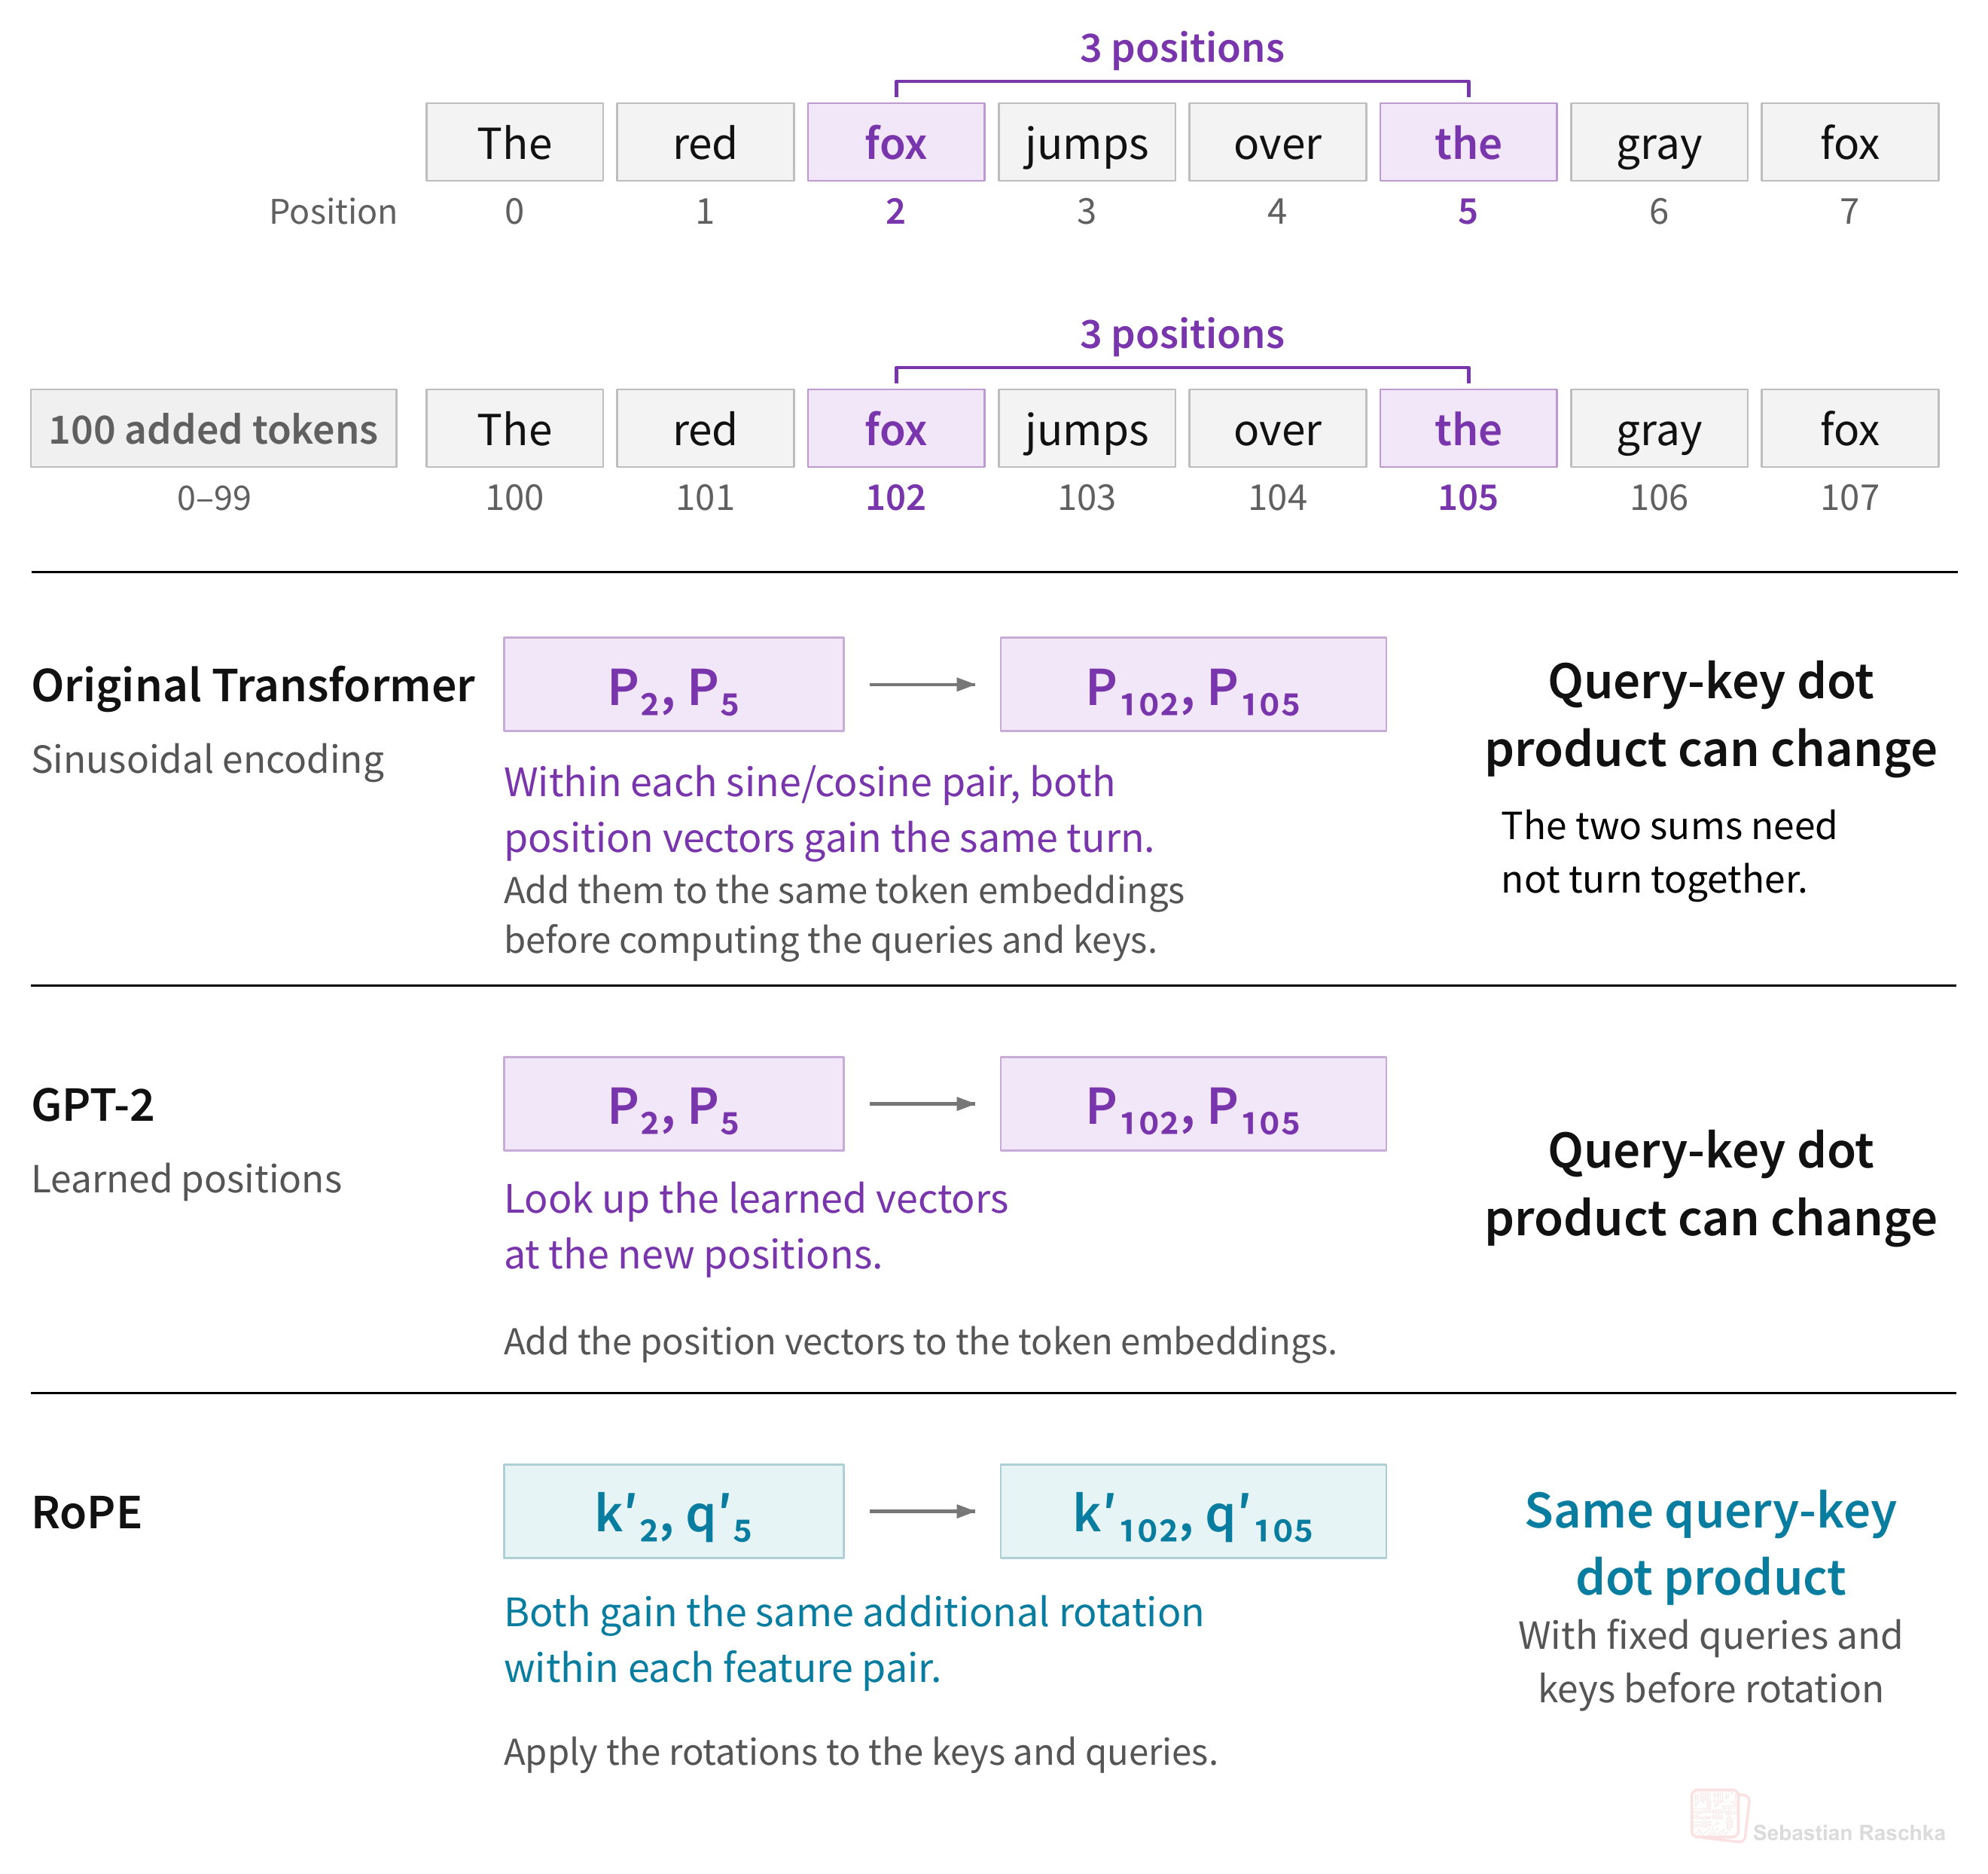
例如,如上一张图所示,位置 2 和 5 处的 token 会收到位置向量P2和P5。如果我们把这些 token 移到位置 102 和 105,它们仍然相隔三个位置。但每个 token 会得到不同的位置向量,因为它的绝对位置m已经改变。
因此,即使 token 嵌入保持不变,它们的注意力分数也可能改变。正弦结构仍然为模型提供了一种学习相对关系的方式。
无论如何,我们下面要讨论的 RoPE 将这种相对关系直接构建到注意力计算中。RoPE,由 Su 等人在 2021 年的 RoFormer 论文中提出,代表旋转位置嵌入(Rotary Position Embedding),被视为一种相对位置方法。
在注意力中,每个 token 当前的表示会被投影为查询、键和值向量。查询-键的点积决定注意力分数。经过掩码和 softmax 后,得到的权重决定值向量如何混合。如需复习,请参阅我的理解并编码 LLM 中的自注意力、多头注意力、因果注意力和交叉注意力文章:
RoPE 在点积之前利用 token 的位置来旋转其 query 和 key 向量。value 向量不经过这一旋转。下面的图 14 展示了在较新的 MiniMax-M3 中 RoPE 的应用位置概览,其中 QK-Norm 在 RoPE 之前对 query 和 key 进行归一化。
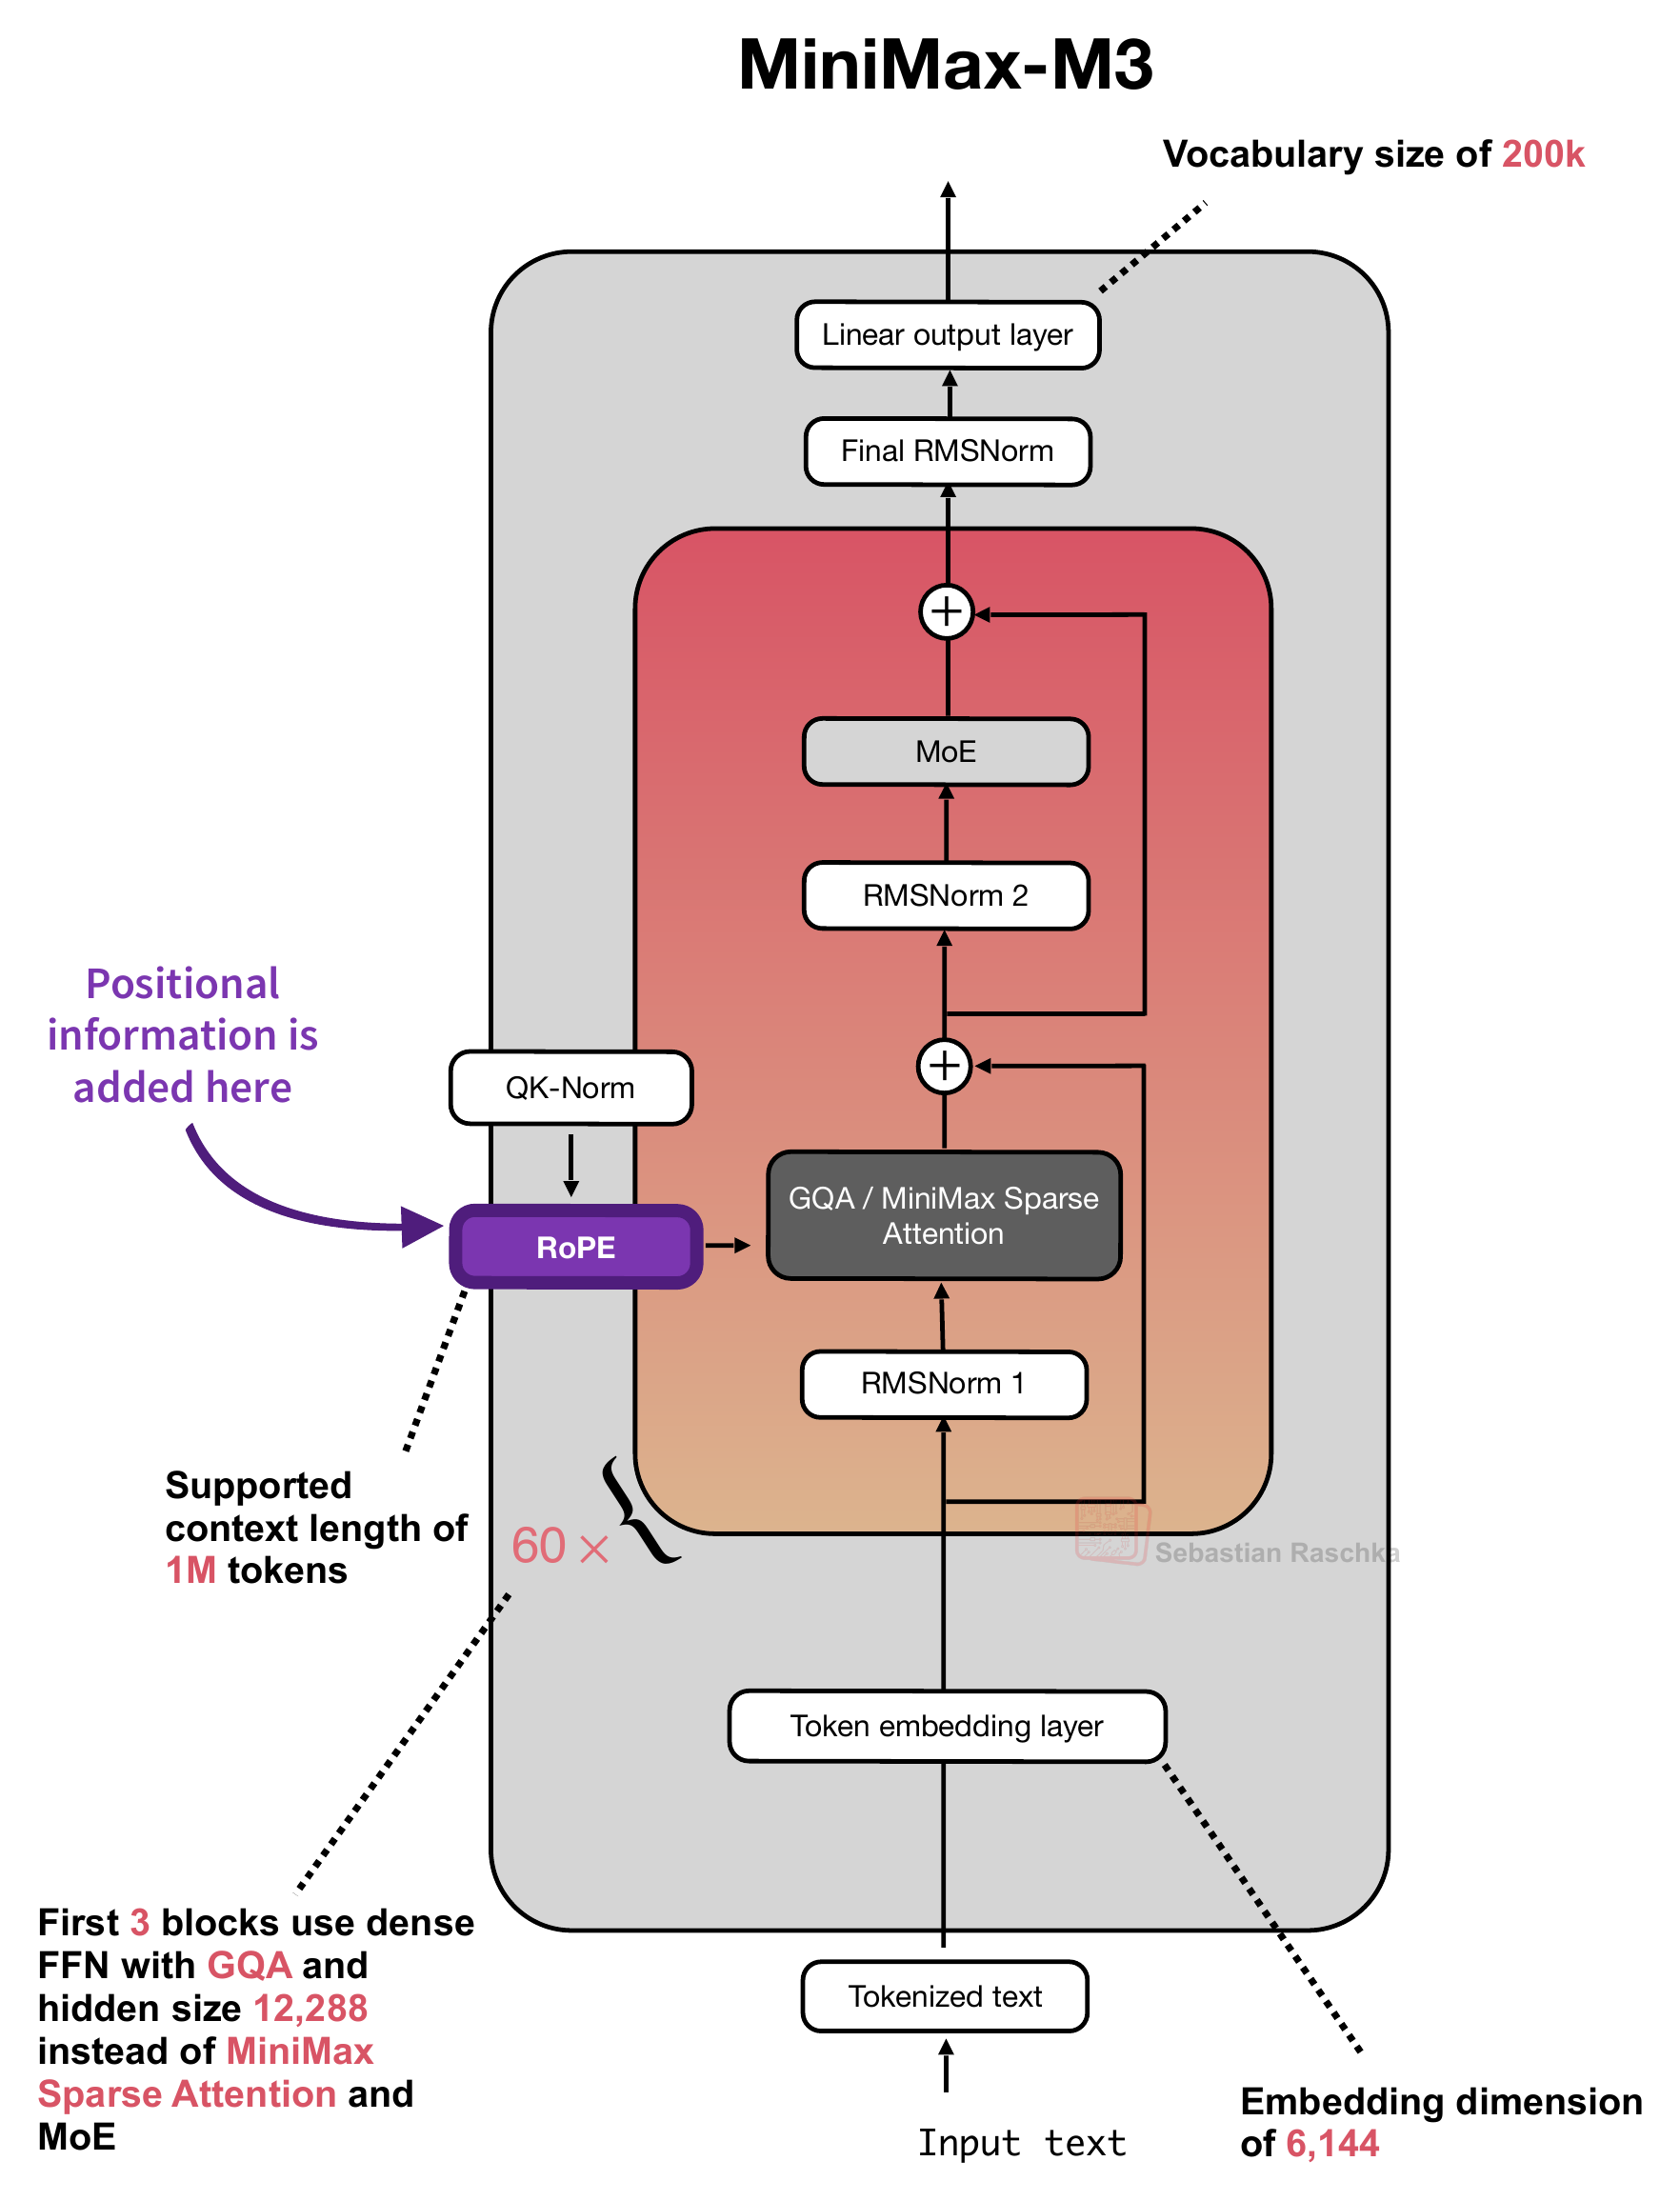
如上图所示,该 LLM 架构没有在初始 token 嵌入旁显式添加位置向量。其显式位置信号是在注意力内部注入的。
旁注:MiniMax-M3 只旋转每个 query 和 key 头的一部分,这种变体称为“部分 RoPE”,我们将在第 6.1 节中介绍。但为了先理解 RoPE 的基本操作,让我们用一个小例子逐步演示该方法。
注意力通常将其 query、key 和 value 特征划分为多个头,并行处理。因此,整个机制通常被称为多头注意力(注意,分组查询注意力也使用多个头)。在这里,每个注意力头计算自己的注意力分数和加权和。RoPE 随后作用于每个 query 和 key 头内的数值对。
为具体说明,下面的图 12 展示了一个 token 表示经过学习到的 query 和 key 投影的过程,这些投影通过权重矩阵计算WQ和WK。在这个玩具示例中,每个投影产生 16 个特征,这些特征被重塑为两个头,每个头 8 个特征。在下图中,每个小单元格包含一个标量特征,即向量中的一个数值项(由于篇幅原因未显示具体数字)。
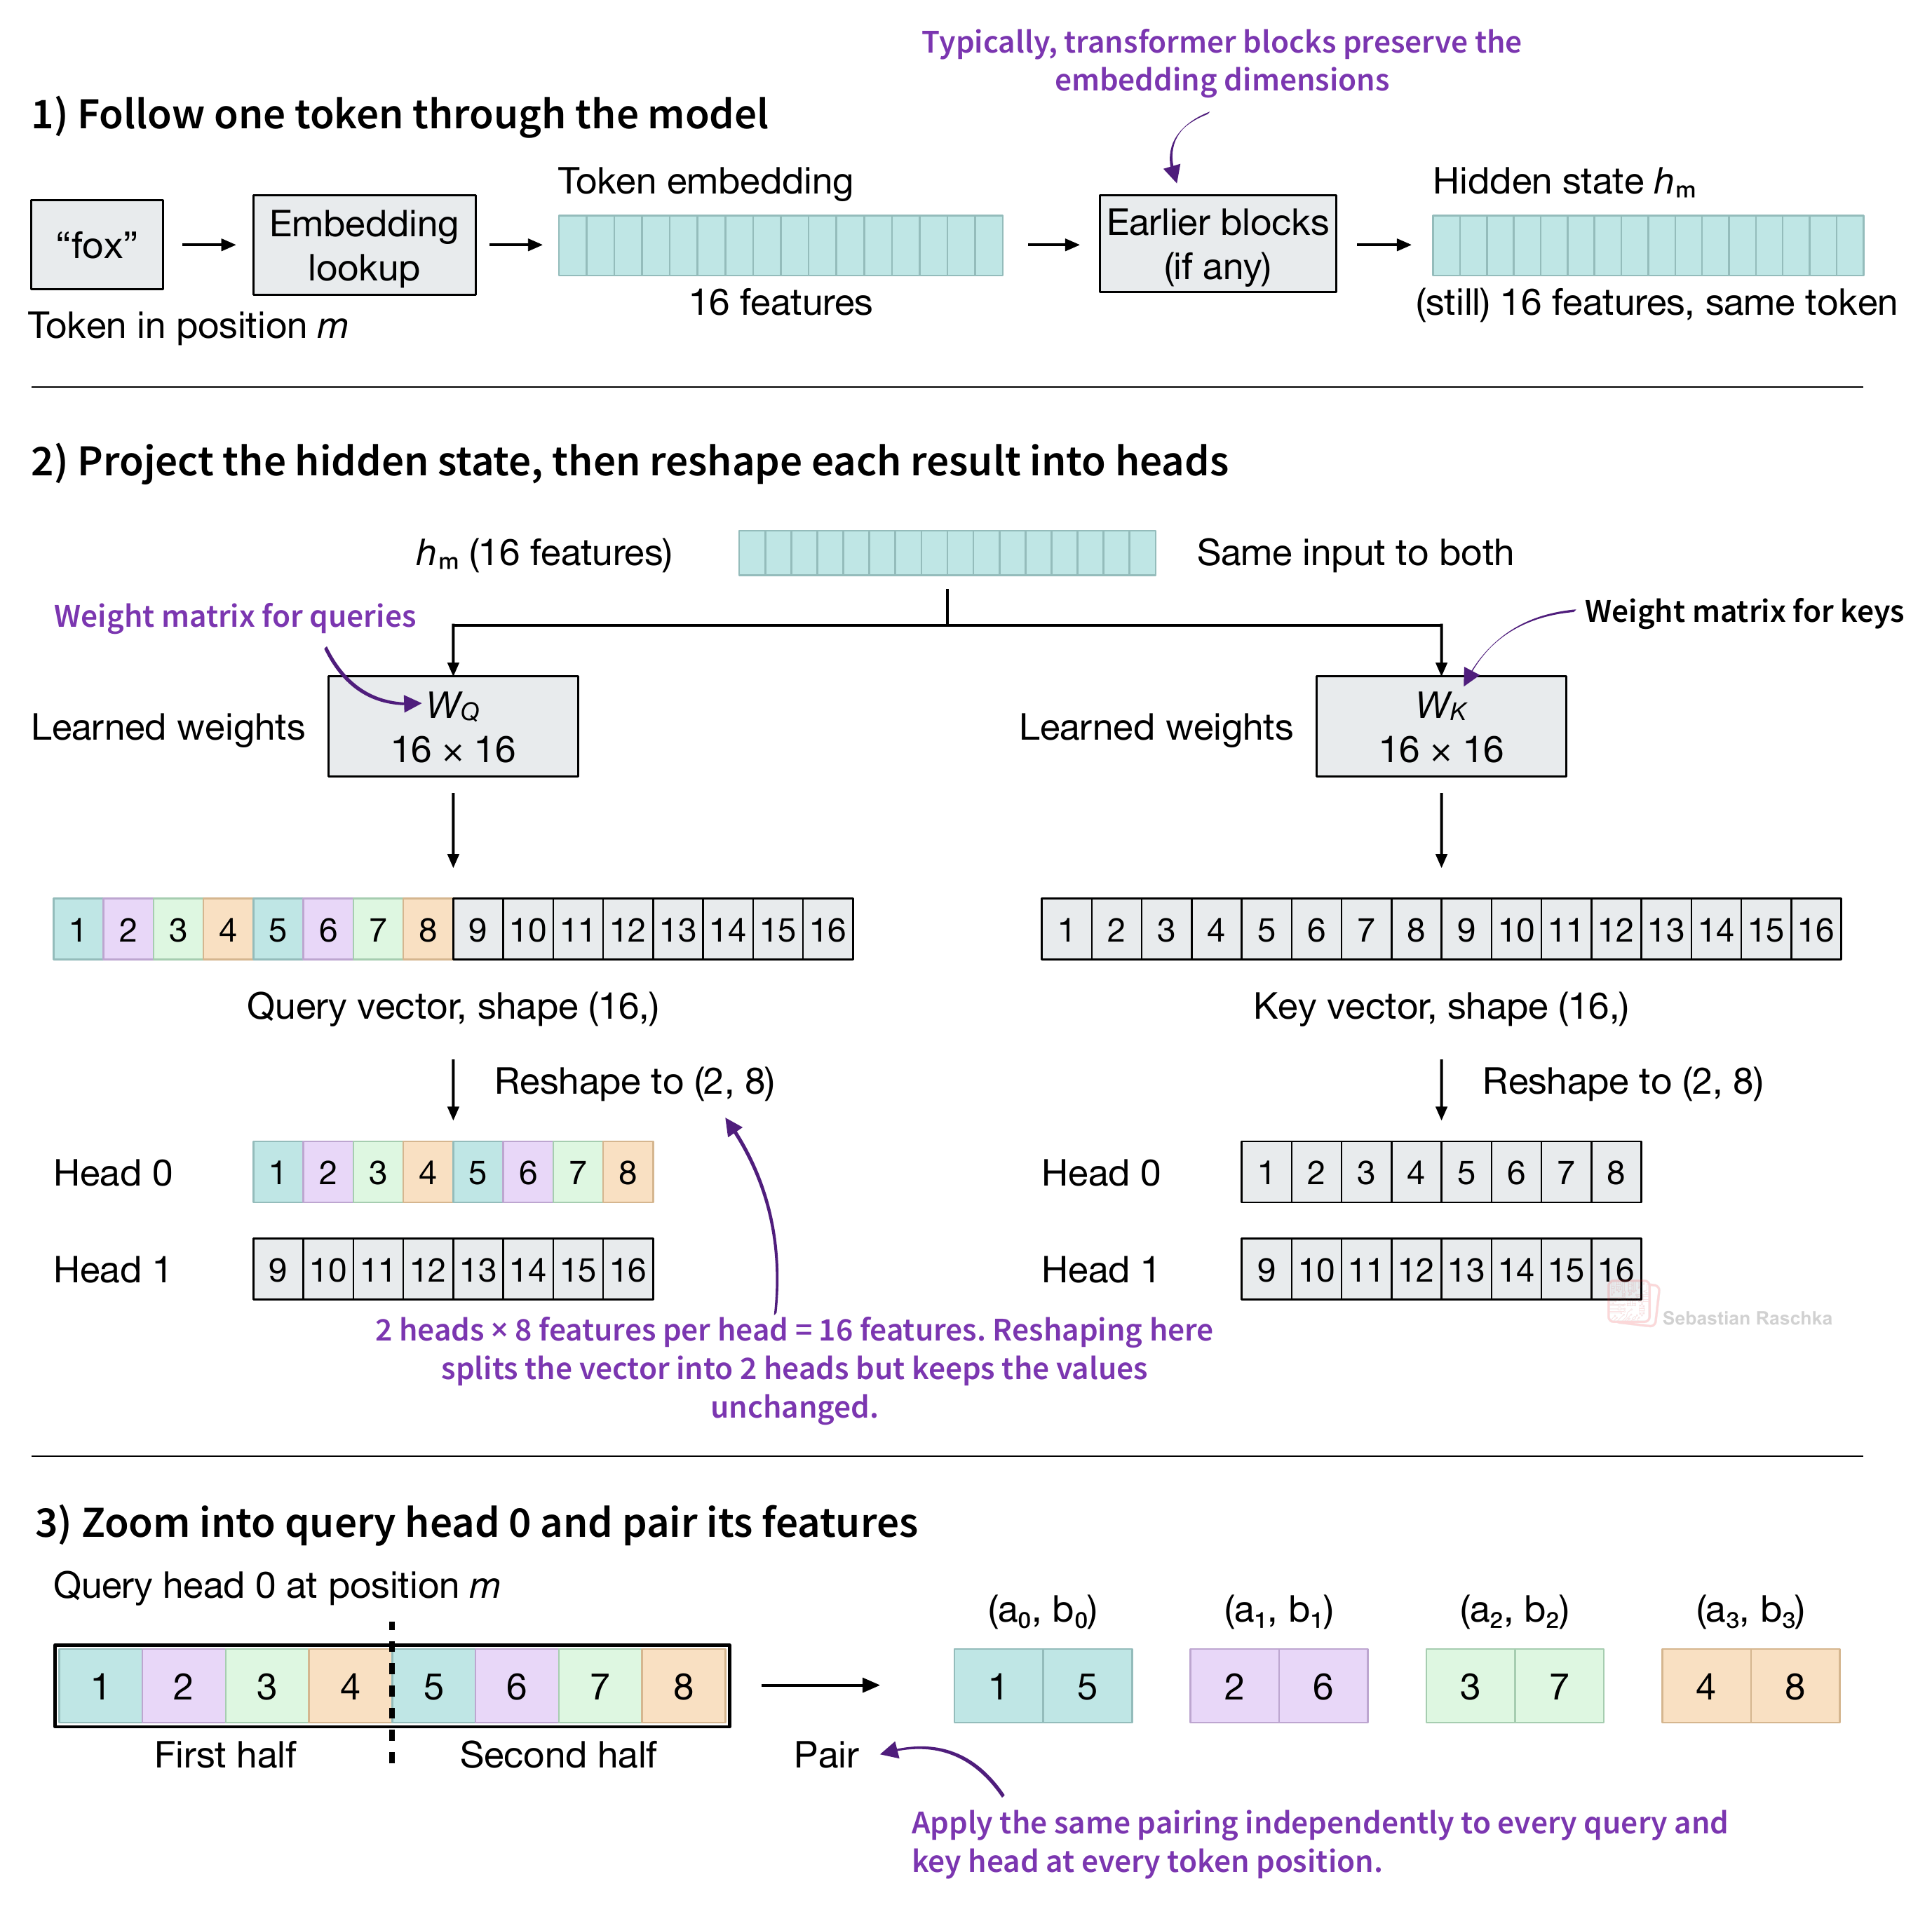
对于第一个 8 特征的头,[1, 2, 3, 4, 5, 6, 7, 8],我们将前半部分的每个特征与后半部分对应的特征配对。这得到(1, 5),(2, 6),(3, 7),以及(4, 8)。这种对半拆分约定用于 LLM 实现中,包括我的Qwen3 实现。(我们将在实现基本操作后,再将其与原始的、替代的相邻特征配对方法进行比较。)
每一对都会根据 token 位置获得一个旋转角度m以及该对的频率θi。对应的 query 和 key 对使用相同的频率。下面的图 16 展示了我们如何旋转这些对、将更新后的特征放回其原始位置,并计算 query-key 点积。
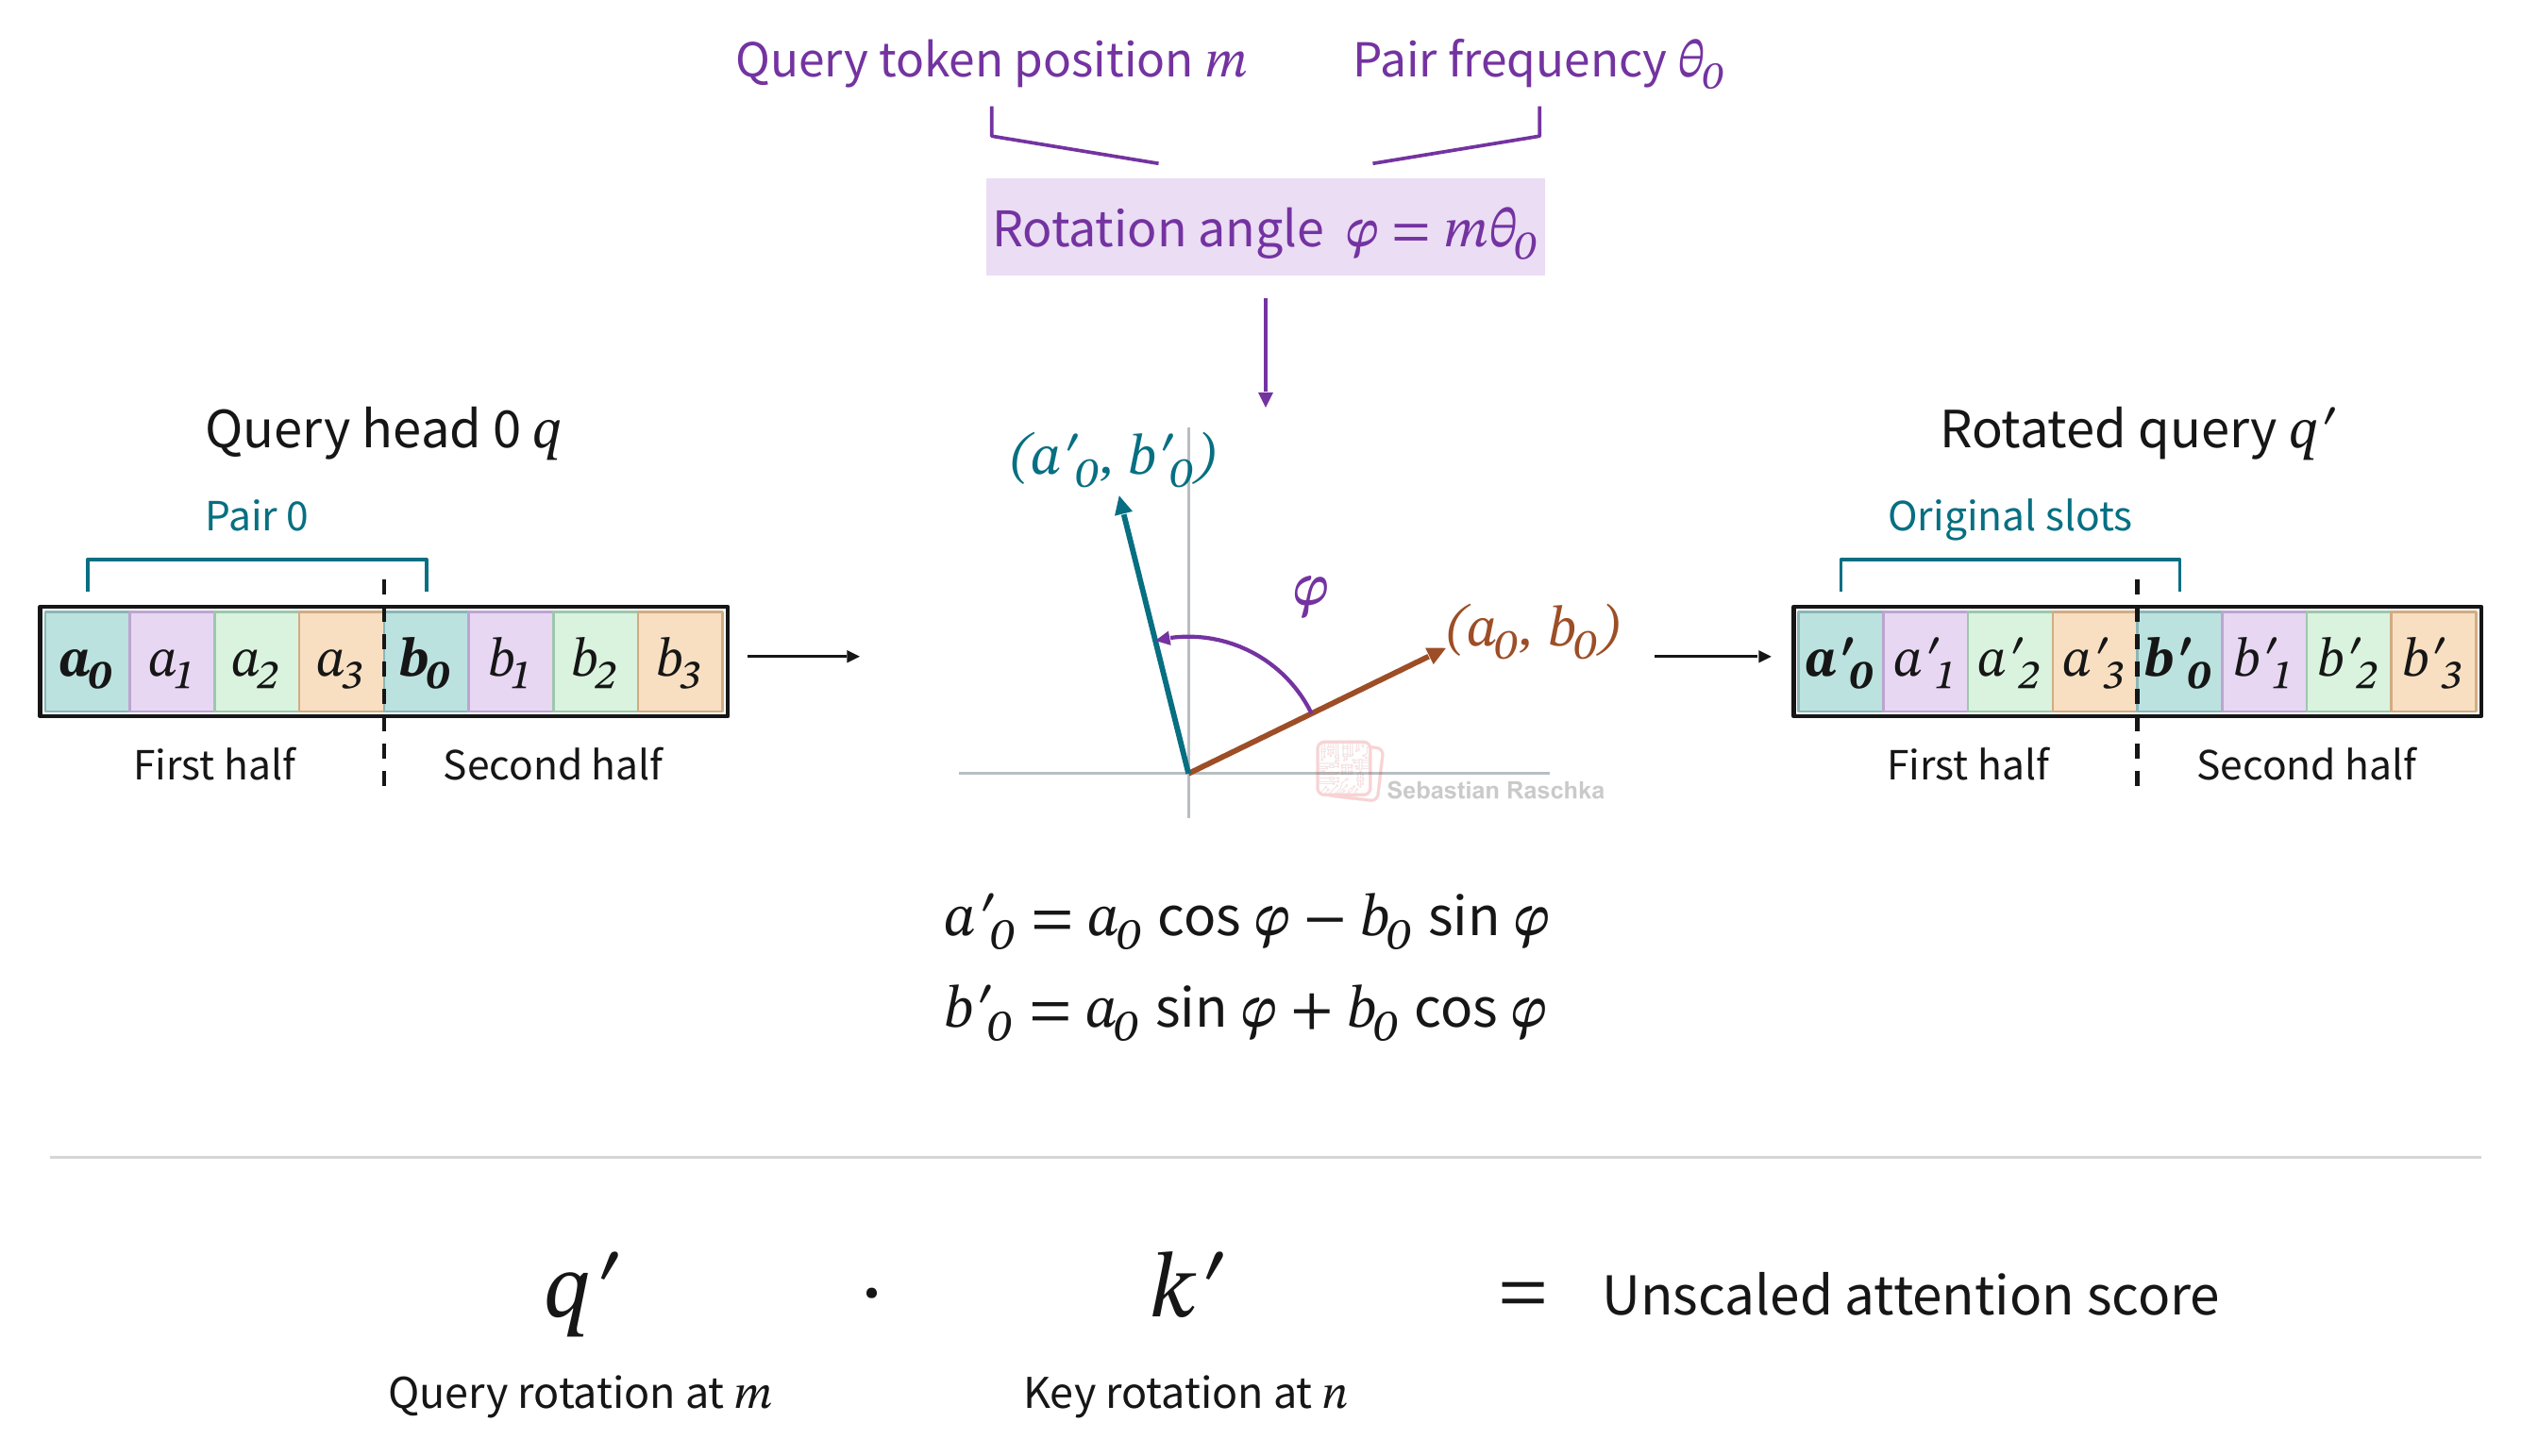
下一节将更缓慢地讲解这些图。
在下面的示例中,我们将使用与之前相同的两个位置。query 来自位置m= 5 处的“the”,key 来自位置n= 2 处的第一个“fox”。由于在此示例中 key 位于 query 之前,因果掩码允许 query 关注它。
为了说明位置的影响,并保持其他一切不变,让我们假设两对都从相同的两个值 (1, 5) 开始。

此外,对于此示例,让我们使用θ= 每个 token 位置 20°(π/9 弧度每位置)。在位置 2,我们将 key 的箭头逆时针旋转 2 × 20° = 40°。在位置 5,我们将 query 的箭头旋转 5 × 20° = 100°。
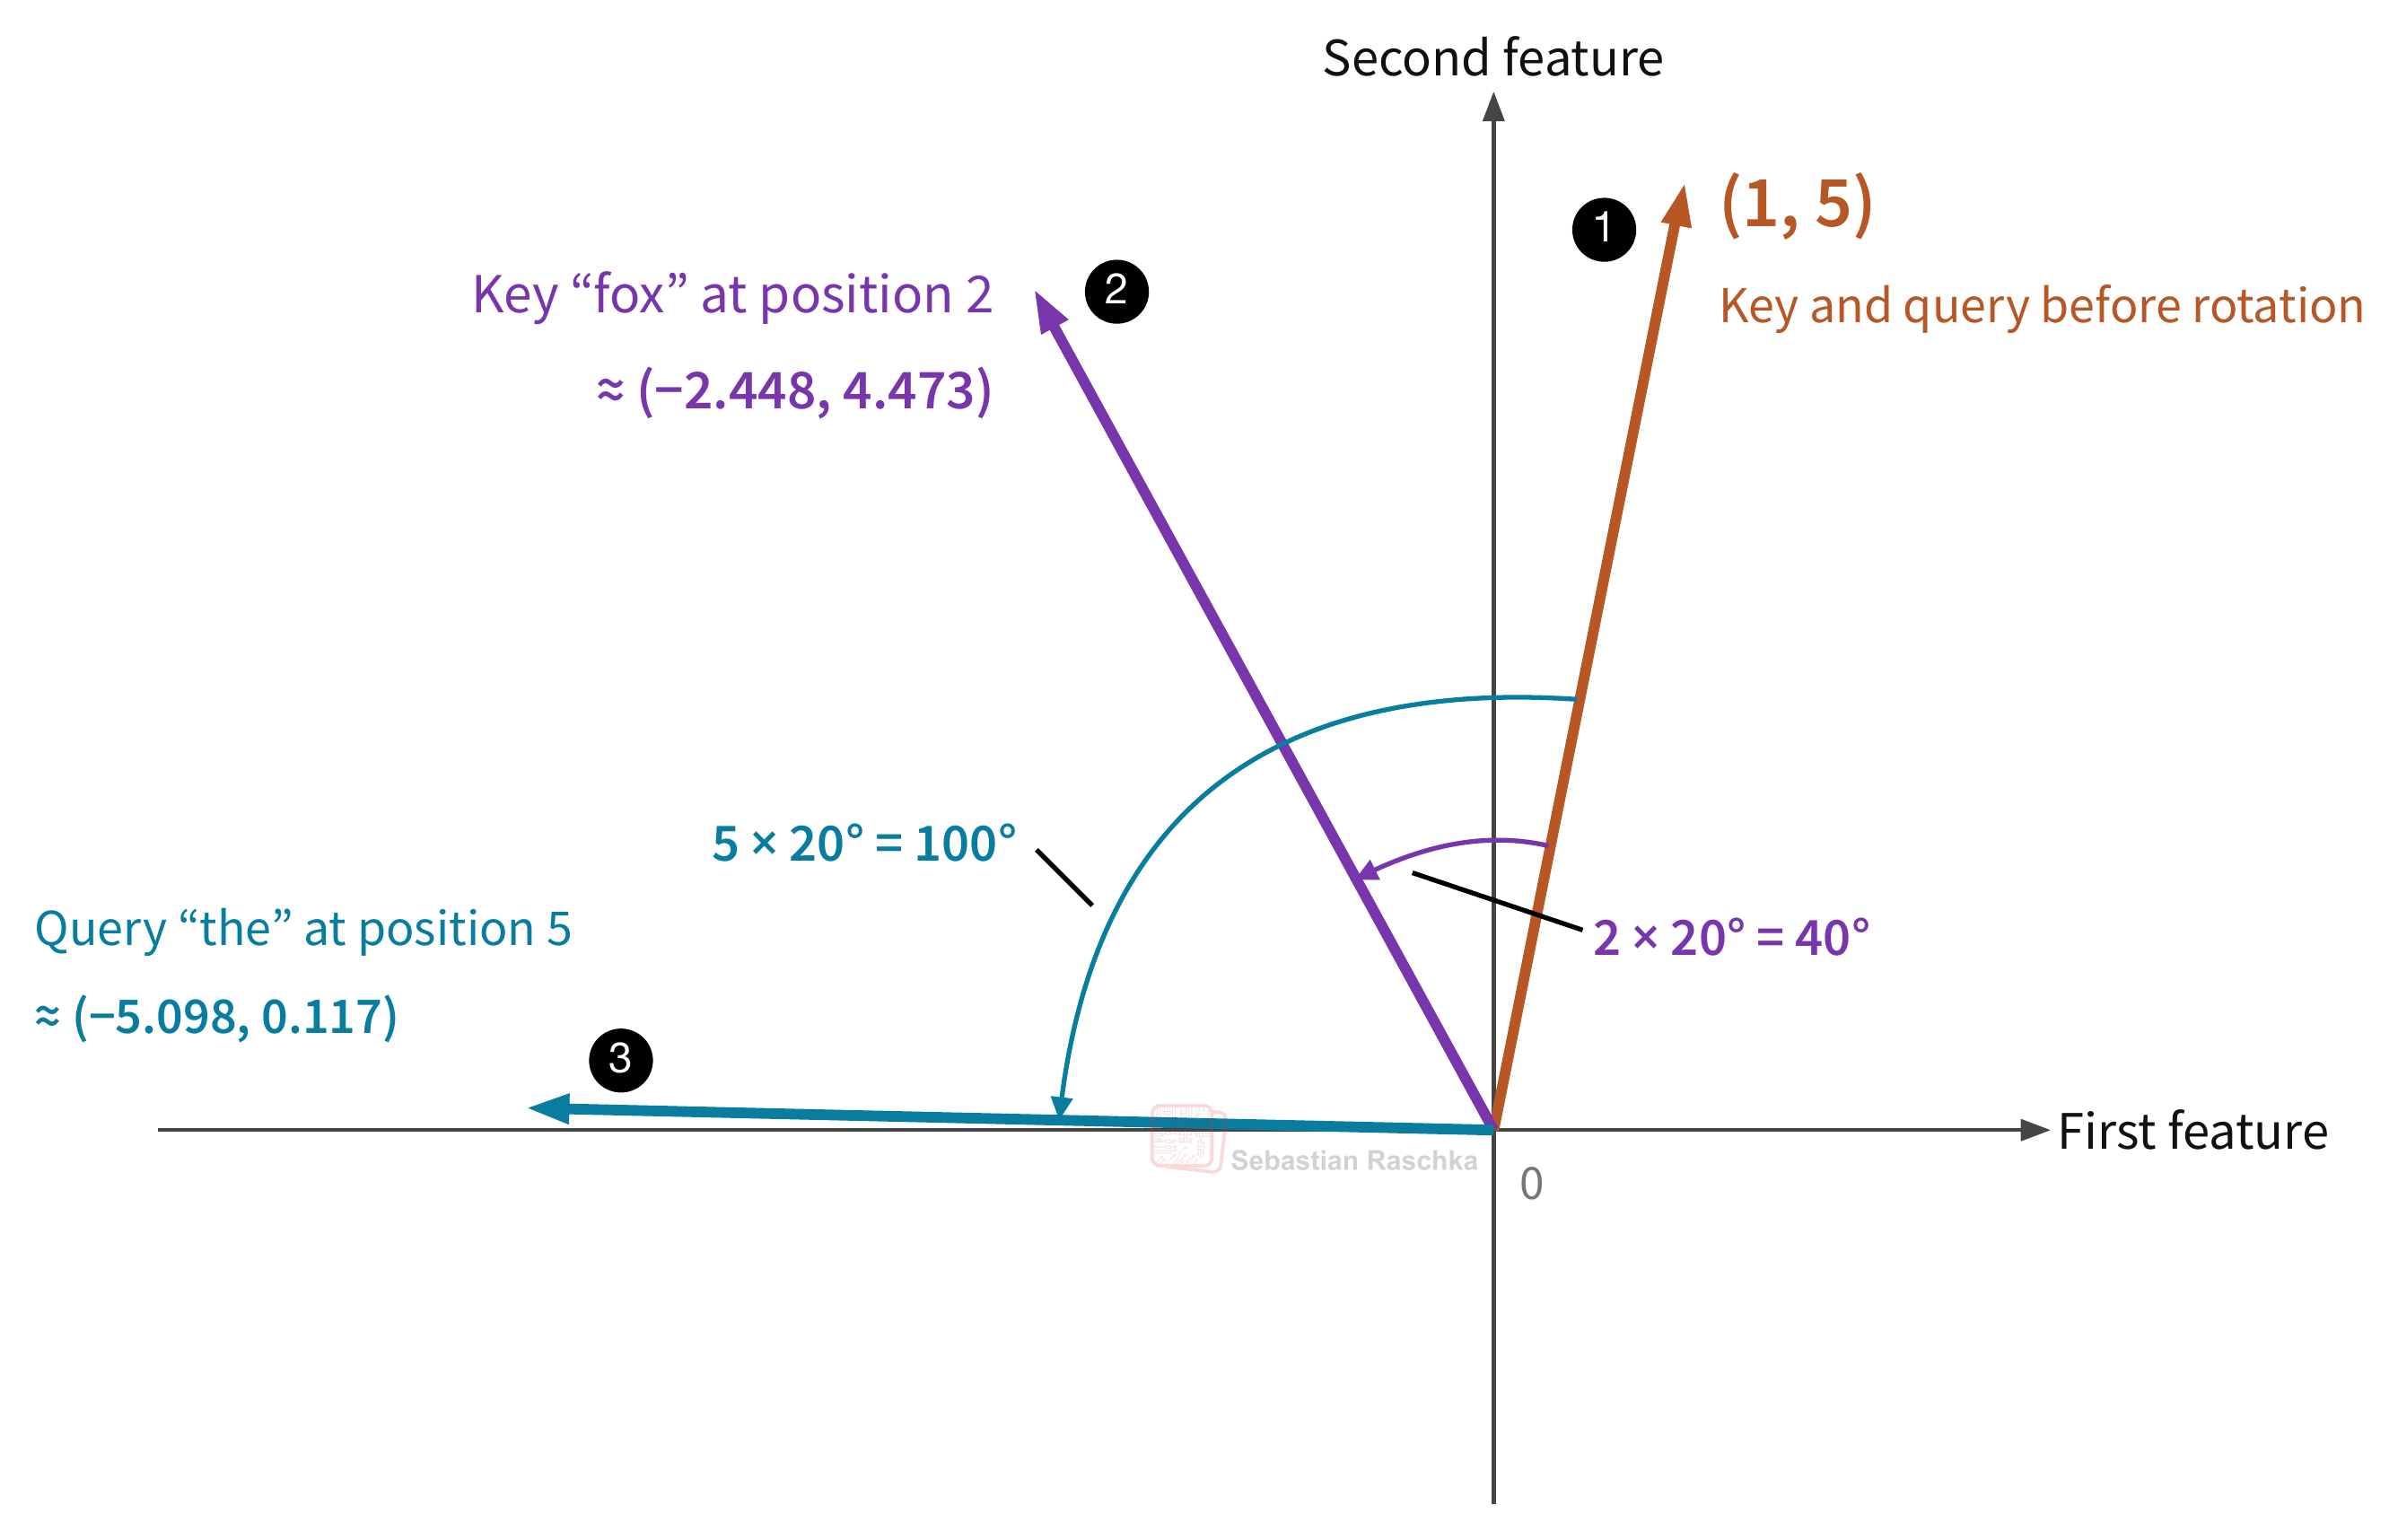
为了说明上图中发生的情况,例如,将 cos 40° ≈ 0.766 和 sin 40° ≈ 0.643 代入图 16 的旋转中,得到新的 key 坐标:

然后,将 40° 改为 100°,使用与上面相同的方程,旋转后的 query 对变为q′≈ (−5.098, 0.117)。但重要的一点是,两个箭头仍然具有长度 √26。只有旋转发生变化,但向量在变换后保持相同的长度。
因此,对于位置a、b处的 query 对 (m),这里的两个操作是。

对于位置n处的 key 对,我们使用相同的方程,其中nθ。

(第 4 节稍后将展示 RoPE 如何计算每个特征对的角频率。)
作为本节的结尾,对于更习惯阅读代码的读者,到目前为止关于 RoPE 的所有图示内容都可以用代码写出来,如下所示:
得到的值如下:
Original key:   (1, 5)
Original query: (1, 5)
Rotated key:    (-2.448, 4.473)
Rotated query:  (-5.098, 0.117)
如果我们旋转 8 维查询(和键)向量中的全部 4 对,就得到下面的向量。(我们稍后会再讨论如何从旋转一对过渡到旋转全部。)
Original key:   (1, 2, 3, 4, 5, 6, 7, 8)
Original query: (1, 2, 3, 4, 5, 6, 7, 8)
Rotated key:    (-2.448, 1.577, 2.951, 3.994, 4.473, 6.125, 7.021, 8.003)
Rotated query:  (-5.098, 0.928, 2.877, 3.986, 0.117, 6.256, 7.051, 8.007)
请注意,如上所示,查询头和键头各有八个特征,我们之前将它们分成 4 对、每对两个元素,例如 (1, 5)、(2, 6) 等等。为简单起见,这里我们只跟踪每个头中的第一对 (1, 5),它由索引 0 和 4 处的条目构成:
Original key:   (1, 5)
Original query: (1, 5)
Rotated key:    (-2.448, 4.473)
Rotated query:  (-5.098, 0.117)
如上所示,在我们的示例中,这些条目在旋转前在两个头中的值都是 (1, 5)。
另外,如上面的代码所示,我们使用记号q=(q1,q2) 和k=(k1,k2) 来表示这两对。要计算它们的点积,使用标准点积公式,我们将对应坐标相乘再相加:

旋转前,这两对的点积为 1 × 1 + 5 × 5 = 26。使用上一张图 18 中四舍五入后的坐标,可得到旋转后第一对的贡献:

我们可以通过用两个向量的长度(图 18 中的箭头)以及它们之间的夹角ϕ来表示点积,从而理解这一点。

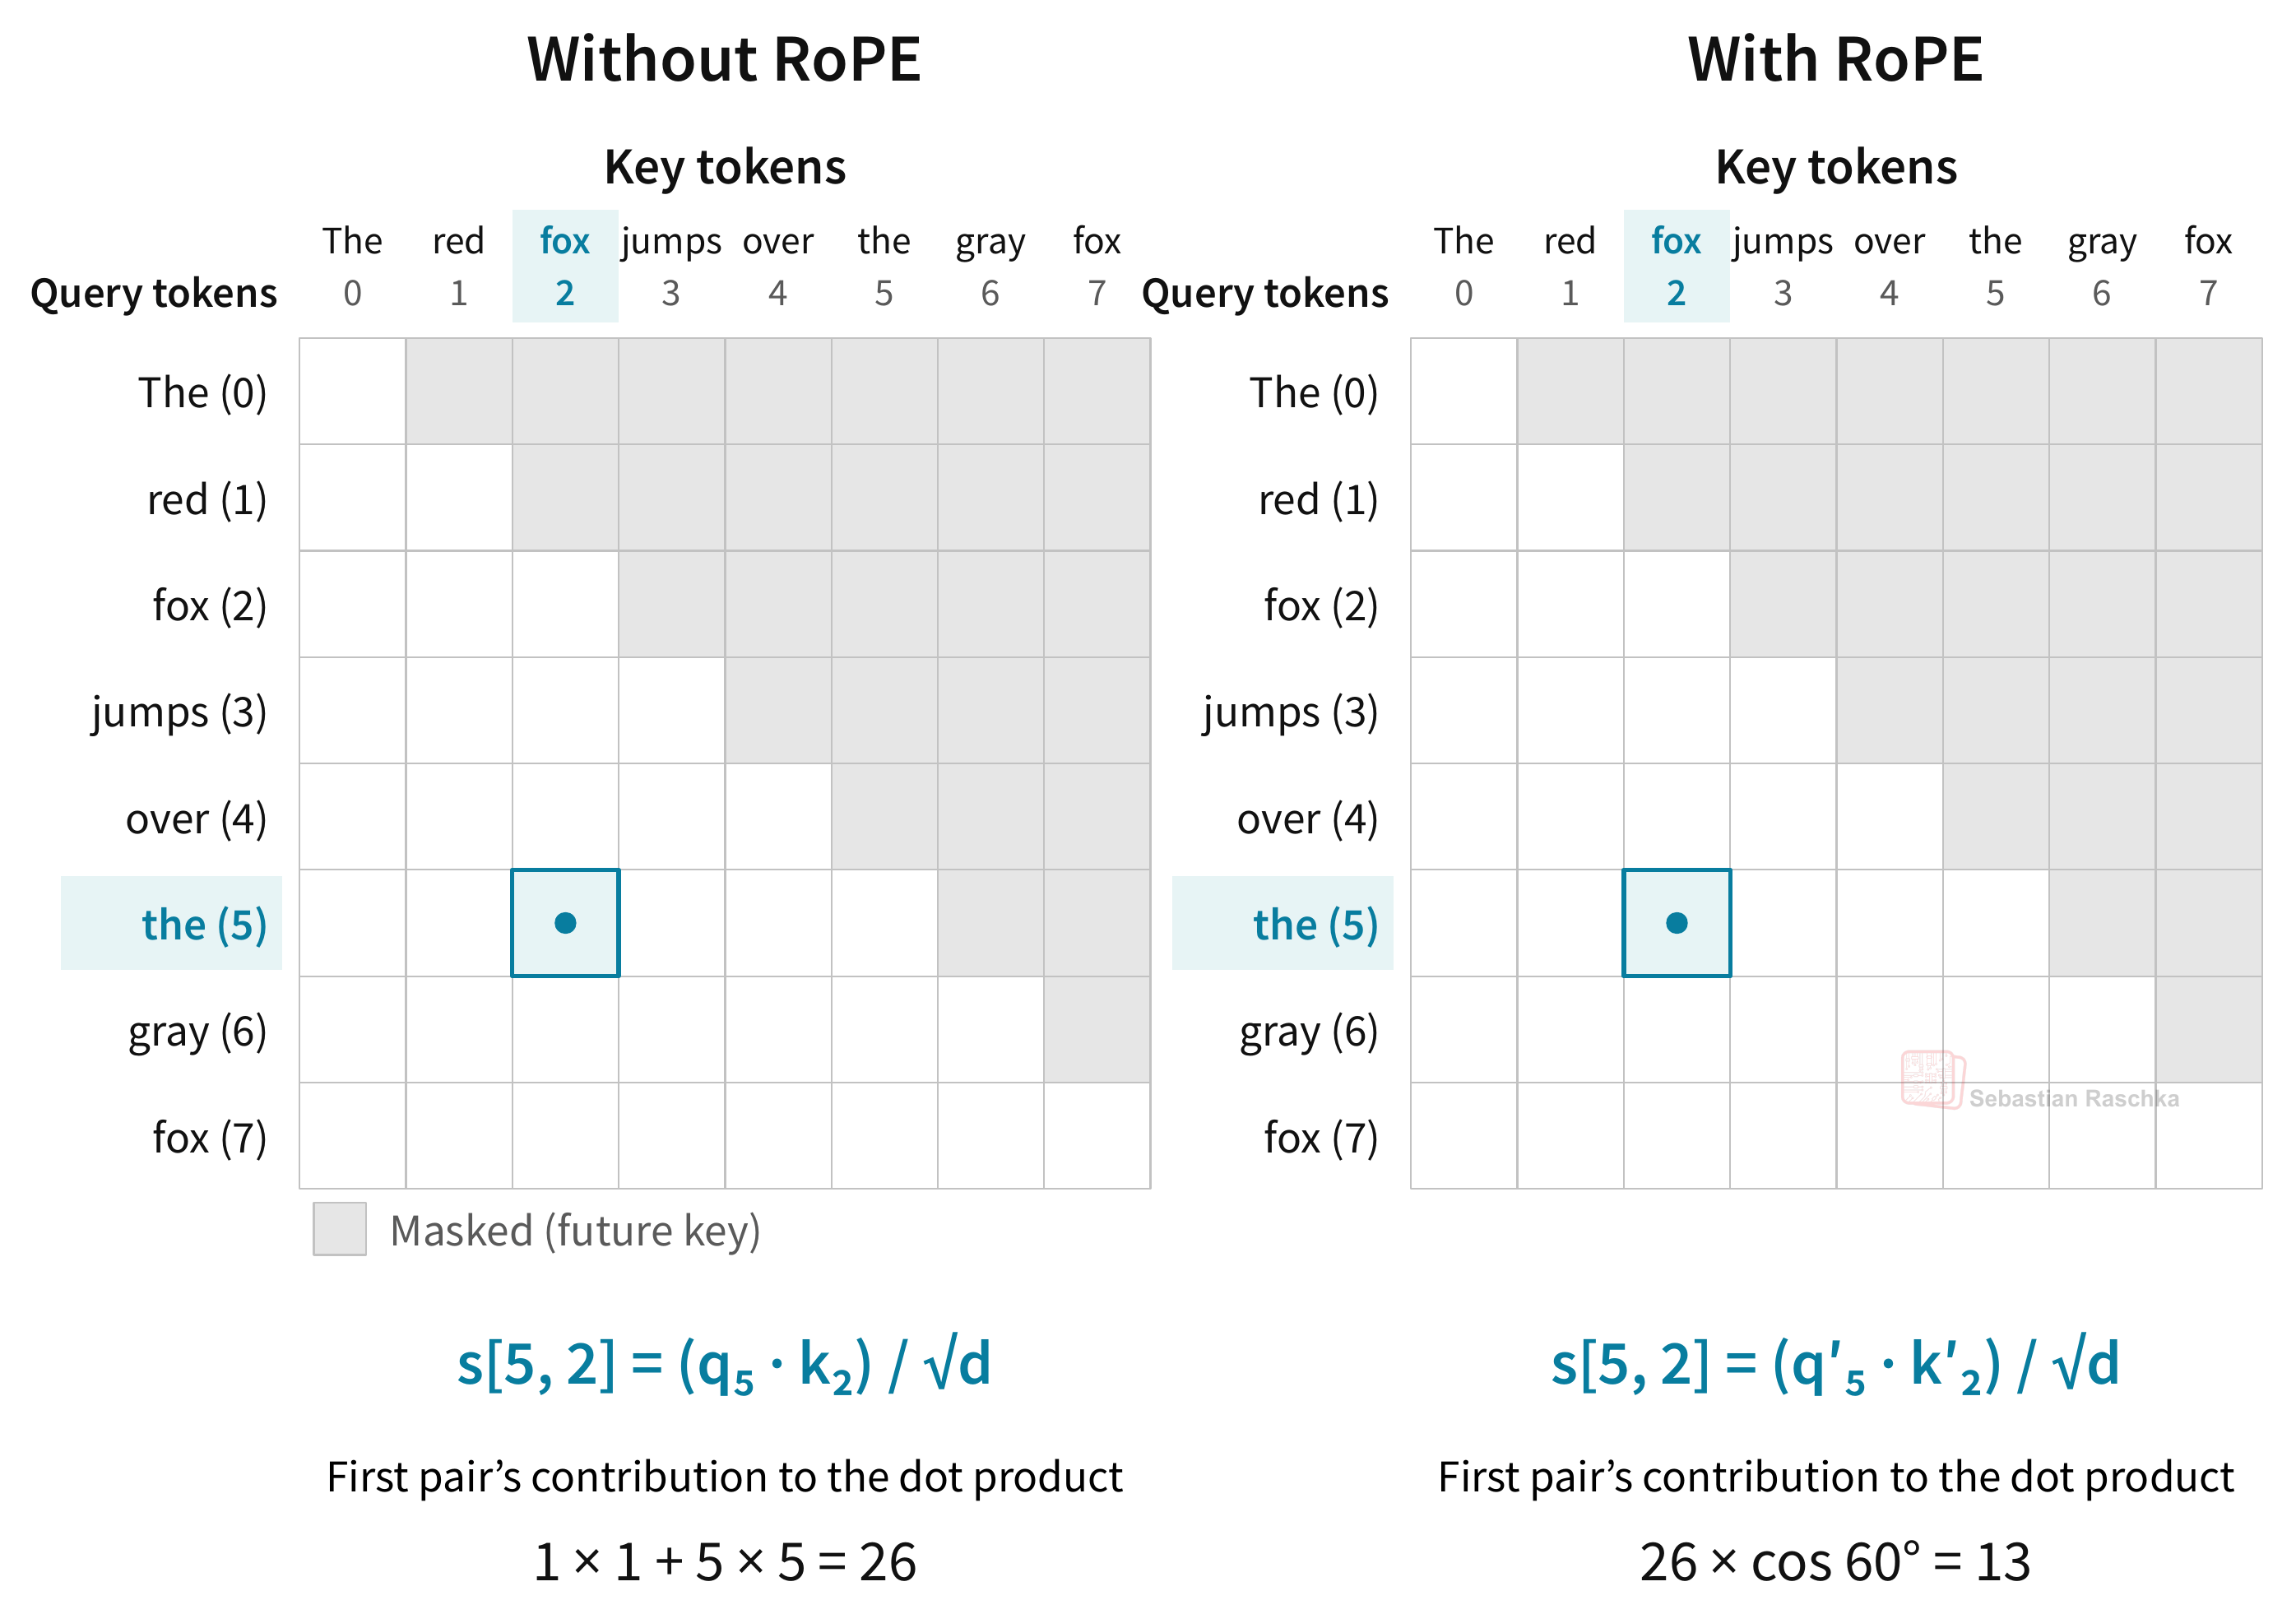
在两种情况下,向量长度都是 √26。查询(位置 5)旋转了 100°,键(位置 2)旋转了 40°。这些向量(箭头)从同一方向出发,因此旋转后它们相隔 60°。它们的精确点积为 26 × cos(60°) = 13。
现在看看如果只把键从位置 2 移到位置 3,但保持其起始坐标 (1, 5) 不变,会发生什么。键的旋转现在从 2 × 20° = 40° 变为 3 × 20° = 60°。查询仍然旋转 100°,因此箭头之间的夹角缩小到 40°,点积从 13 变为 26 × cos(40°) ≈ 19.92。所以,即使起始特征值相同,将键移近一个位置也改变了点积。
为什么这些点积很重要?在注意力中,我们对所有特征对的贡献求和,得到查询-键点积。RoPE 可以改变这些点积,从而改变 softmax 分配给值向量的权重。

在上面的注意力公式中,Q′和K′是包含旋转后的查询q′和键k′的矩阵(针对单个头),V包含值,d是头的维度。
既然我们已经说明了点积的计算,而这是注意力机制的核心,那么让我们回到位置m= 5 和n= 2。如果我们将两个位置都向右移动三个位置,就得到m= 8 和n= 5。每次旋转增加 60°(查询从 100° 变为 160°,键从 40° 变为 100°),然而,向量之间的夹角保持不变。这个特征对的点积仍然是 13。
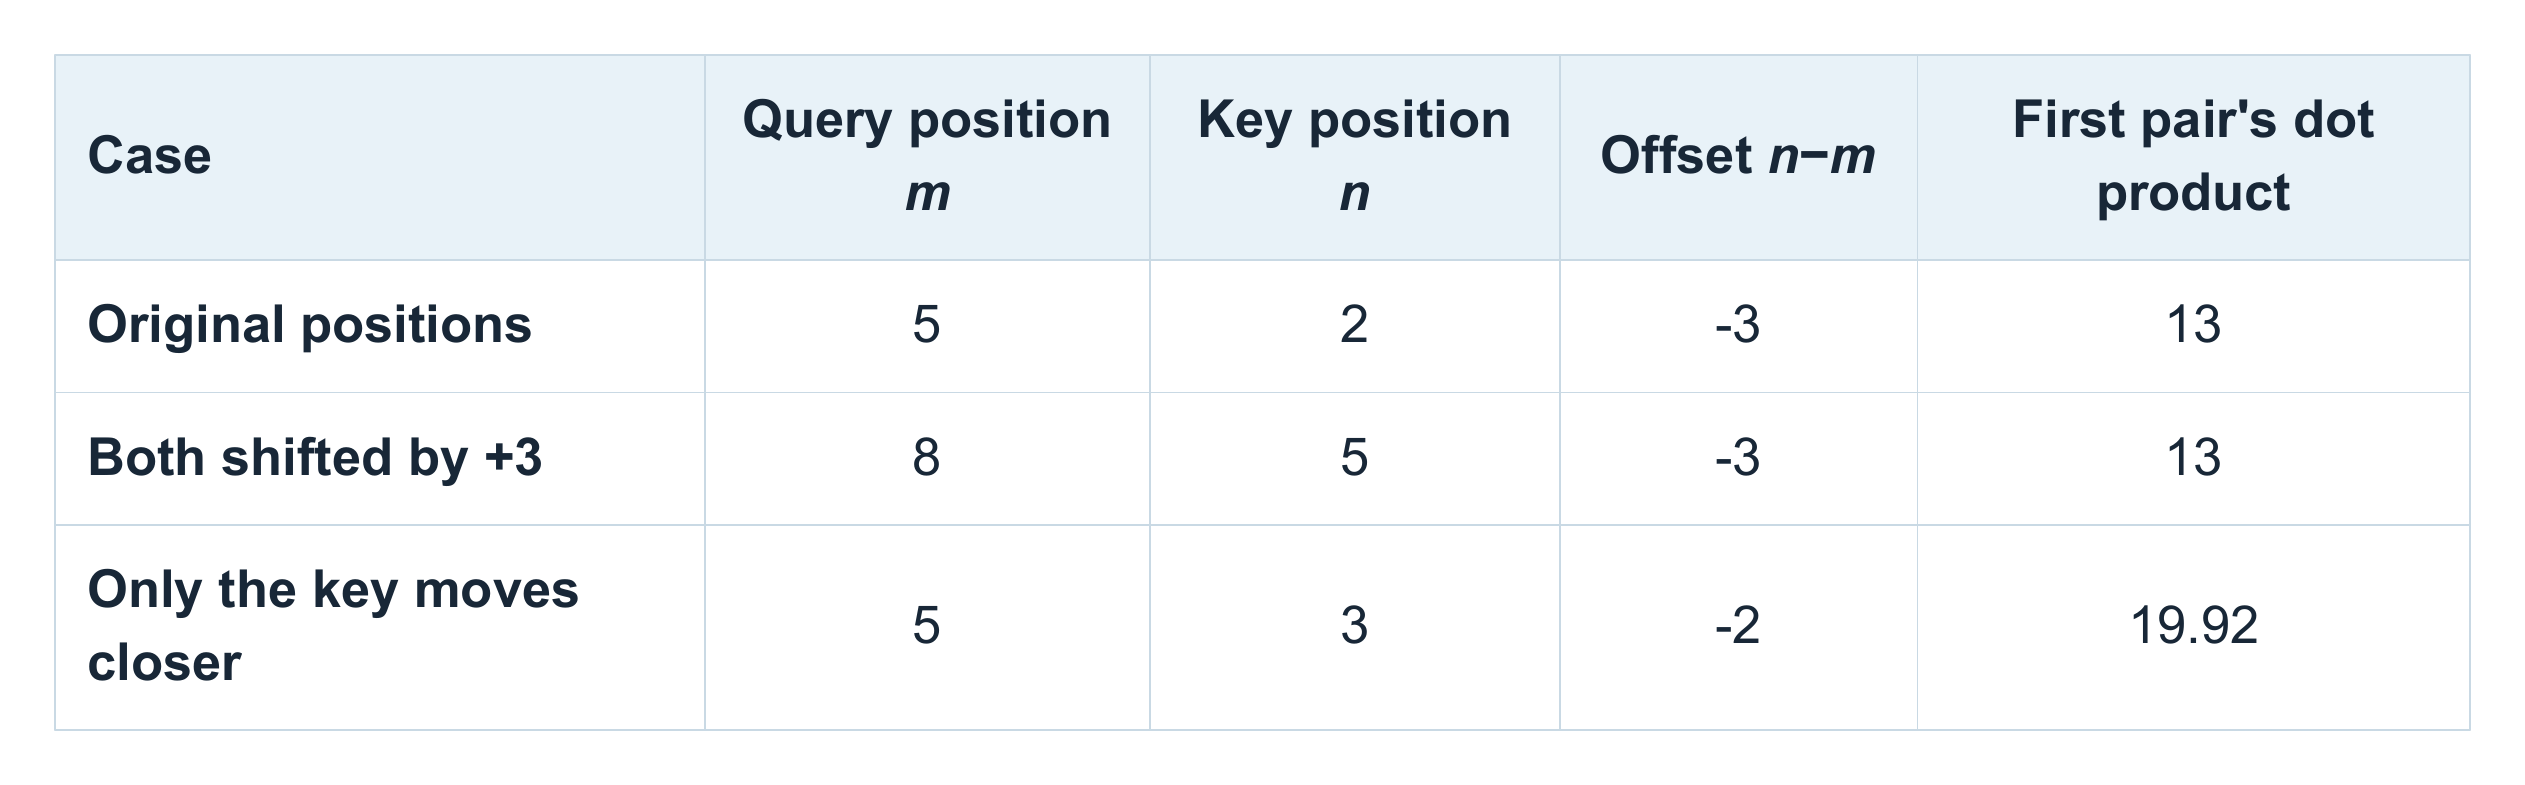
关键在于旋转角度之间的差是

如果我们保持原始的查询和键向量固定,并将两个 token 位置移动相同的量,RoPE 会给两个向量加上相同的旋转。它们之间的夹角保持不变,因此它们的点积保持不变。请注意,下面的图 20 使用了比实际示例更小的角度(每个位置 20°),以保持图片可读。
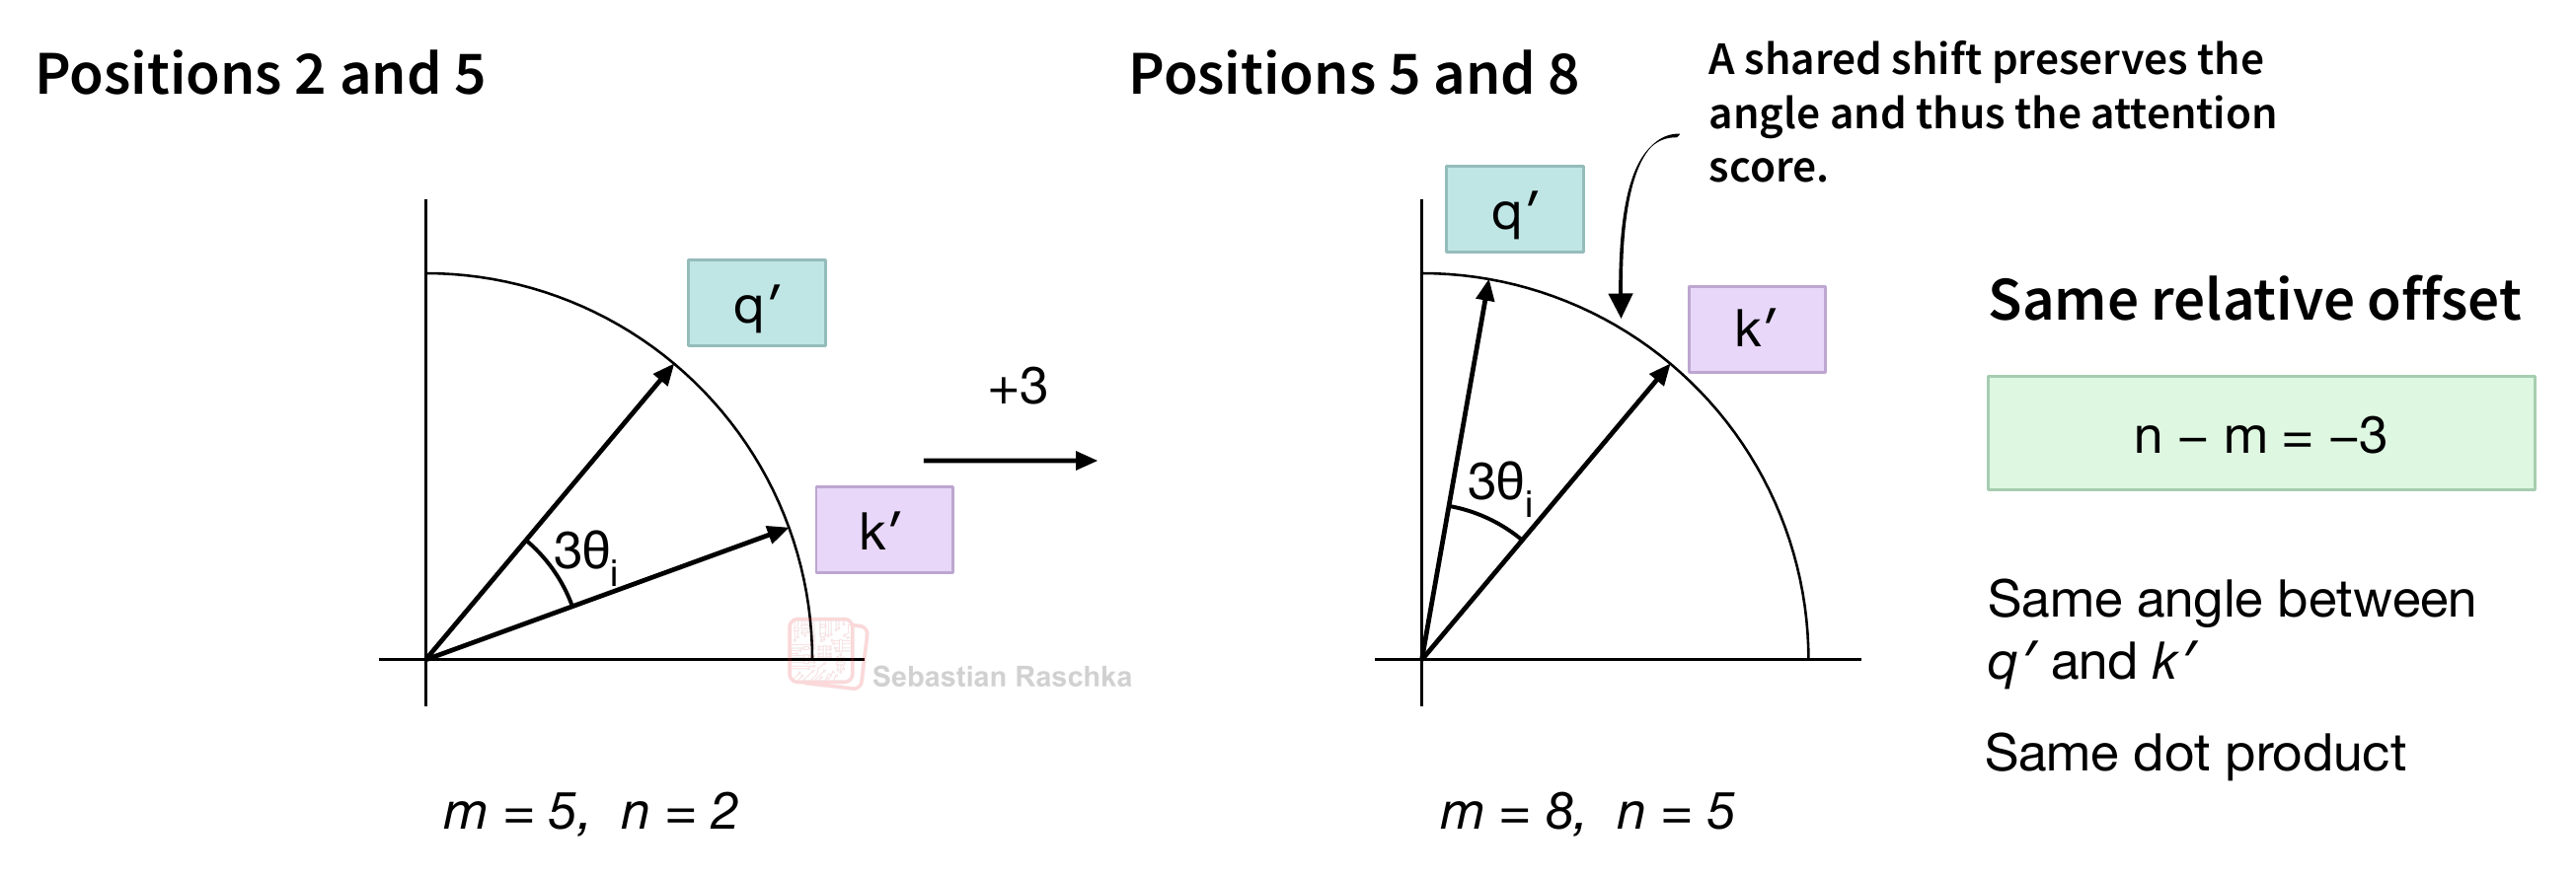
上面的示例和图 20 说明了 RoPE 背后的主要思想。我们使用每个 token 的位置来旋转注意力模块中对应的查询和键。在查询-键点积中,重要的是一个向量相对于另一个向量旋转了多少。对于每个特征对,这种旋转差异只取决于两个 token 之间的偏移量。
为了在整体背景下说明这一点,在图 21 中,每一行收集了一个查询的分数。如果我们考虑第 5 行(“the”的查询)和第 2 列(“fox”的键),那么这两者之间的注意力分数就是查询和键向量两个旋转版本之间的点积。
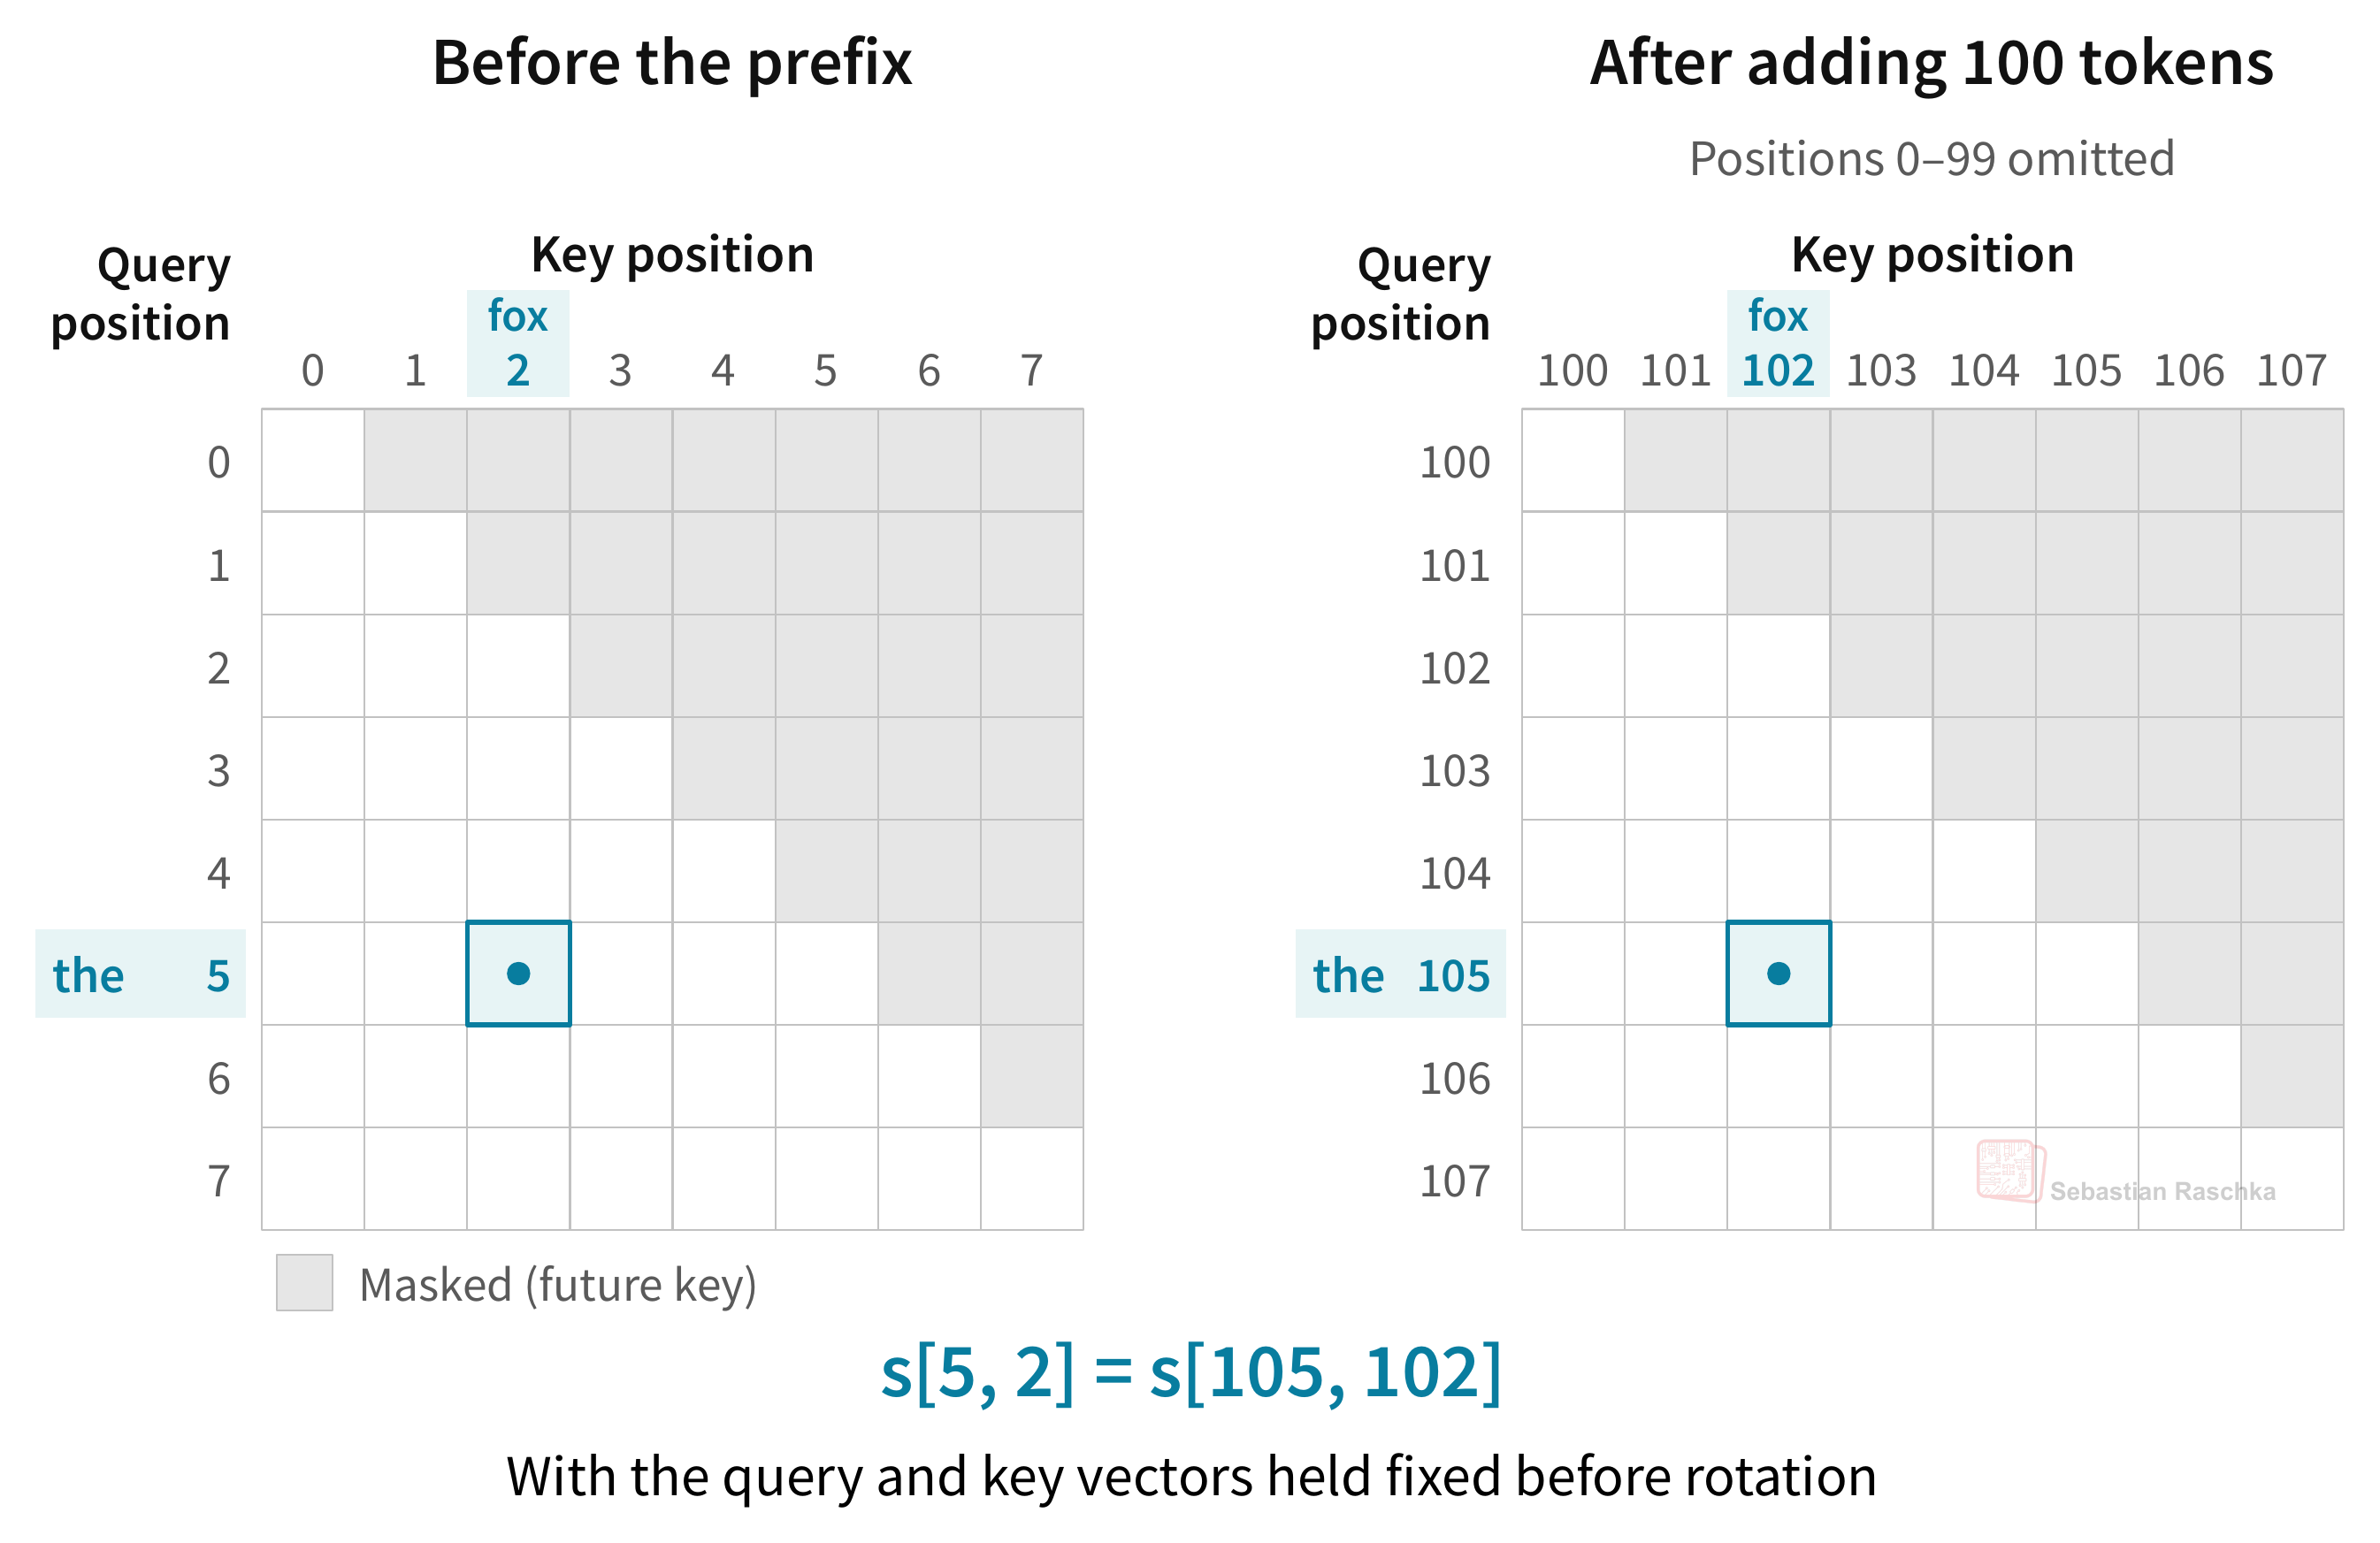
再说一次,这有什么意义?让我们再次考虑“The red fox jumps over the gray fox.”。如果我们在句子前添加 100 个 token(例如 think 系统提示词),第一个“fox”和第二个“the”会从位置 2 和 5 移到 102 和 105。然而,任意长度的前缀都会同等地位移这两个位置,因此它们仍然恰好相隔三个位置。这意味着,每个向量(箭头)都获得完全相同的额外旋转,从而保持它们之间的夹角以及它们的点积不变(假设我们保持未旋转的 query 和 key 向量固定;在真实模型中,100 个 token 的新前缀会通过改变 token 所关注的内容来改变这些向量)。
图 22 在注意力分数矩阵中追踪了这一对比。右侧面板显示了添加前缀后该句子的行和列。在我们的玩具示例中,第一对仍然对点积贡献 13。
你可能还记得,在原始 transformer 的正弦编码中,固定偏移也对应于每个正弦/余弦对内的固定旋转。但这种共享旋转仅适用于位置向量(加到输入向量上),而不是注意力机制内部的 key 和 query 向量。
图 23 比较了这种位移在我们目前涵盖的三种方法中所带来的变化。
为了看清相对偏移如何影响点积,我们聚焦于 query 和 key 中的一个特征对。现在让我们把全部四对放在一起,看看 RoPE 如何在一个注意力头中旋转完整的八特征向量。(如果技术细节太多,请随意跳过本节。)
图 24 从图 17 结束的地方继续。我们旋转四对中的每一对,然后将结果按 query 的原始特征顺序放回。
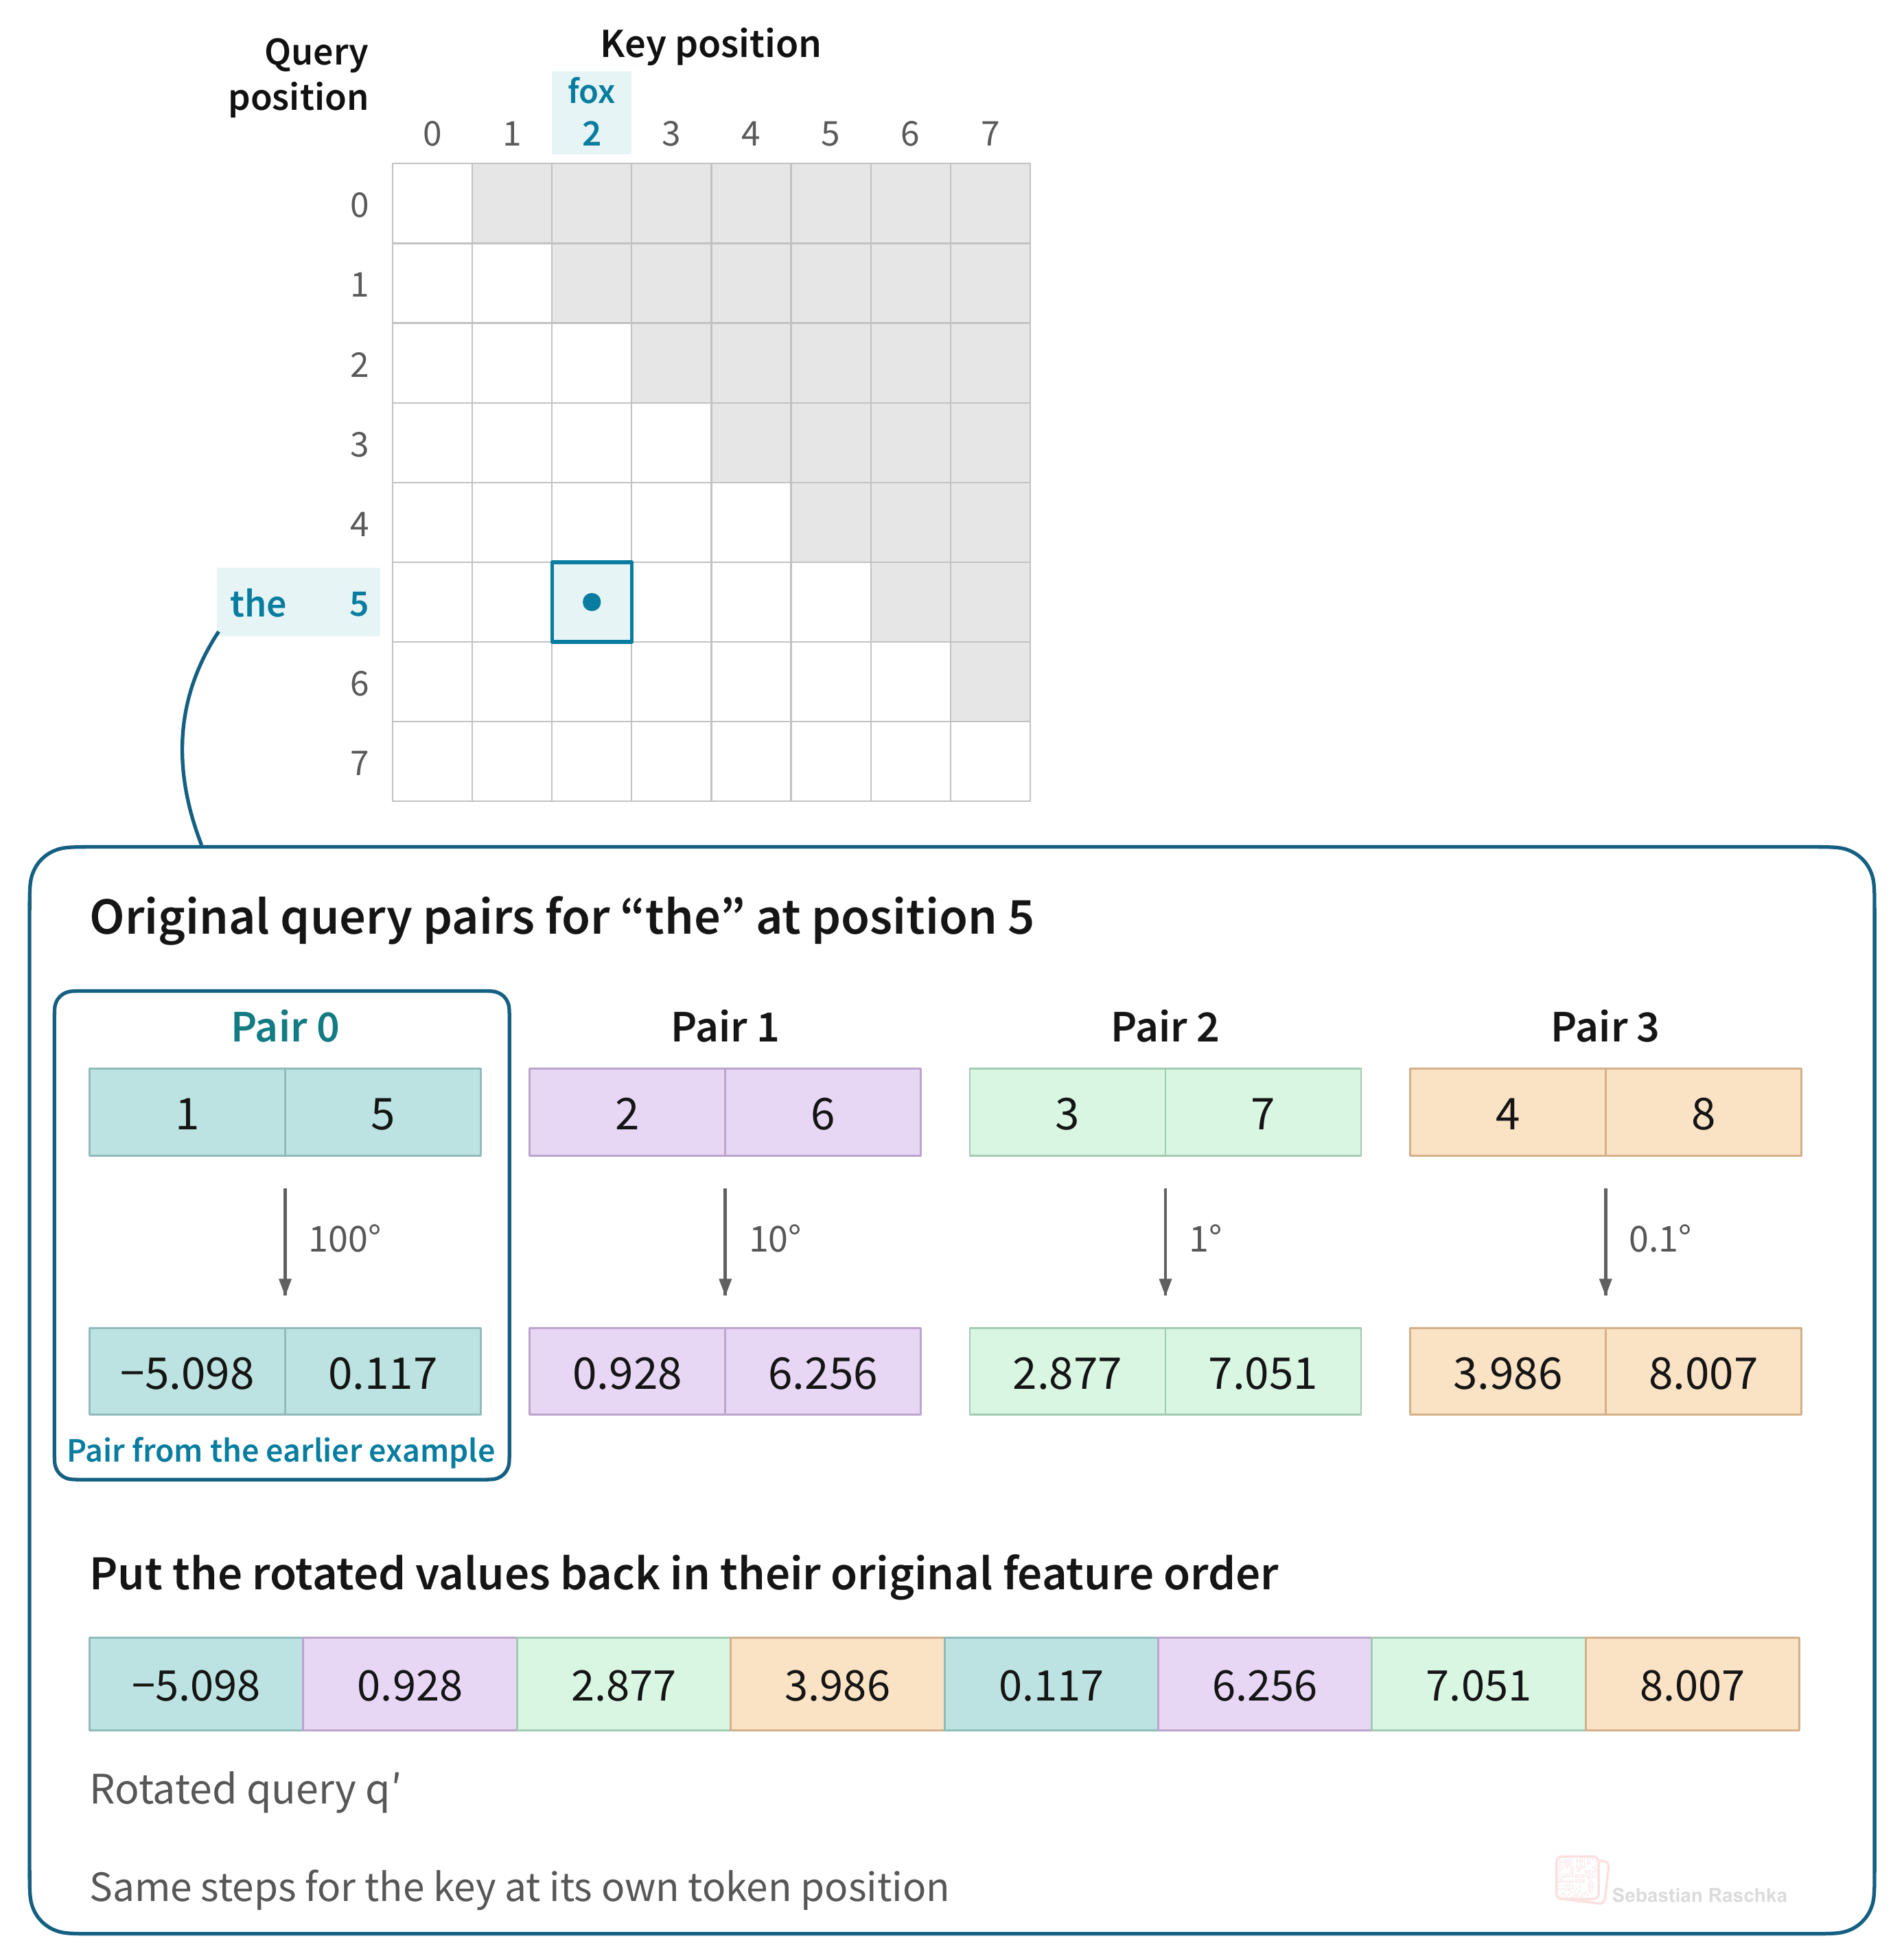
上图 24 展示了旋转后的查询q′(位于底部)。类似地,我们可以得到旋转后的键k′只需在键的位置重复相同的步骤。
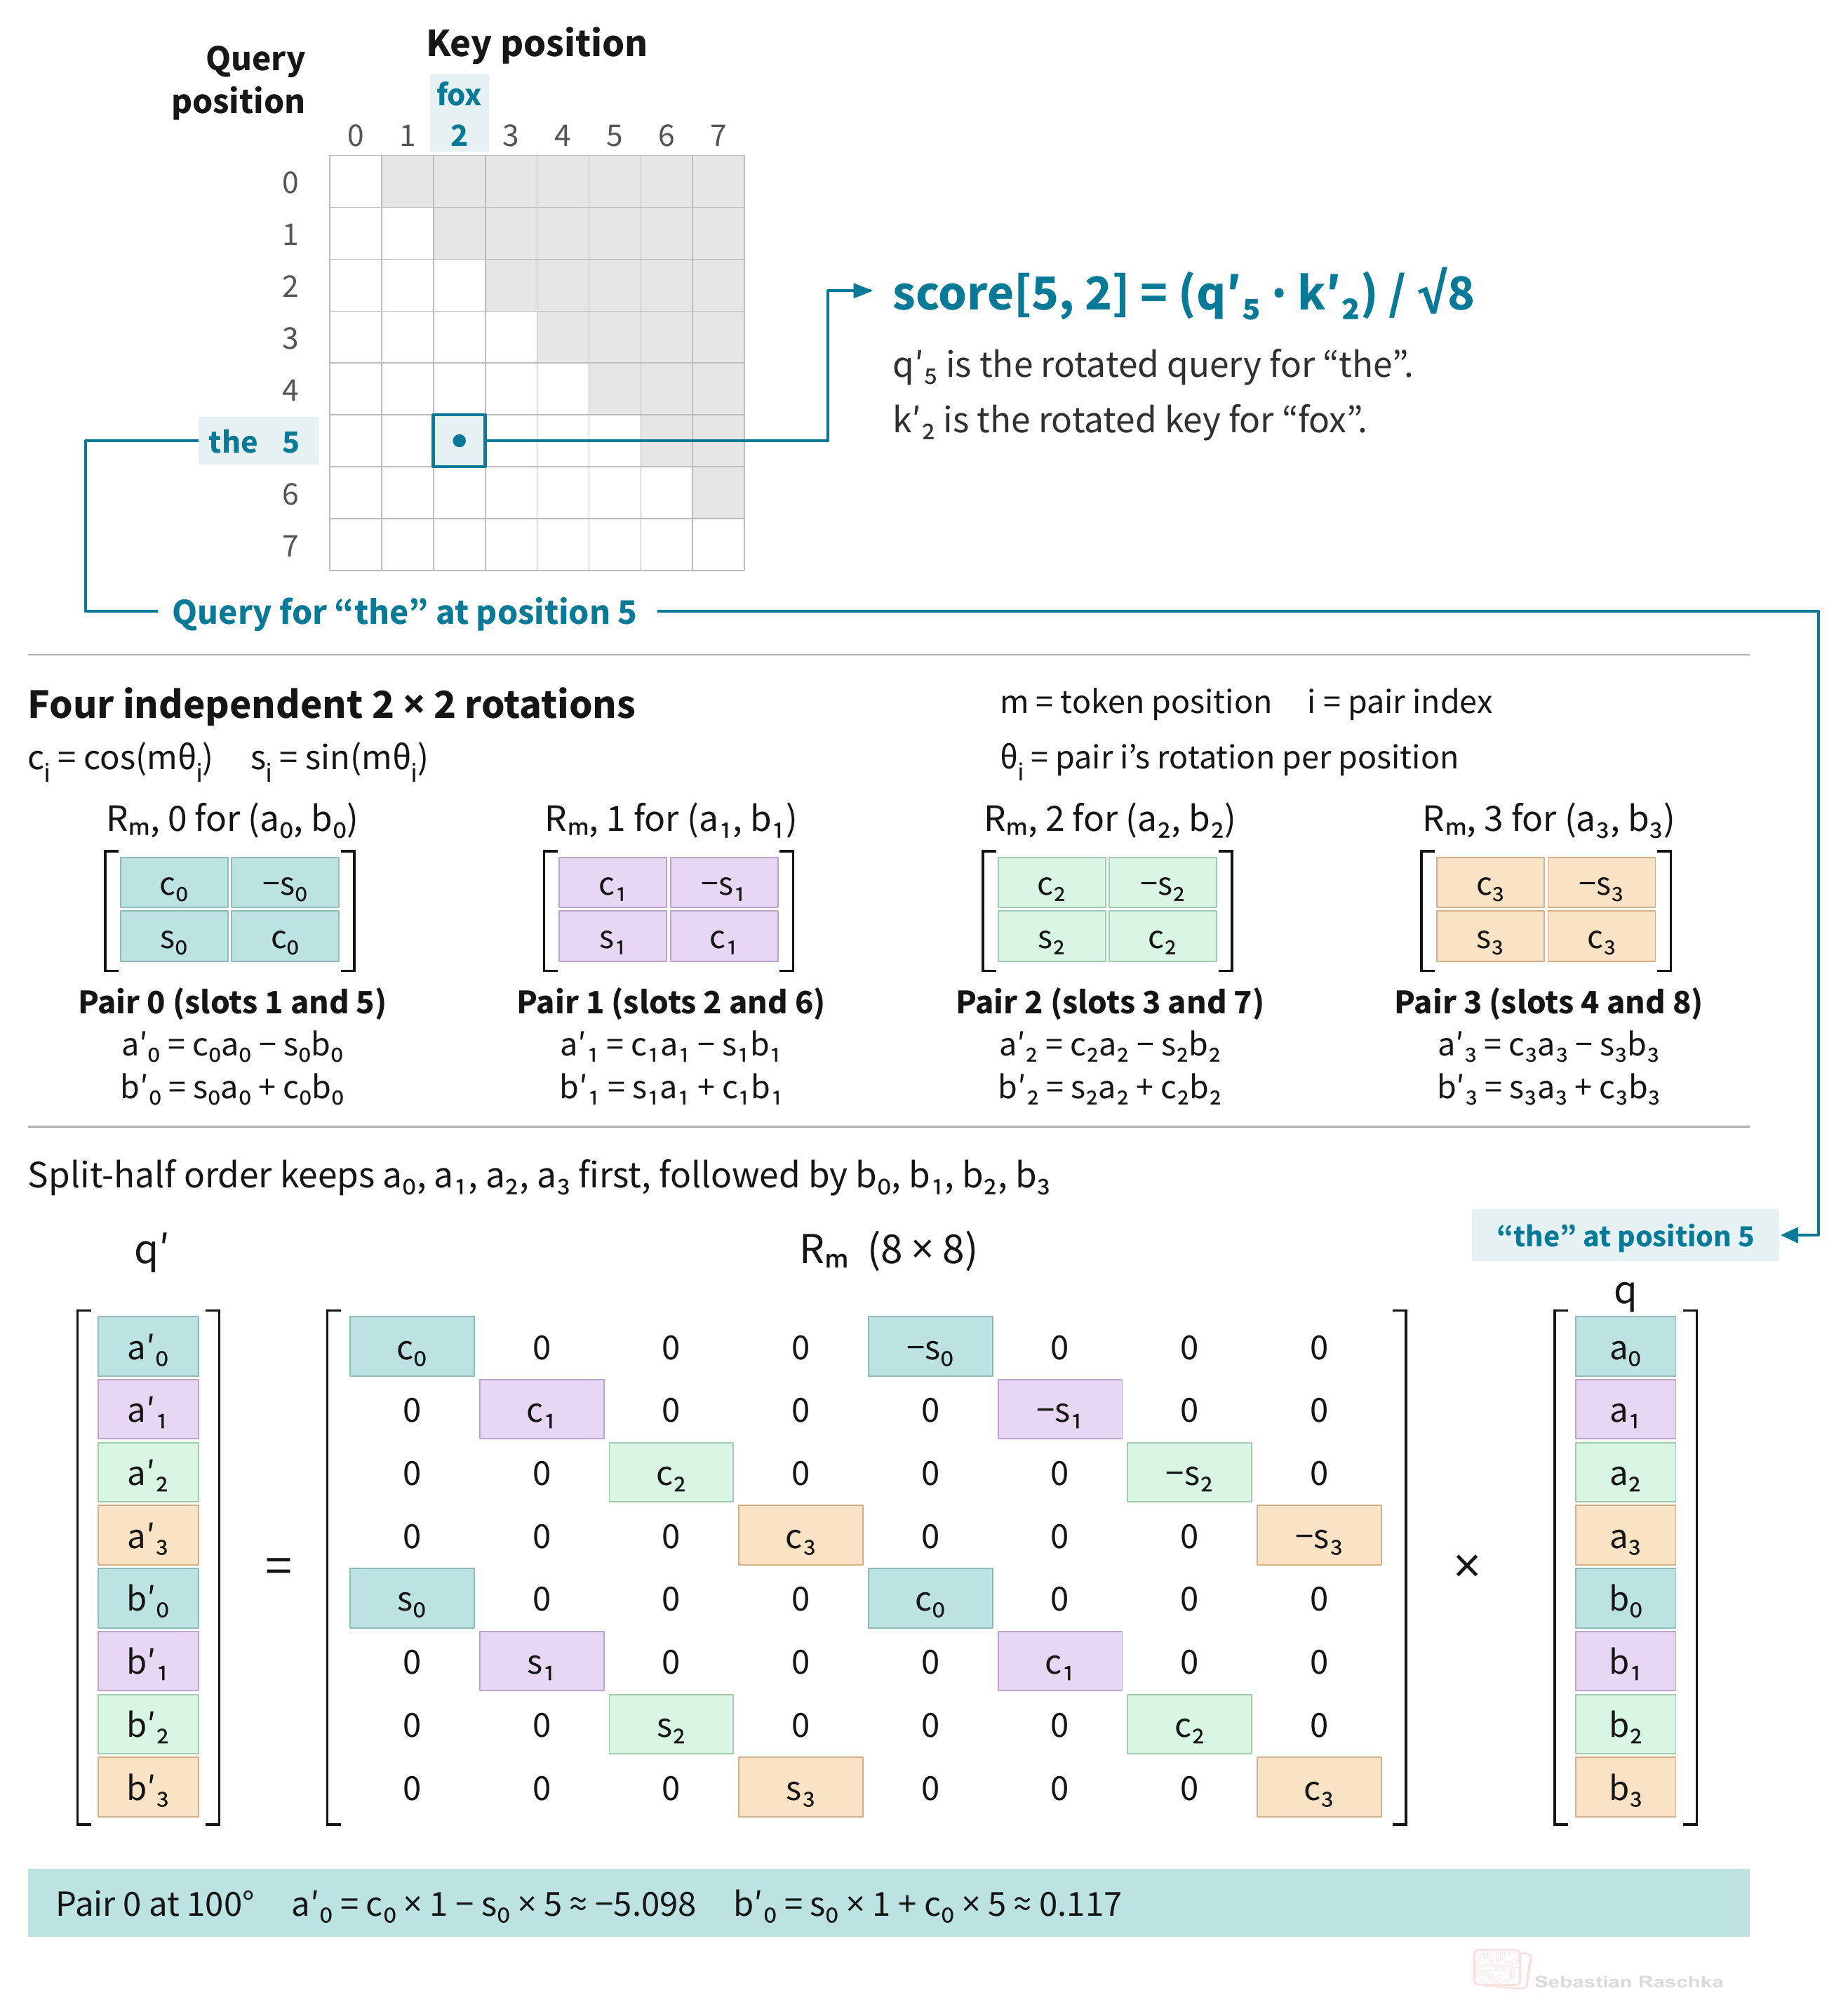
回顾第 3.3 节中的两个方程。对于查询对i其输入值为(ai,bi),令ci= cos(mθi)且si= sin(mθi)。这些是该对在查询位置m处的旋转角的余弦和正弦:

下图 25 将四对之间的同样四次旋转表示为一次矩阵乘法,q′=Rmq。
一个完整的注意力头使用多个频率,使得某些特征对随位置变化得更剧烈(用 RoPE 的术语说是“快”),而另一些则变化得更平缓(“慢”)。这与原始 transformer 正弦编码中多频率的作用相同。
然而,这些频率并非由我们手动指定,对于具有d个特征的头,标准完整 RoPE 会为其d/2 对中的每一对计算一个频率,如下所示:

这里,
d是头维度(它必须是偶数,以便所有特征都能成对排列)。
i是对索引;其范围为 0 到d/2−1。
b是选定的基值(超参数),决定频率的间距。
θi是对i的频率,单位为弧度每 token 位置。
原始的RoFormer 论文使用b= 10,000,借用了原始 transformer 的频率公式,用头维度d代替嵌入宽度dmodel。
例如,当头维度d= 8 且基值b= 10,000 时,我们得到频率 [1, 0.1, 0.01, 0.001] 弧度每位置。
如果你想在完整模型中查看 RoPE,我推荐看看我的端到端Qwen3 从零实现。
由于代码可以是解释和理解概念的有效媒介,如果你感兴趣,下面的小节将带你了解我们目前所涵盖的核心部分。否则,请随意快进到第 6 节,关于现代架构中的位置选择。
因此,对于以下代码片段,我们将使用前面提到的相同的分半旋转约定(交错约定也会涵盖,不用担心)。首先,我们会将其应用于一个查询向量,然后在注意力机制内部将其用于查询和键。
首先,让我们复用图 24 中的 8 特征查询。为方便起见,下面是其旋转前的四个特征对。

在之前的非编码示例中,为了保持数学简单,我们为第一个对选择了每个 token 位置 20° 的频率。在这里,我们将使用上面第 4 节中的原始 RoPE 公式,θi=b−2i/d,其中头维度为d= 8,基数为b= 10,000。
图 26 展示了这两个函数如何协同工作来应用这些旋转。
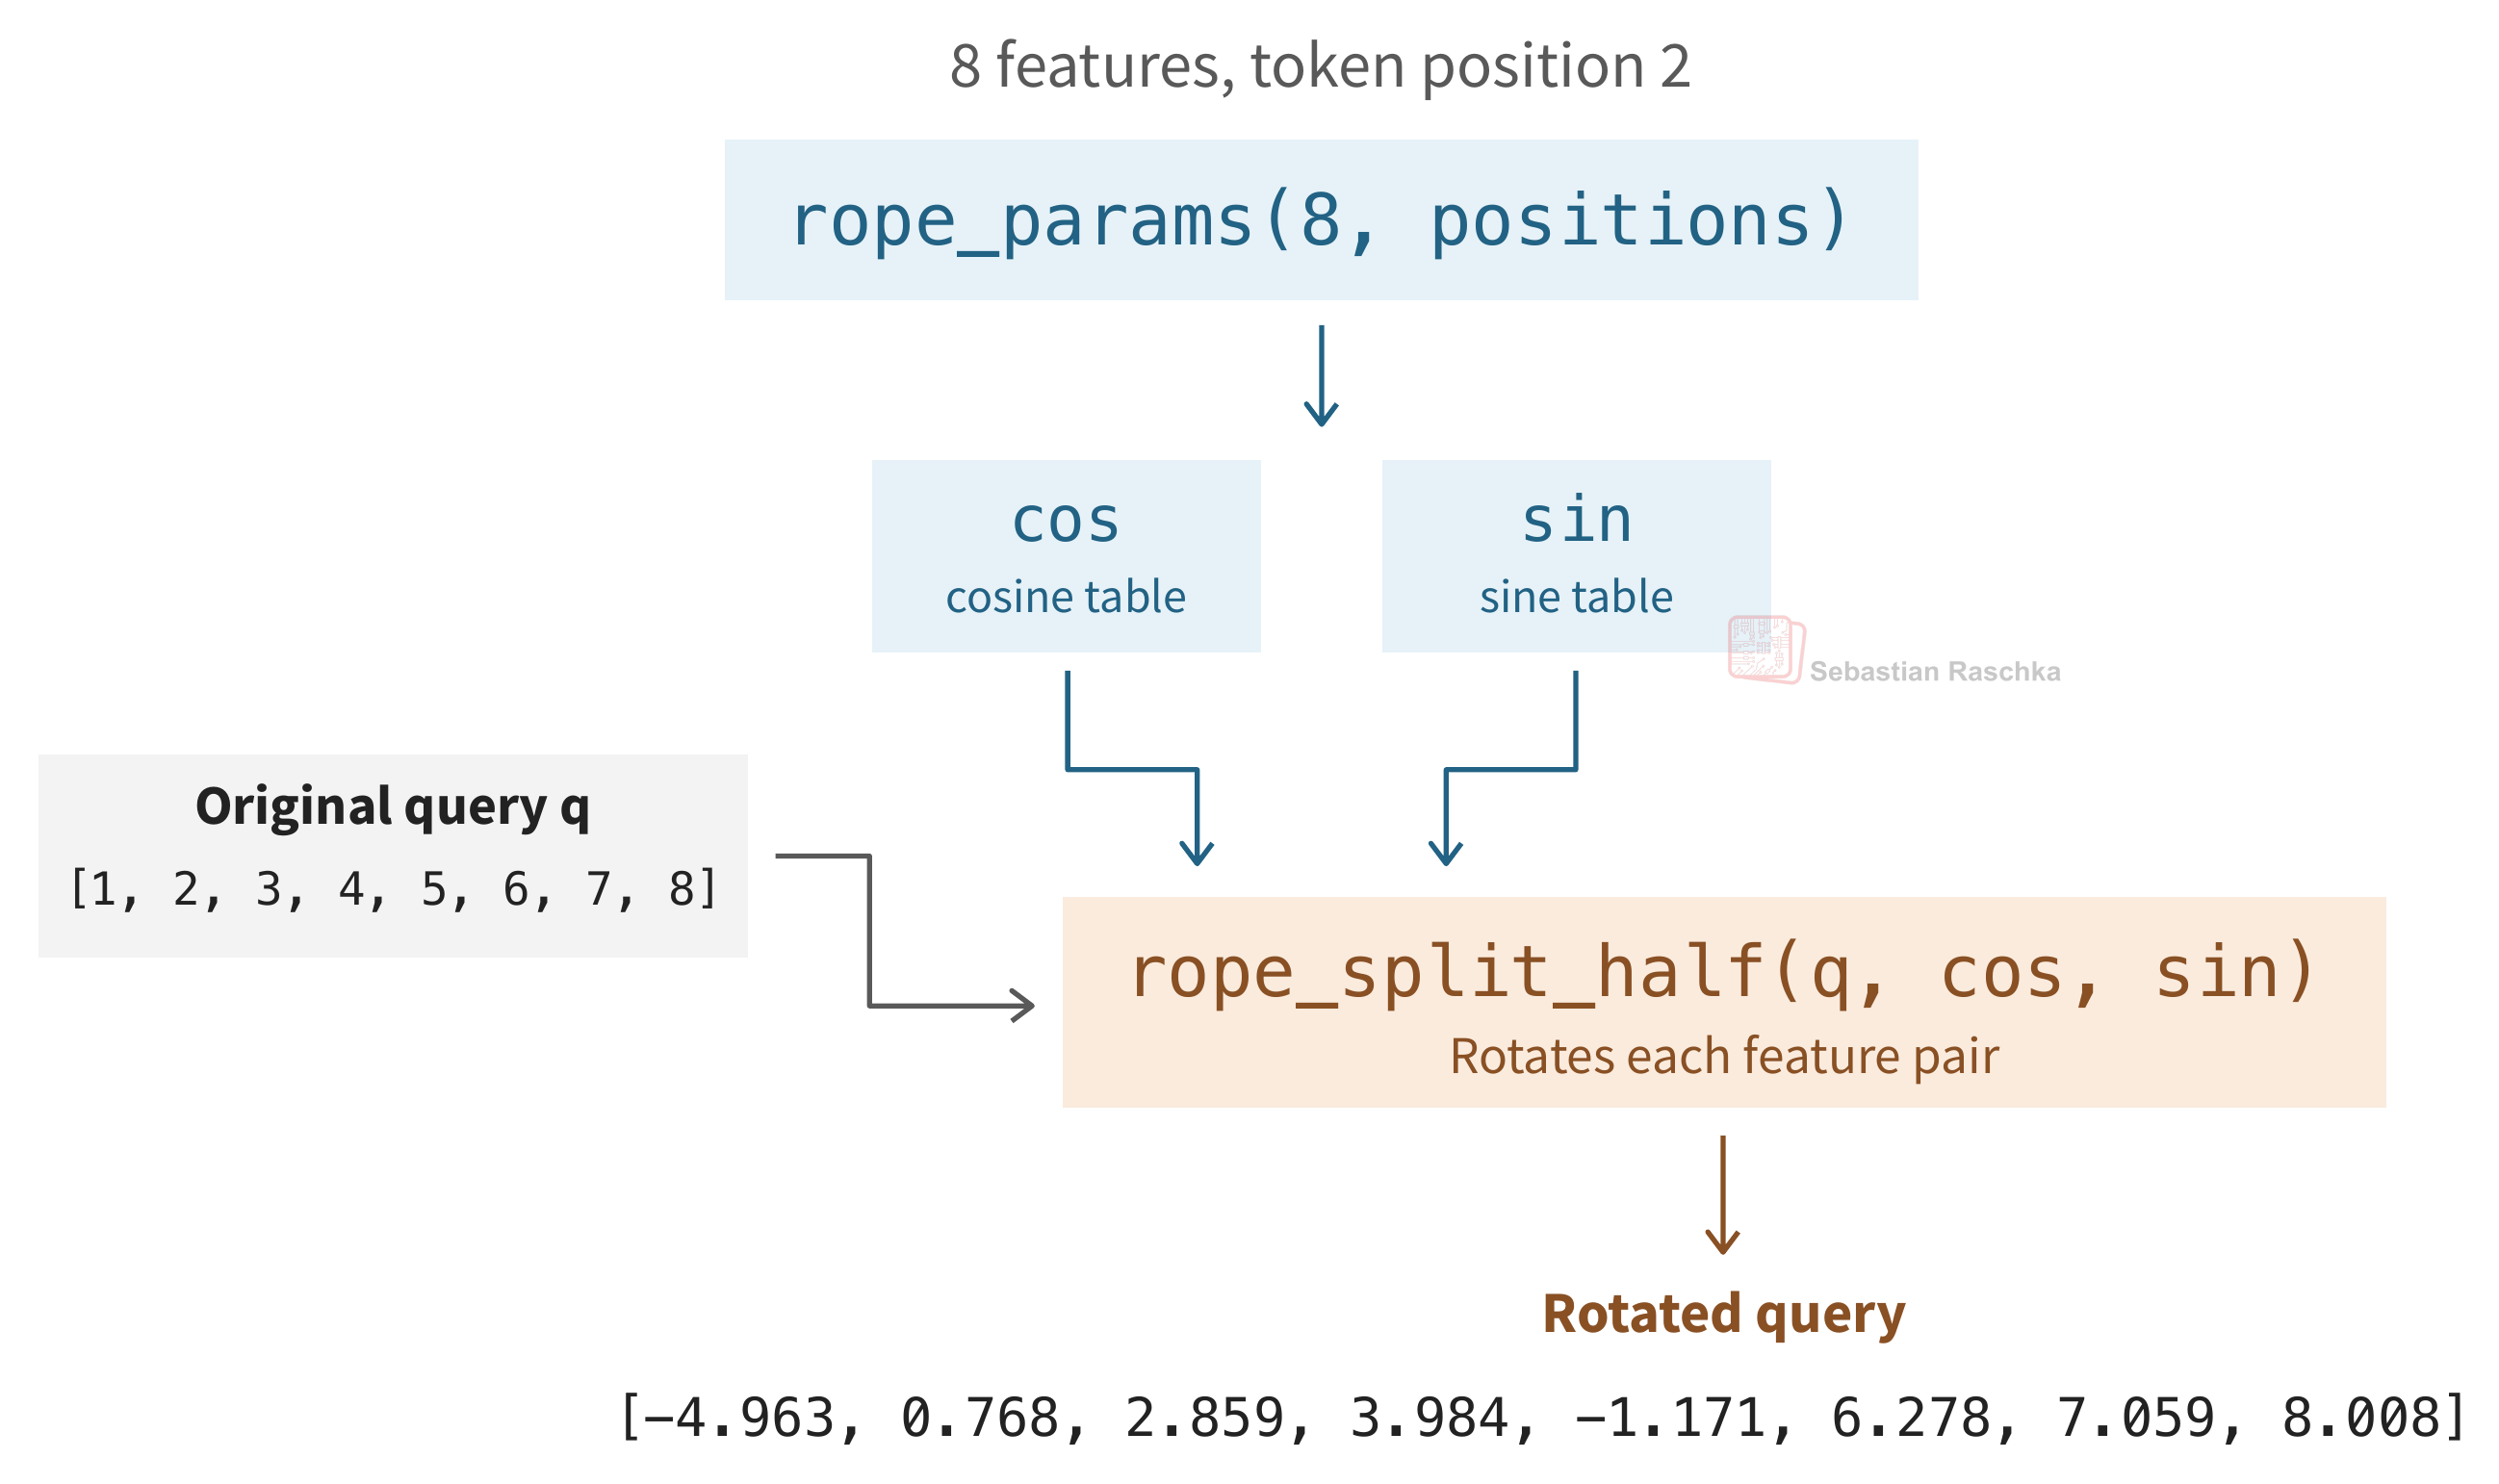
如上图所示,首先,rope_params确定每个对旋转多远,返回两个存储这些角度的余弦和正弦的“表”。或者换句话说,rope_params计算每个旋转角度的余弦和正弦,这取决于 token 的位置和特征对的频率。
该indices数组在rope_params函数中包含第 4 节频率公式中的 2i值:
对于我们的八特征查询,indices为[0, 2, 4, 6],即每个特征对一个 2i值。假设我们使用常见的基数b= 10,000。并按照我们之前的示例,我们选择较小的头维度d= 8。在这种情况下,inv_freq然后计算四个对频率θi=b−2i/d如下:

如上所示,得到的inv_freq具有一个频率θi用于四个特征对中的每一个(以弧度为单位),每个 token 位置。
接下来,angles然后将每个对的频率θi与 token 位置m相乘,计算出旋转角度mθi。在我们的示例中,使用positions = [2],我们得到:

最后,rope_params取每个角度的余弦和正弦,并将它们输出为两个所谓的余弦和正弦表,cos和sin。在两个表中,每一行是一个 token 位置,每一列是一个特征对。由于我们这里只使用 token 位置 2,每个表的形状为(1, 4),其中单行如下所示:

对于图 26 中的示例,每个表都有一行对应 token 位置 2,以及四列,每列对应一个特征对。图 27 展示了每个对的旋转角度以及两个表中对应的条目。

简而言之,rope_params会计算每个旋转角度的余弦和正弦,而旋转角度取决于 token 的位置和特征对的频率。
在真实场景中,如果我们传入rope_params上下文大小为 1024 的 1,024 个 token 位置,以及 128 的头维度,它会返回两个张量,cos和sin,每个的形状为(1024, 64),因为具有 128 个特征的头有 64 个对。
这些表没有批次或头维度,我们将每个(1024, 64)表广播到批次和头维度上。因此,如果我们有 32 个头的多头注意力或分组查询注意力,token 位置 2 处的特征对 0 在所有 32 个头中使用相同的旋转角度。每个头旋转自己的特征值,因此旋转后的查询在不同头之间仍然可以不同。此外,相同的条目可以在使用相同位置和频率的查询、键和头之间复用。简而言之,我们只需要为每个模型针对最大支持的上下文大小内的所有位置(预先)计算一次这些表。
从技术上讲,也可以将这些表与模型权重一起存储;但它们的计算成本极低,将它们存储在磁盘上会显得多余。
接下来,rope_split_half使用这些余弦和正弦来旋转注意力内部查询和键向量中的实际特征。
再次考虑简单的 8 特征示例,上面代码片段中的.chunk将查询拆分为[1, 2, 3, 4]和[5, 6, 7, 8],并将每个对中的两个条目对齐。例如,每个半部分的第一个槽给出(1, 5),第二个给出(2, 6),依此类推。torch.cat内部的两个表达式使用第 3.3 节中的公式计算旋转后的两半:

注意,这里所有用ai表示的内容对应查询的前半部分,所有用bi表示的内容来自后半部分。torch.cat内部的第一个表达式计算所有ai′值,第二个表达式计算所有bi′值。
然后,我们将两半拼接起来,这会通过以下方式把每个值放回其原始索引位置:torch.cat。
下面是生成前面图 26 中旋转后查询的代码。所示的 reshape(1, 1, 1, 8)只是把简单的玩具数组变成预期格式:一个批次项、一个头、一个 token 和八个特征。
在有多个位置时,每个 token 只需从cos和sin表中取出自己对应的行。通过广播,PyTorch 会在所有批次项和注意力头上复用这些相同的表。
到目前为止,我们编写了 RoPE 工具函数。现在让我们在真实上下文中使用它,即注意力机制。这里,我们对两个 8 特征头和四个 token 位置使用标准频率调度。我们使用随机查询、键和值张量来保持示例自包含,但如前所述,你也可以选择检查端到端的Qwen3 从零实现,其中使用预训练模型生成的真实查询、键和值。
注意,只有q和k会经过 RoPE,而v不会。得到的原始注意力分数存储在一个形状为(1, 2, 4, 4)的张量中,即每个查询位置一行、每个键位置一列,并且是 4x4,因为我们有四个 token,每个 token 都关注其他每个 token。
然后,使用常规的注意力代码实现,因果掩码将未来键的分数替换为负无穷,因此它们在 softmax 后会被置零。得到的context张量形状为(1, 2, 4, 8);4 是因为我们有四个 token,8 是因为嵌入维度原本是 8。
我们还可以验证关于相对偏移的说法成立,即给每个位置加 3 应该会改变位置但保留查询-键偏移:
我在整篇文章中多次提到分半约定。原始 RoPE 论文使用的是另一种交错约定,原始 LLaMA 实现也是如此(但如前所述,现在大多数代码实现使用分半约定,因为在代码中通过逐元素的 sine 和 cosine 操作一次性旋转所有对更容易。)
为了说明两种布局的区别,下面的图 28 在两行中使用了相同的 8 特征向量。

交错实现使用同样的两个公式,但选择交替的特征并将输出交错排列。
但从数学上讲,当我们考虑特征顺序时,这些布局是等价的。因此,重新排列条目[1, 2, 3, 4, 5, 6, 7, 8]为[1, 5, 2, 6, 3, 7, 4, 8]使得分半配对变为相邻配对,即 (1, 5)、(2, 6) 等。如果我们对查询和键应用相同的重排,就会得到完全相同的点积。
输出保留了重排后的特征,因此我们按相同顺序将其与分半输出进行比较。然而,将这两种布局应用于原始向量会得到不同的分数。
自原始 LLaMA 模型以来,RoPE 一直是大多数(开源权重)LLM 的标配。当然,专有模型也可能使用它,但对于专有模型,总是很难百分之百确定。
然而,近年来,许多架构正在不再在每个 transformer 块中使用完整的 RoPE。在下面的小节中,我们将讨论其中一些变体。
例如,我们在上面各节中讨论并实现的完整 RoPE 实现会旋转每个特征对,在每个查询和键头中。
在下面各小节的示例中,我们将看到有些模型只旋转头内的部分特征,其他模型在某些 transformer 块中跳过 RoPE,还有一些模型使用不同的方法,将位置信息直接加到注意力分数上。
正如全文所讨论的,常规的“完整”RoPE 会旋转每个查询和键头中的所有维度。部分 RoPE 是一种变体,只旋转一个子集,而保持其余维度不变。
例如,MiniMax-M3 的配置在每个 128 维的头中使用 64 个旋转维度。这给出 32 个旋转特征对和 64 个未改变的维度。下图展示了它的样子。
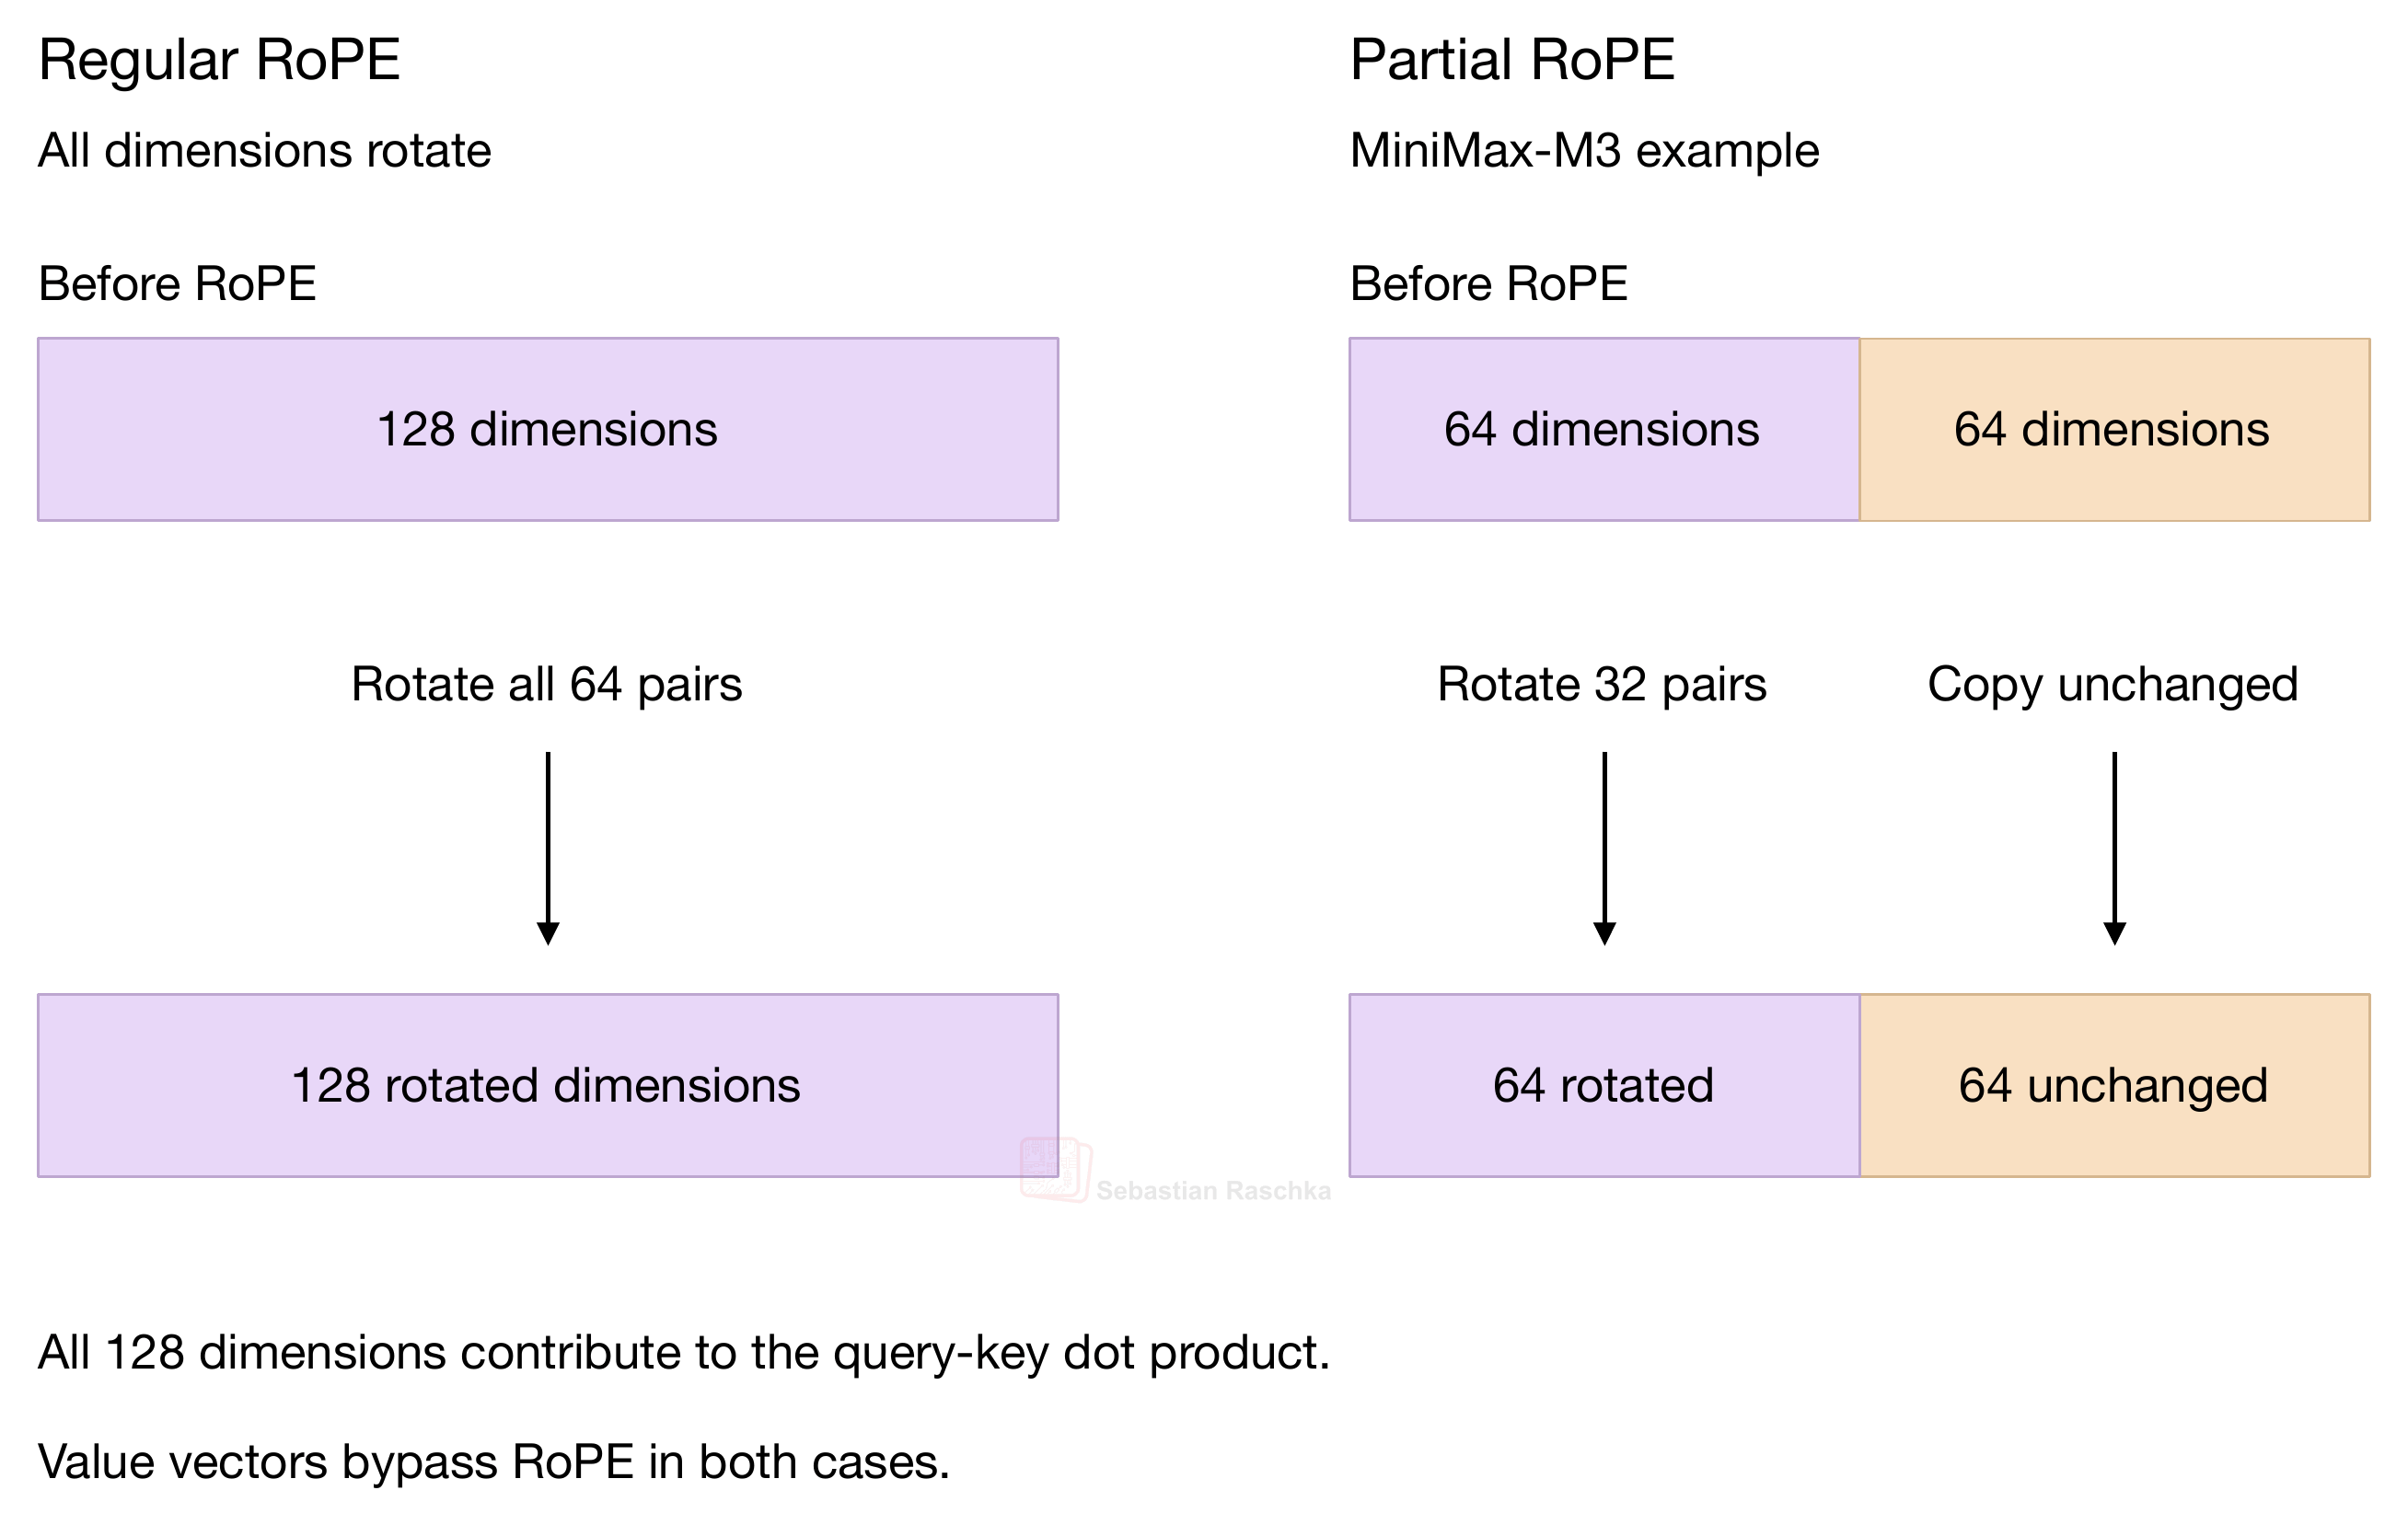
请注意,如果我们越过第一个 transformer 块,未旋转的特征仍然可以包含从更早的 transformer 块继承的位置信息。
总之,部分 RoPE 的意义何在?它能节省一些内存。例如,在上面的 MiniMax-M3 例子中,旋转一半的特征也会将预计算的余弦和正弦表的大小减半。因此,使用部分 RoPE 时,每个表不再需要 64 列,而只需要 32 列。不过请注意,KV 缓存仍然会为每个被缓存的 token 存储完整的键和值向量。
对于 MiniMax-M3 的 1M token 上下文,旋转 128 个特征中的 64 个会将预计算的余弦和正弦表的大小减半;如果这些表以 BF16 存储,则可节省 0.134 GB(128 MiB)。如果这些表本身以 NVFP4 存储,则节省量为 0.038 GB(36 MiB),其中包括块缩放因子。
请注意,在 1B 到 8B 模型的实验中,部分旋转,潜力全开?论文发现,旋转每个头约 10% 的特征,通常能获得与完整 RoPE 相似的训练损失和基准测试准确率。不过,完整 RoPE 在某些评估中表现更好。
所以,在我看来,部分 RoPE 几乎不值得。
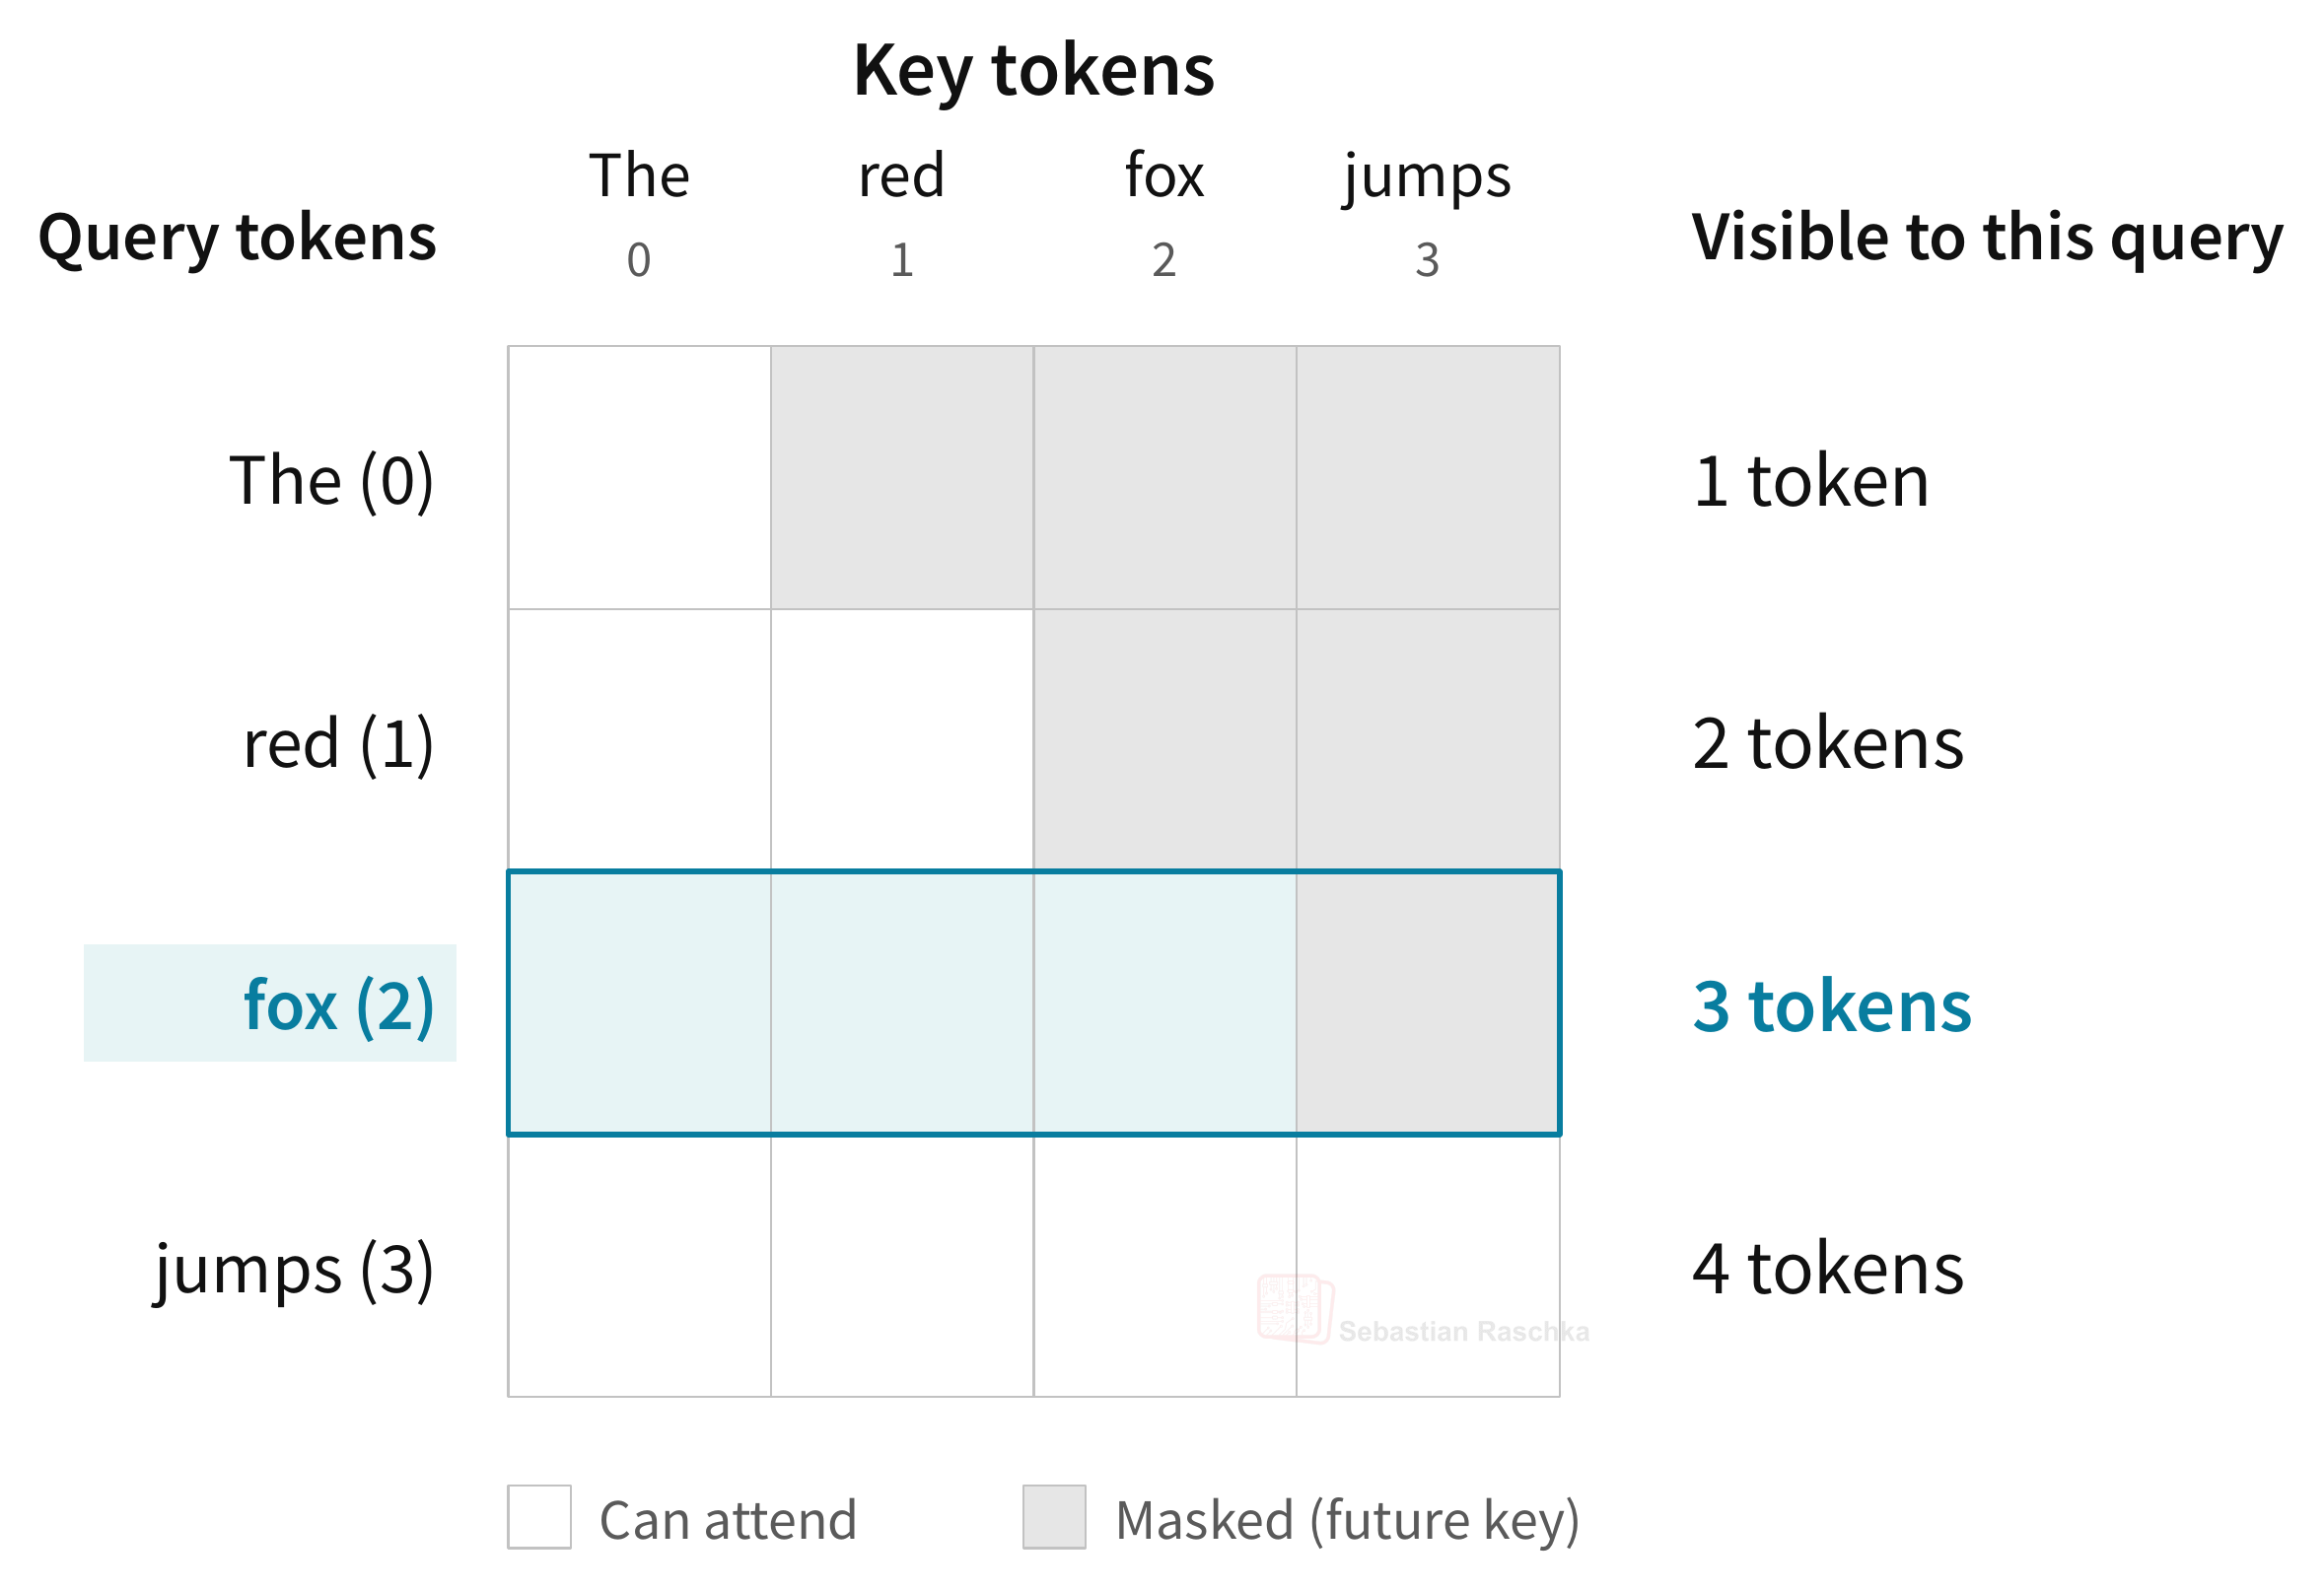
NoPE 是在位置编码对 Transformer 长度泛化的影响论文中提出的,意思是没有显式位置编码。其想法或观察是,没有任何显式位置方法的注意力层仍然具有因果掩码,其中查询只能关注自身和更早的 token。而这种因果掩码隐式地提供了位置信息。
让我们使用前面例子中的前四个 token,The red fox jumps。在图 30 中,位置 2 处fox的查询可以关注The、red以及它自身。位置 1 处red的查询可以关注The以及它自身。
那么,下一个问题是,模型如何将因果掩码用作位置信号?这里有一个改编自该论文的玩具示例。
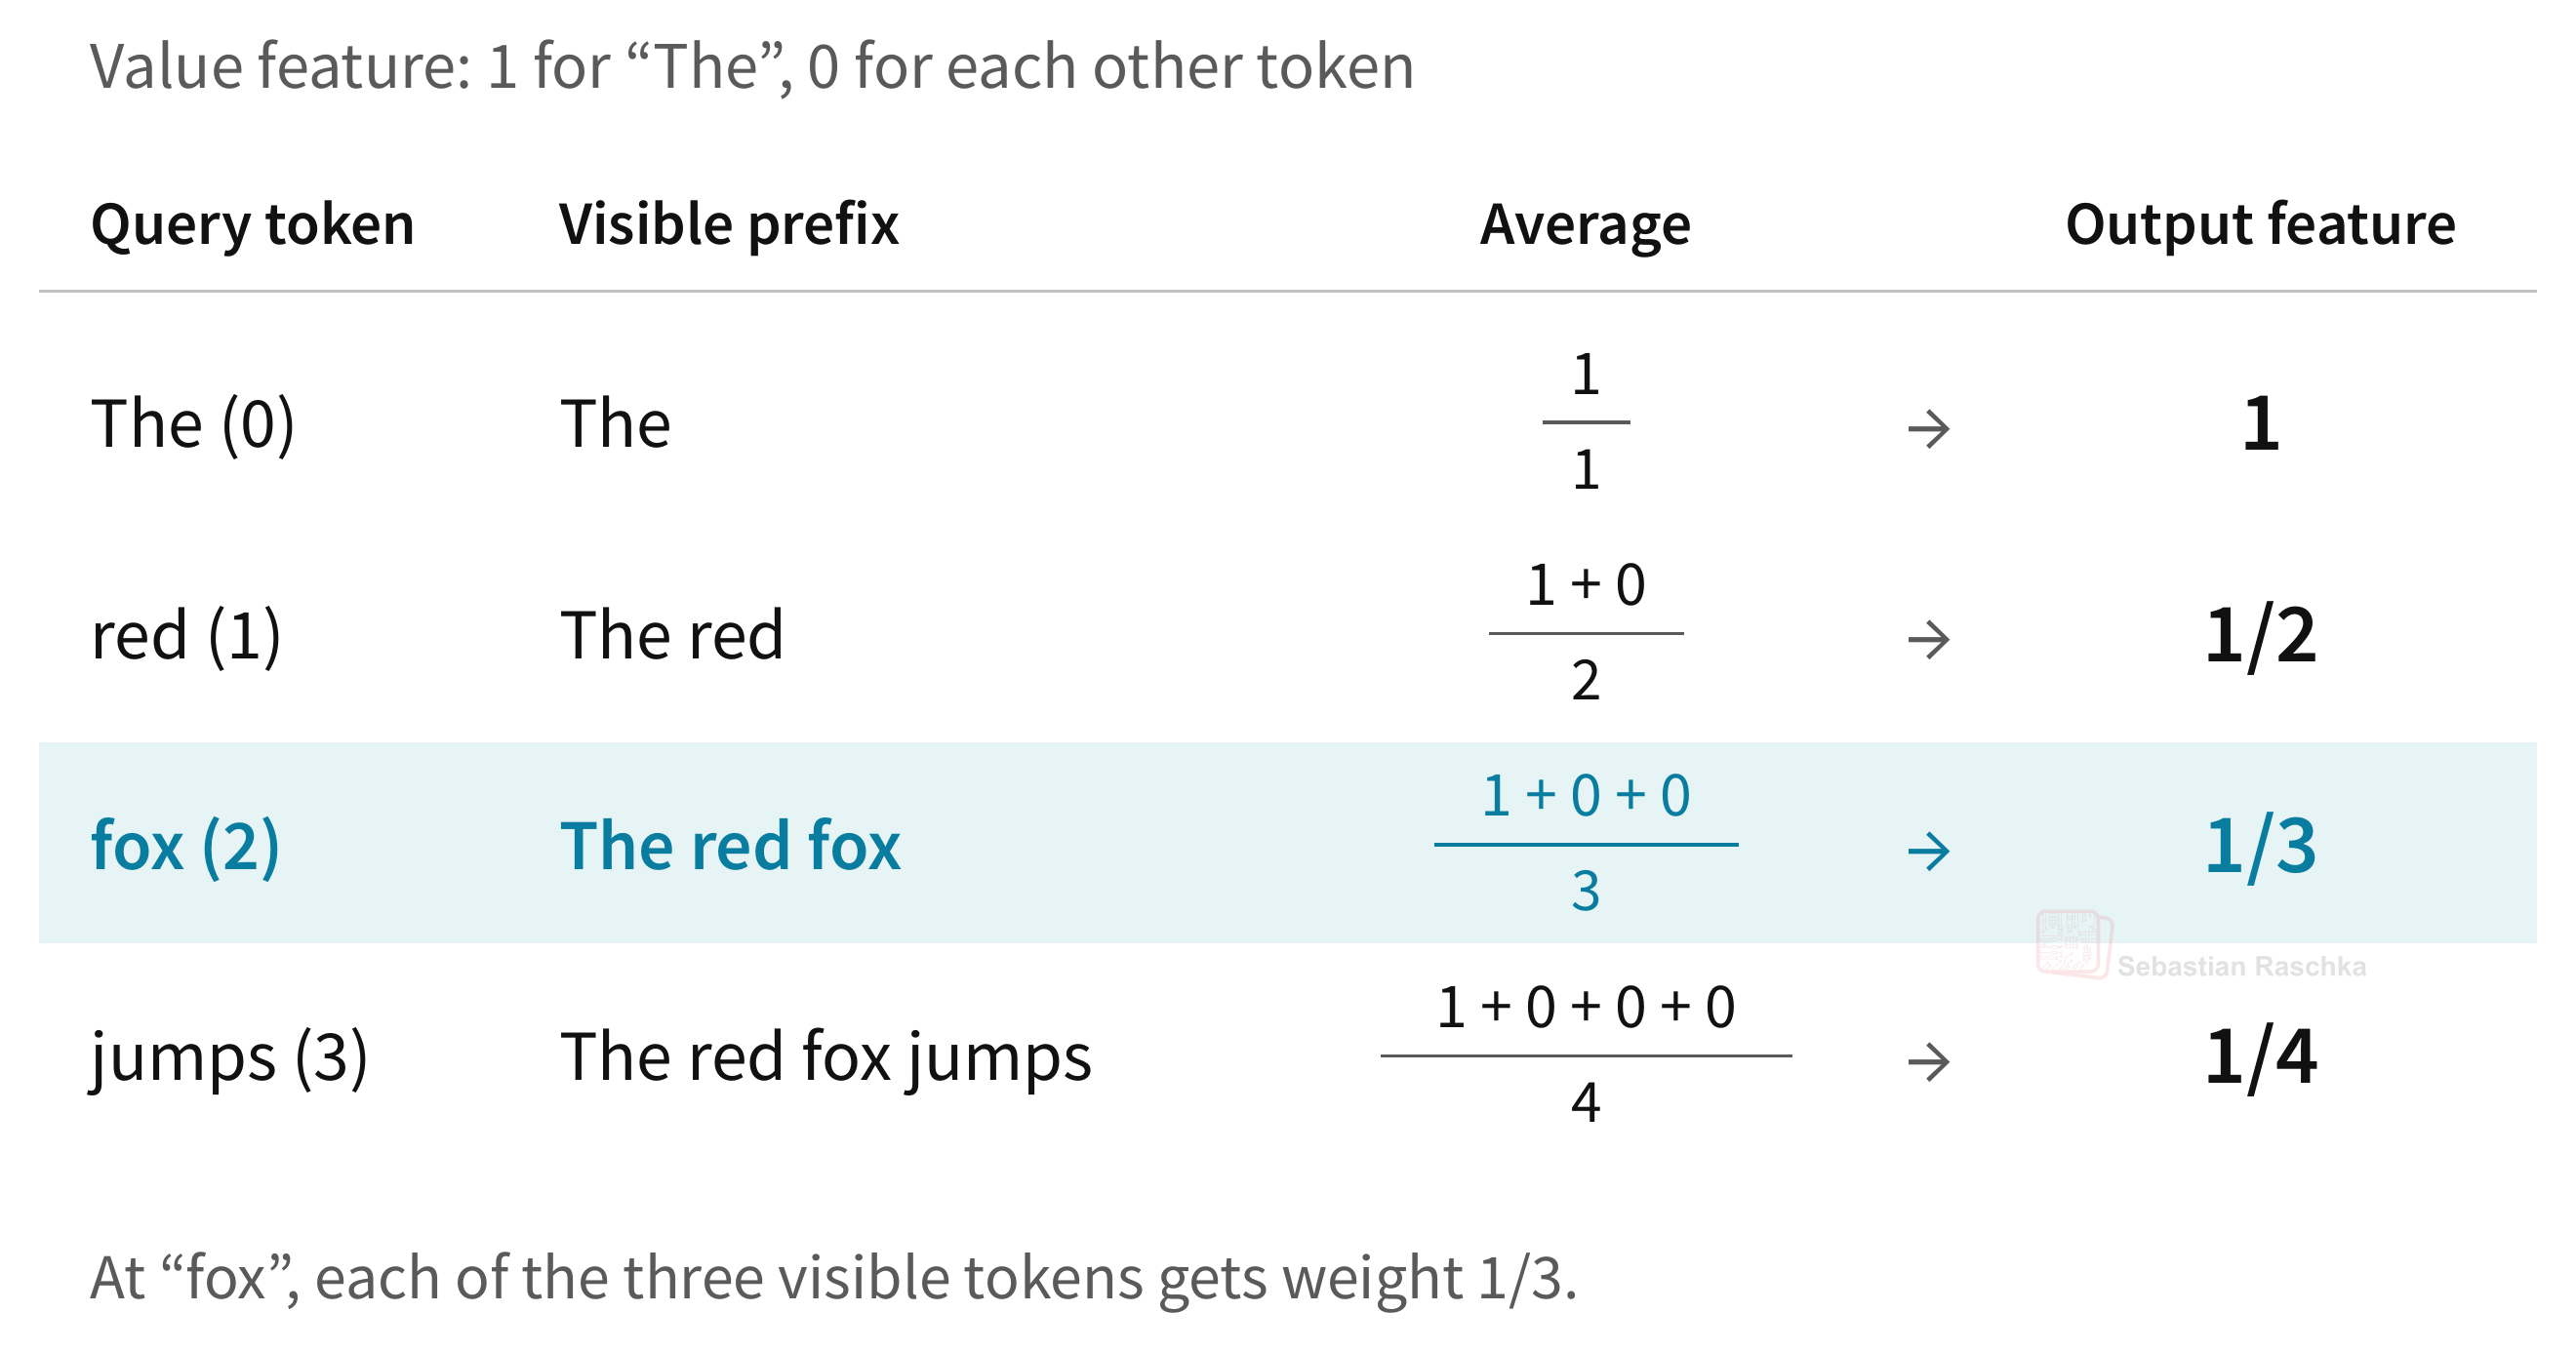
假设值向量的一个特征对于The为 1,对于其他三个 token 为 0。由于输入只包含一个The,每个可见前缀恰好包含一个 1。如果所有未掩码的键获得相同的注意力分数,softmax 会给每个可见 token 分配相同的权重。
所以在fox,注意力对 1、0 和 0 取平均,得到 1/3。在jumps,它对四个值取平均,得到 1/4。换句话说,这个输出特征等于前缀长度的倒数,后面的层可以将其用作位置信号。
NoPE 在实践中有效吗?NoPE 论文的研究人员从头训练了一个 1.07 亿参数的小型仅解码器 transformer,在复制、排序和加法等任务上做了一些消融实验。
当他们在比训练时所见更长的示例上测试这个小模型时,有趣的是,NoPE 在十项任务中总体排名第一,并领先于 RoPE。NoPE 论文背后的研究人员还用更大的 13 亿参数模型在代码上训练,进行了单独的实验。在这里,NoPE 同样能处理超出训练长度的上下文,不过,它在所测试的最长长度上的下一 token 预测变差了。
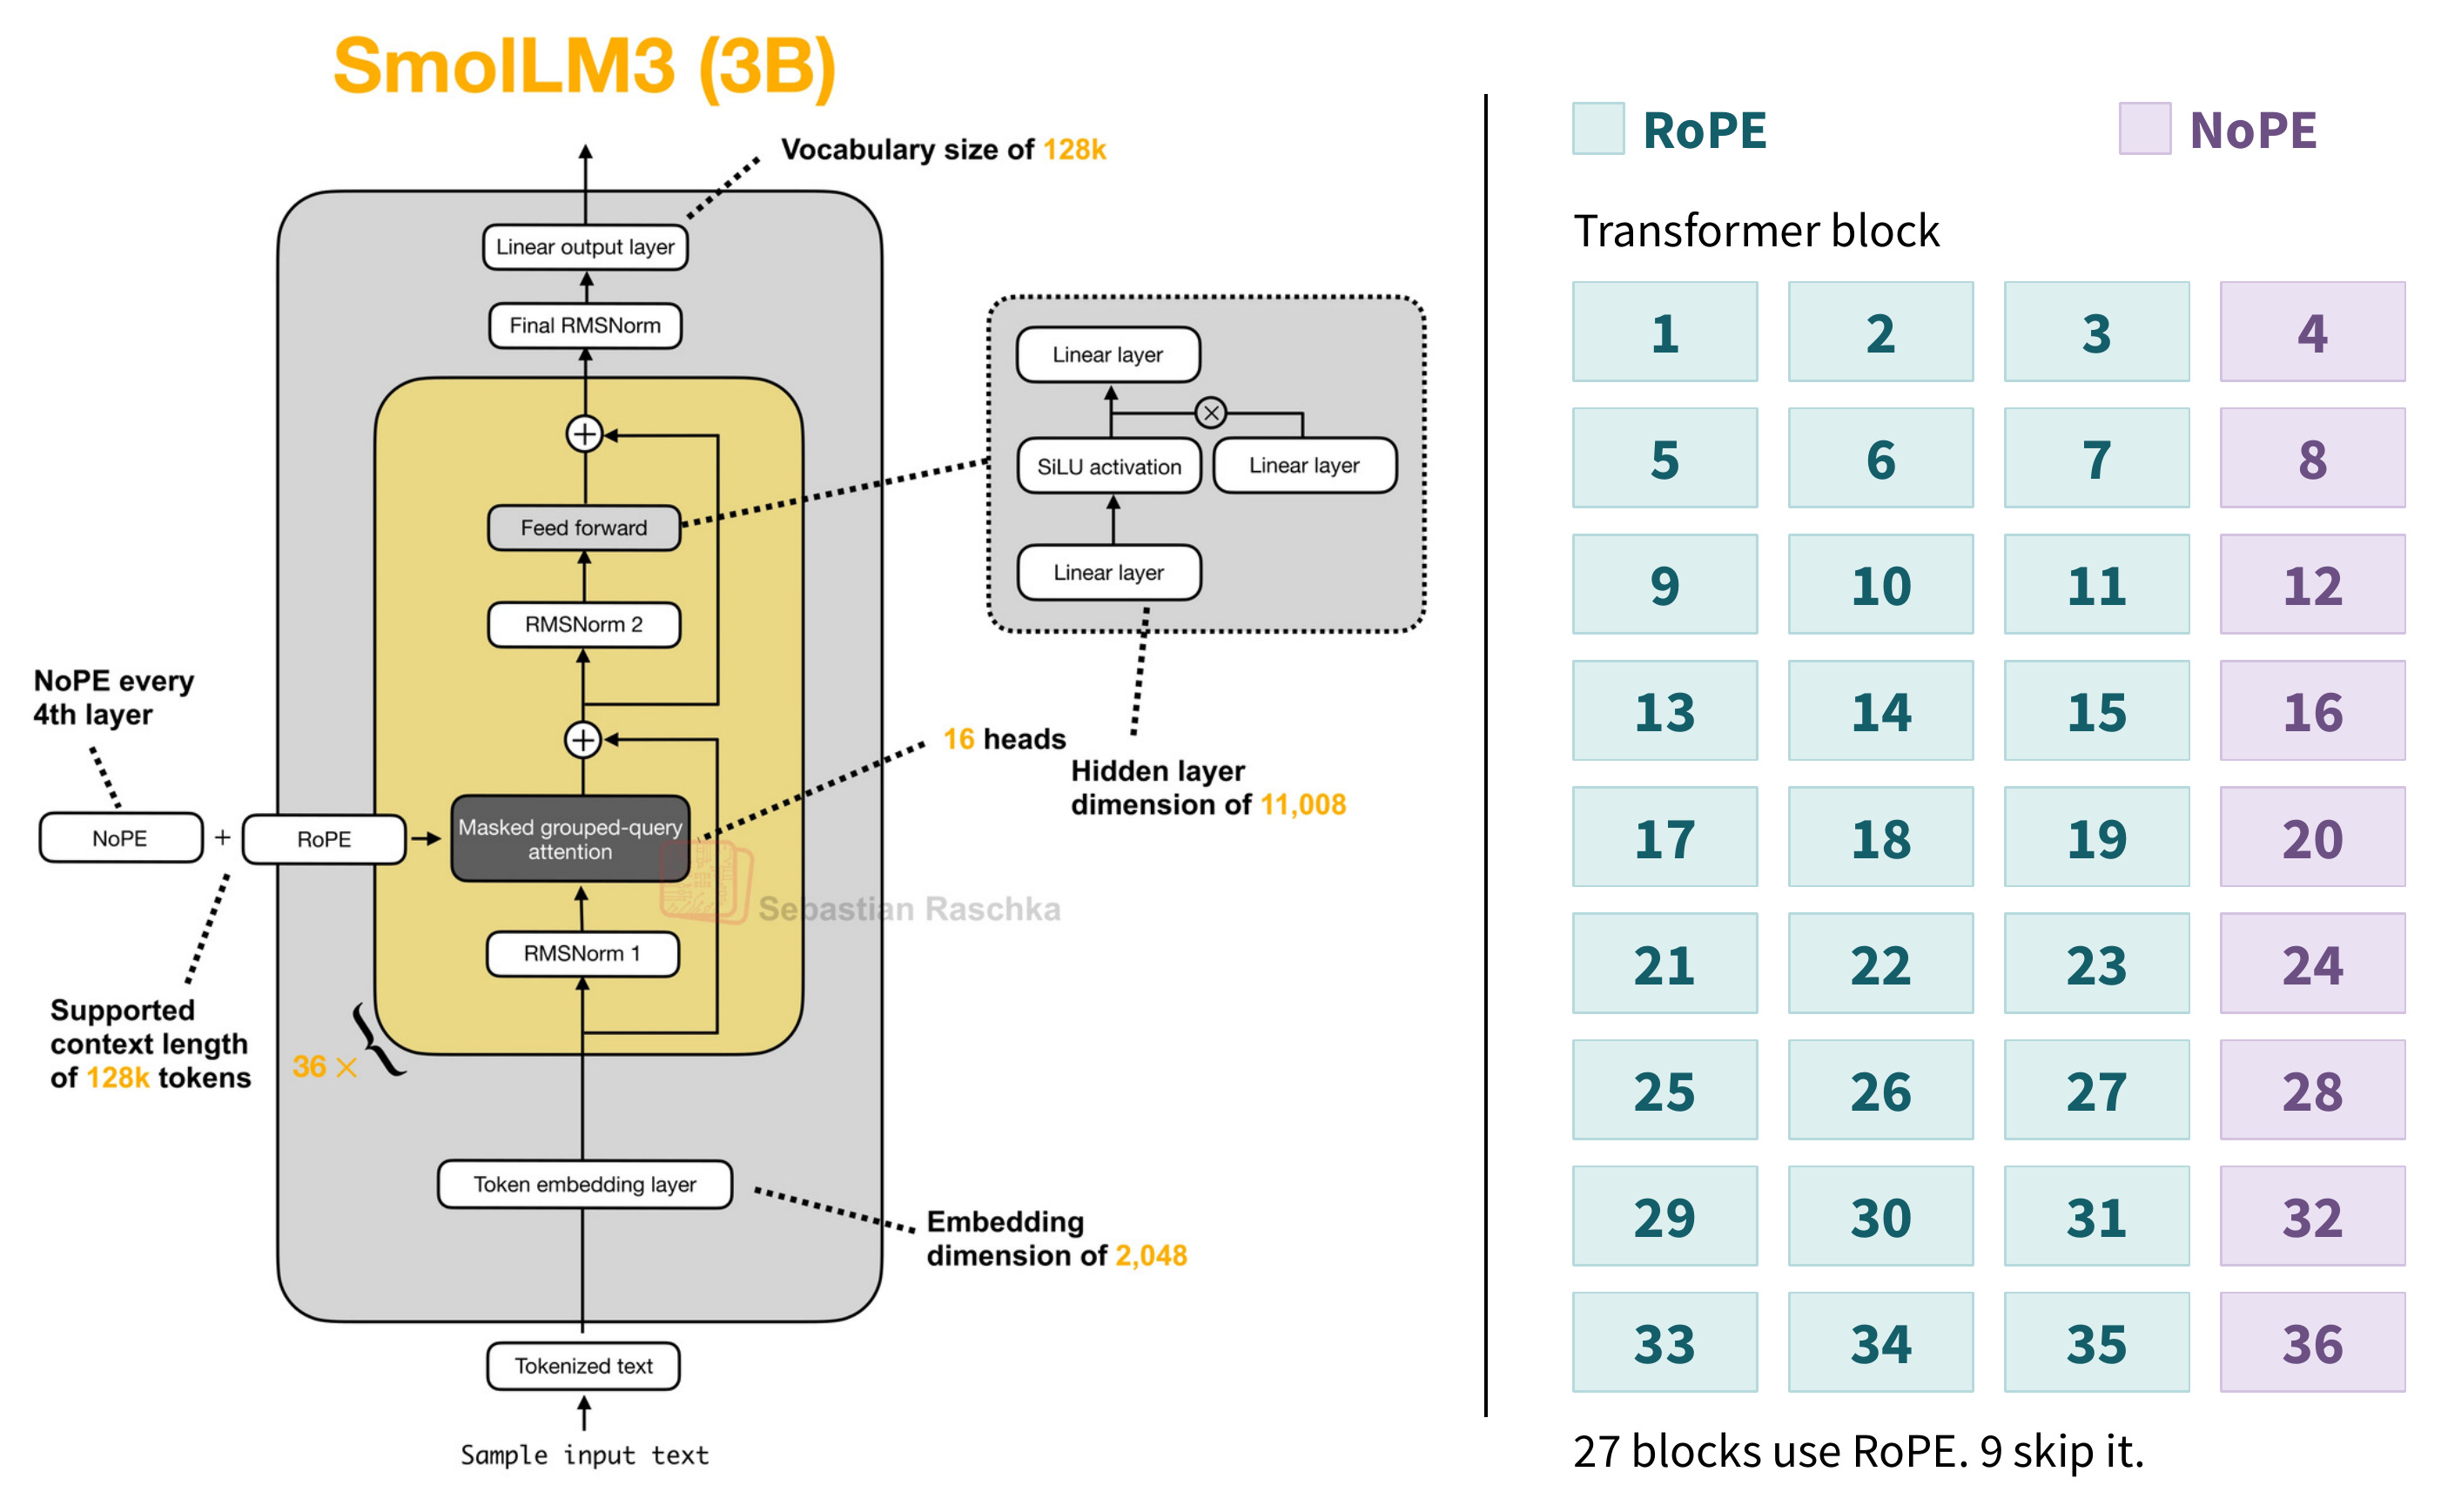
如今一些开源权重 LLM 甚至更进一步,在所有层中都使用 NoPE。然而,如今更常见的做法是模型在至少部分层中省略 RoPE,这里的层指的是 transformer 块。
举一个具体的例子,SmolLM3(30 亿参数)在三个层中应用 RoPE,在第四层中跳过它,并在 36 层中重复这一模式。有趣的是,SmolLM3 的作者提到,这种层模式改善了长上下文性能。
(另请注意,任何在第一个层之后的后续层,即使可能跳过旋转,仍然会接收来自前面 transformer 块的输入,因此其查询和键仍然从更早的层获得某种位置信息。)
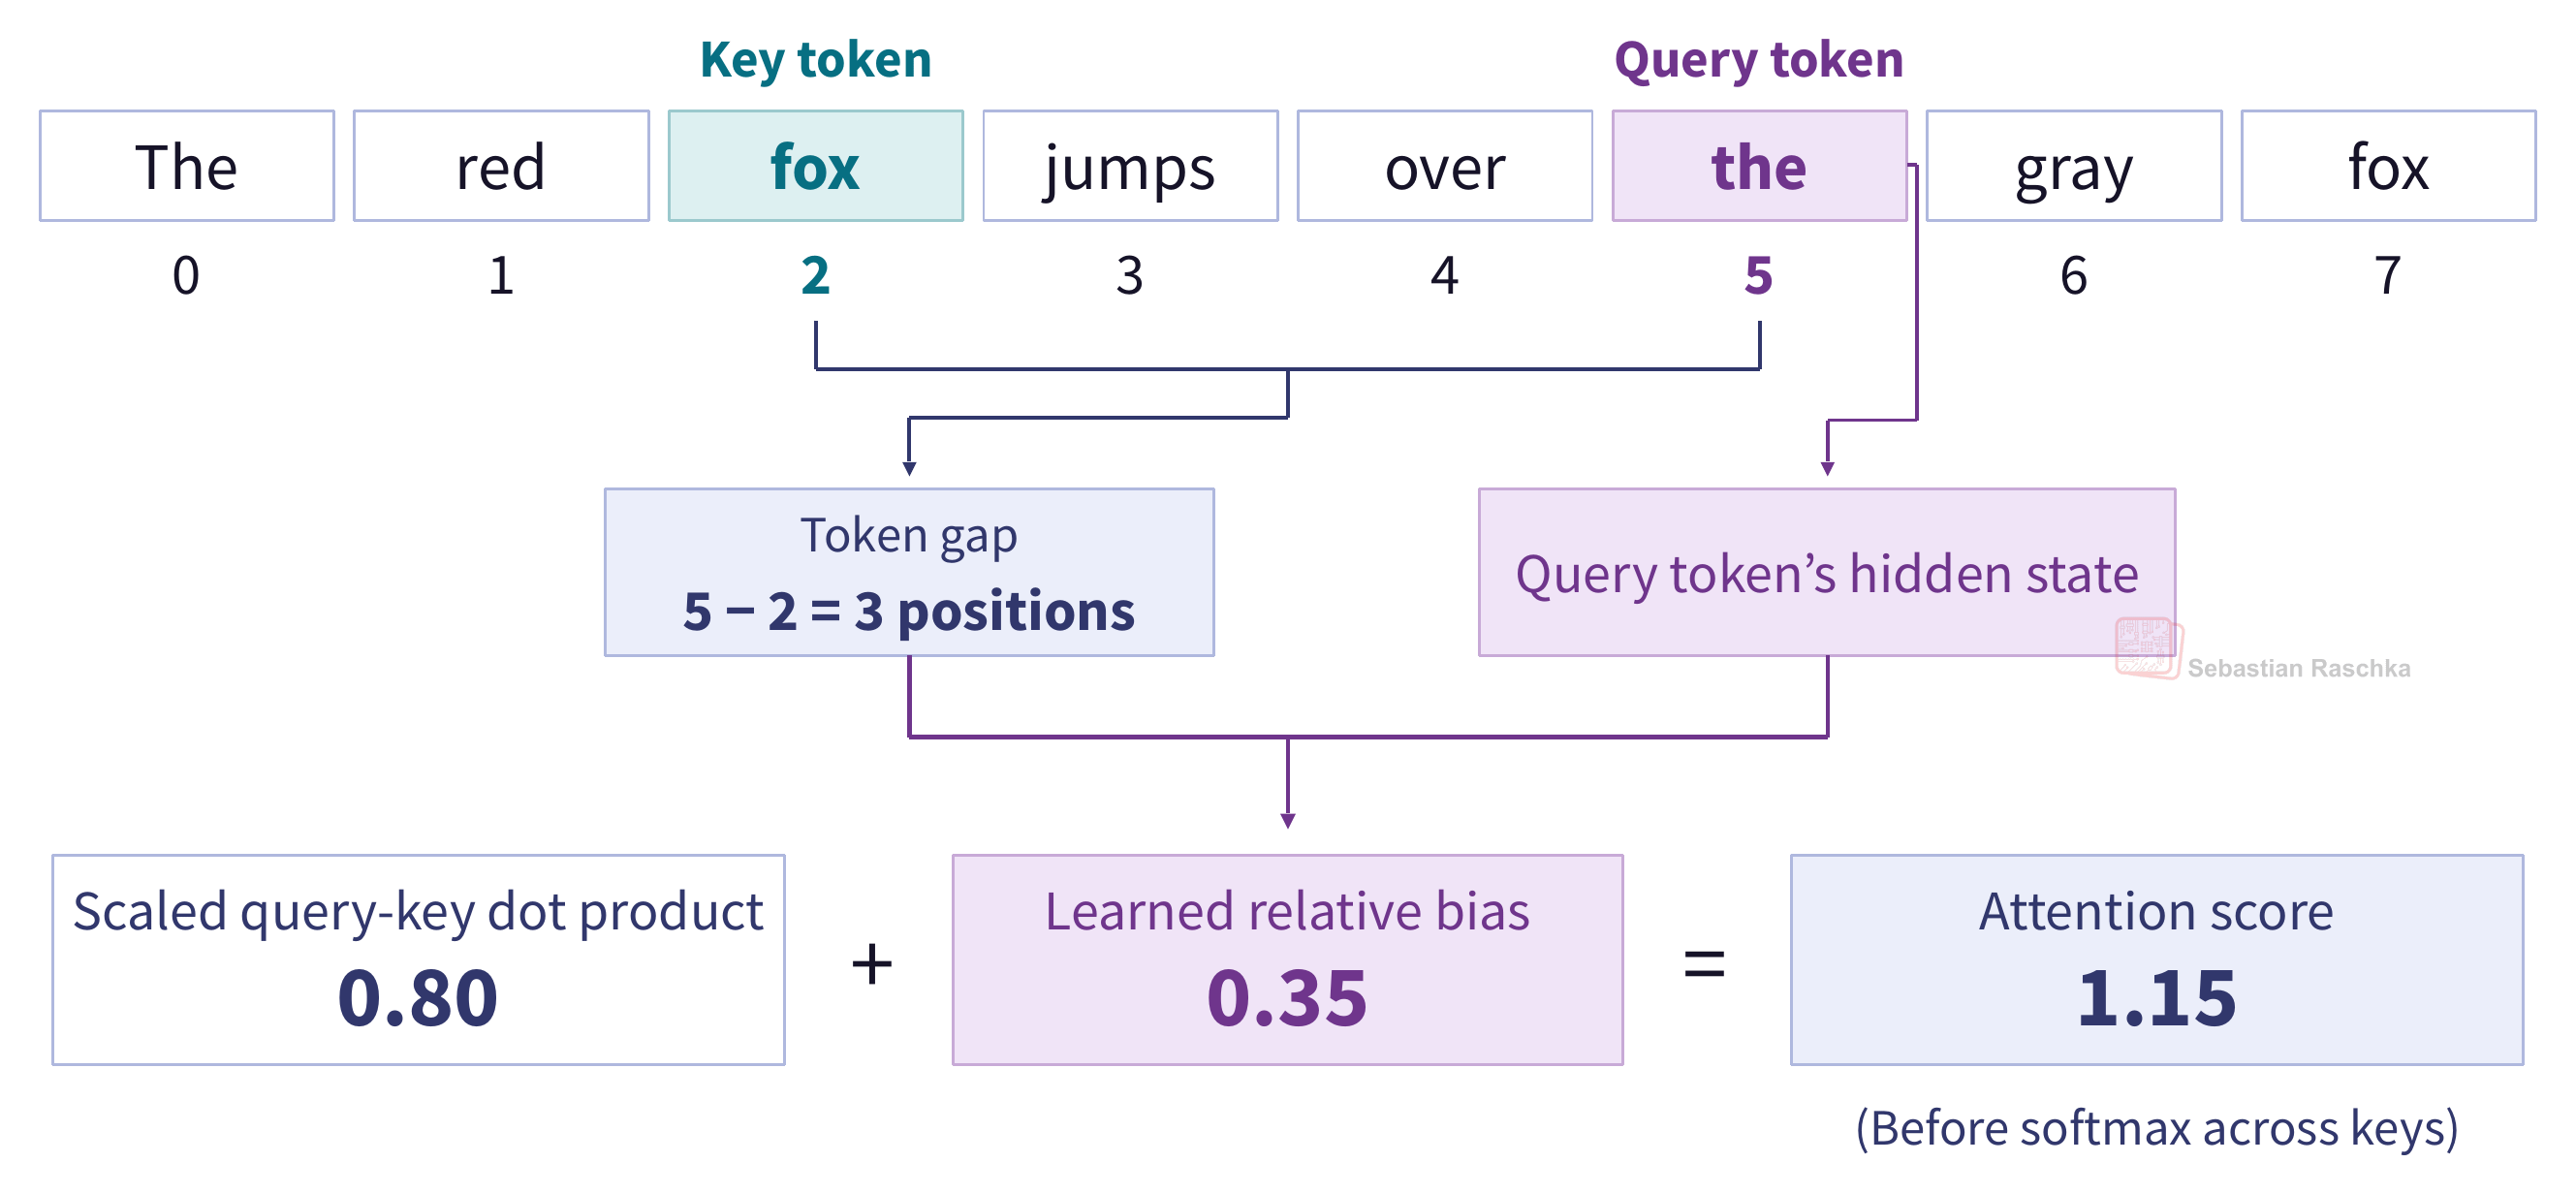
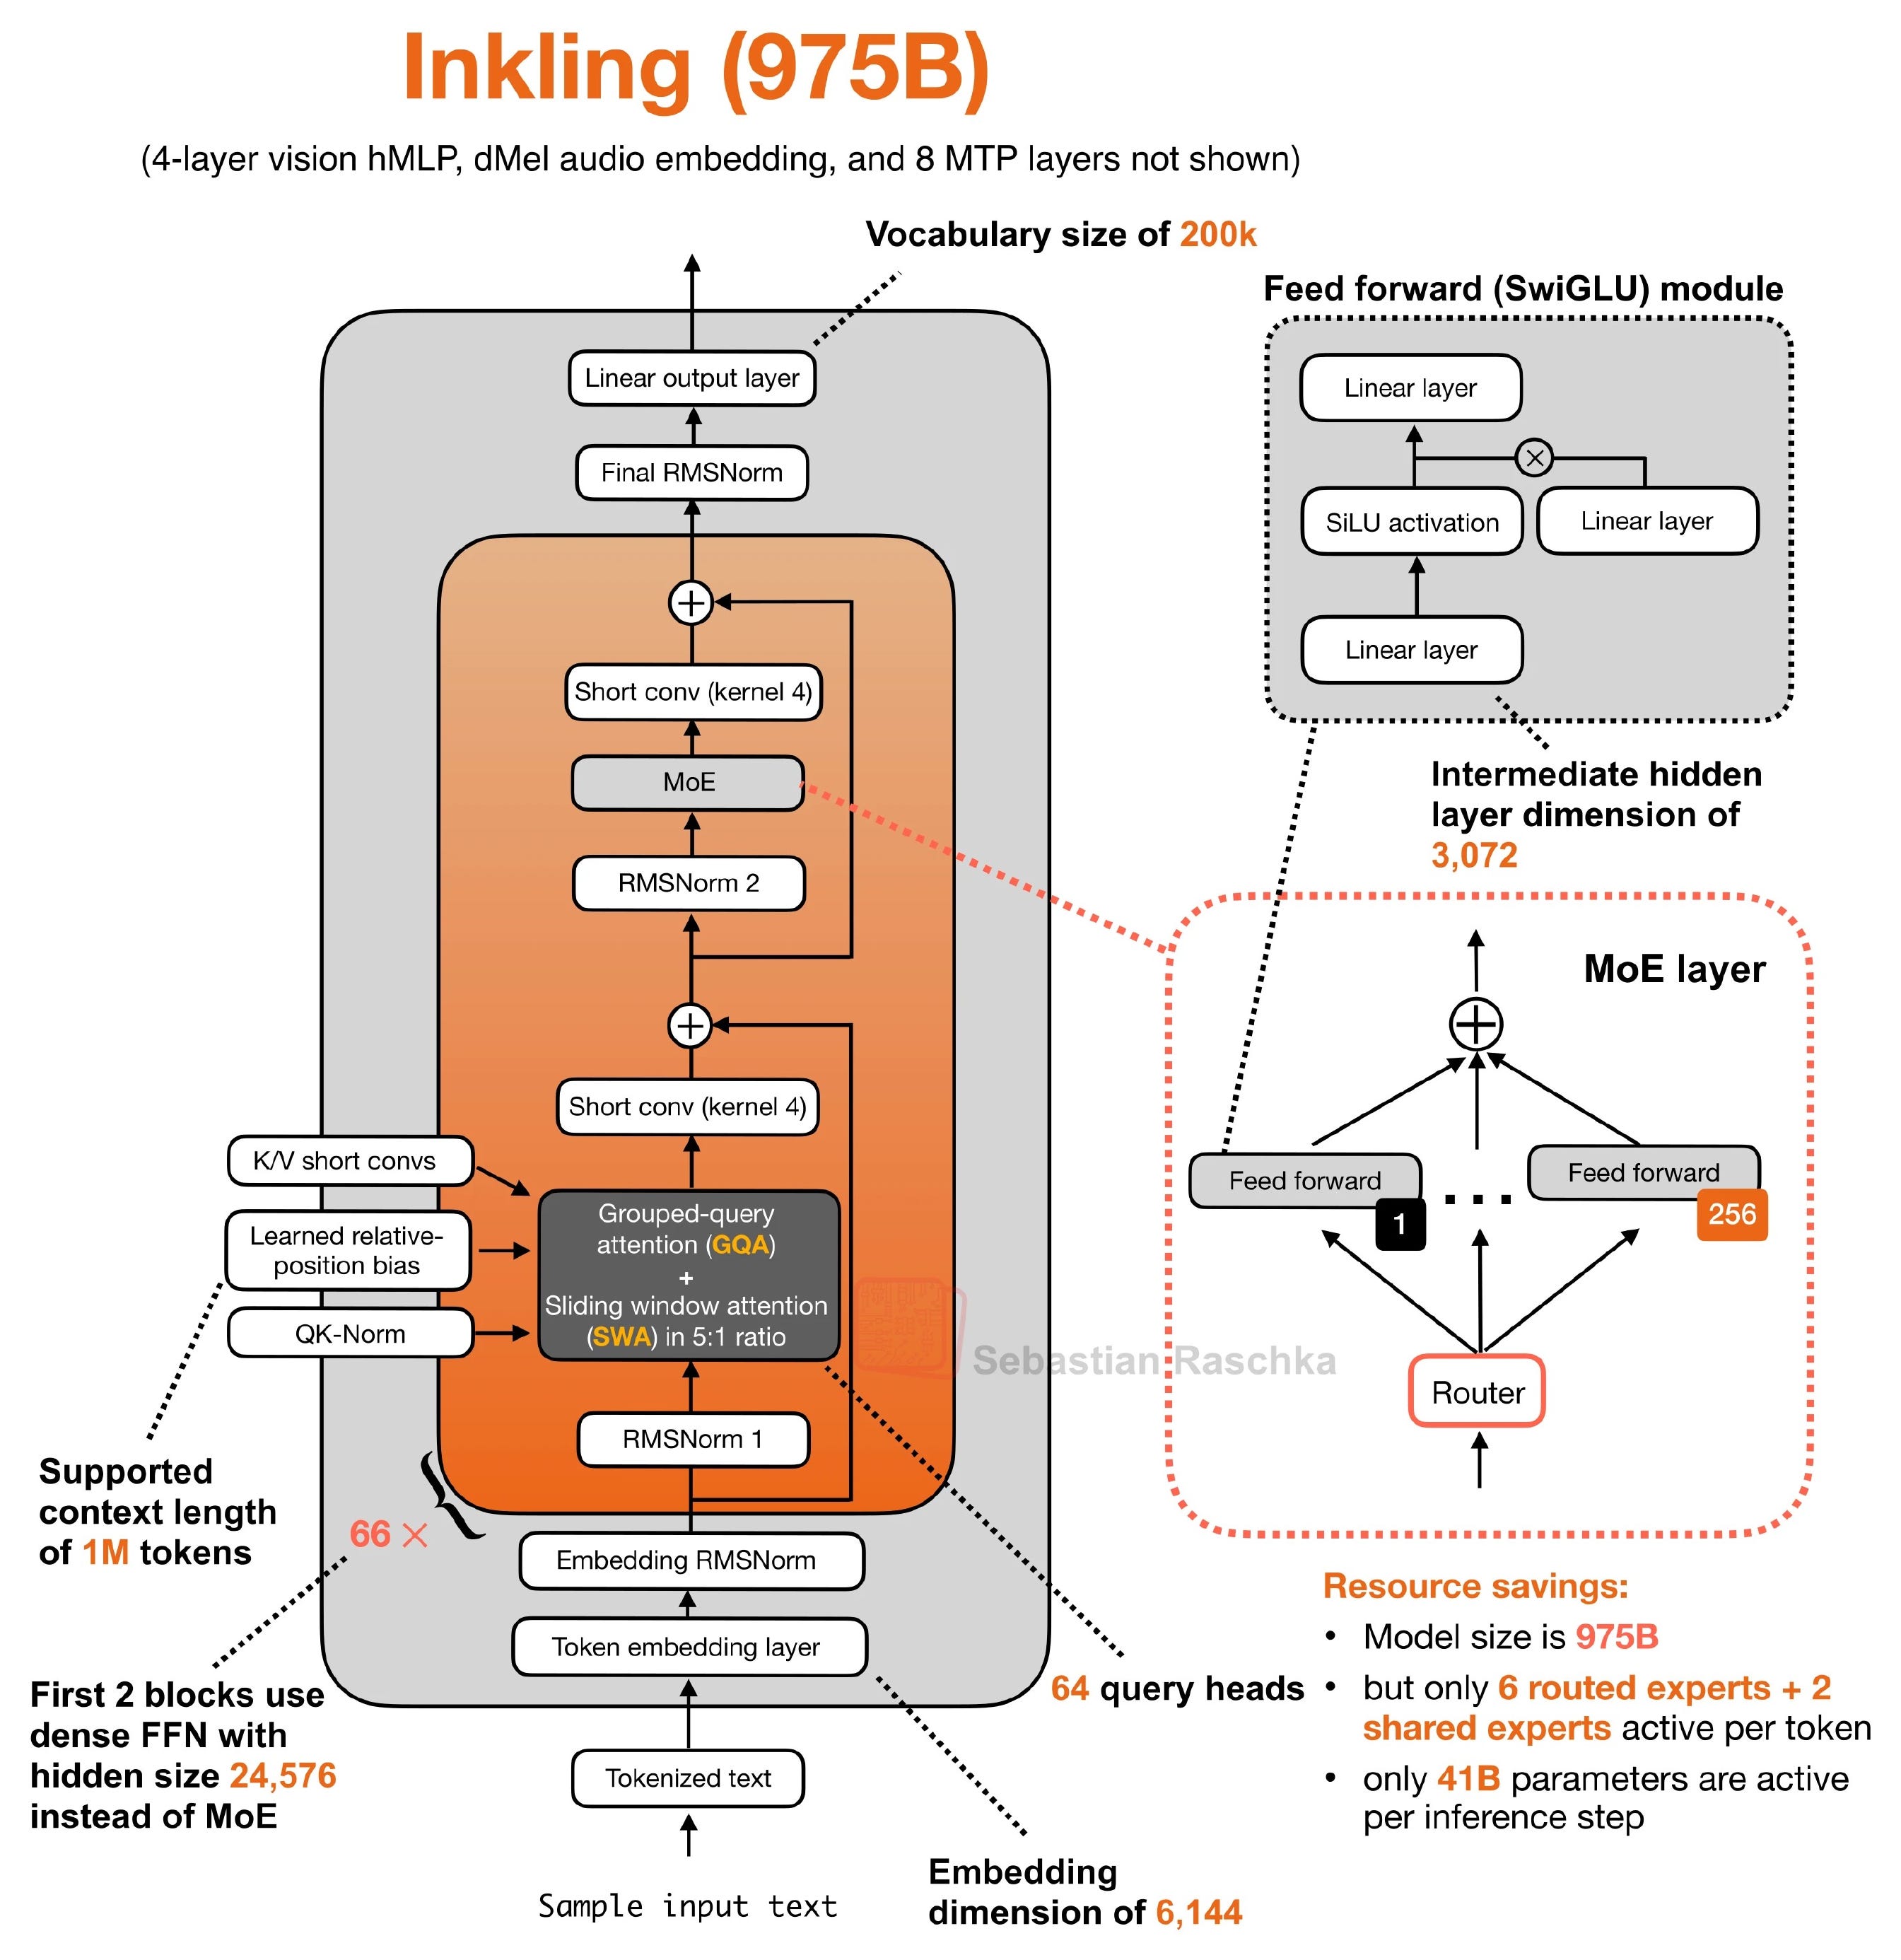
在我们进入概览并查看现代架构使用什么之前,还有一种方法要介绍。例如,Thinky 的Inkling在其滑动窗口注意力和全局注意力层中都使用了学习到的相对位置偏置。它先计算查询与键之间常规的缩放点积,然后在注意力分数计算中、softmax 之前给该分数加上某个数值。这个数值取决于查询 token 的隐藏状态,以及键往回相隔多少个位置。
让我们复用之前的例句,“The red fox jumps over the gray fox.”(这是最后一次,我保证!)在下图中,位置 5 的“the”是查询,位置 2 的“fox”是键。Inkling 随后利用查询与键之间相隔三个位置这一信息,以及“the”的隐藏状态来计算偏置,再将其加到缩放点积上。
这并非一个全新的想法。有些人可能还记得 Google 在 2019 年推出的广受欢迎的T5(Text-to-Text Transfer Transformer),它使用了这一想法的简化版本。
现在,经过这么多铺垫,有趣的问题是:哪种架构使用了哪种方法?近期的趋势又是什么?
为了回答这个问题,我按所列发布日期对 LLM 架构图库中的条目进行了分组,并将 2025 年的发布与 2026 年快照中更早和更晚的发布进行了比较。每张图库卡片只计一次,因此同一架构的多个变体都可能对结果有所贡献。LLM 架构图库
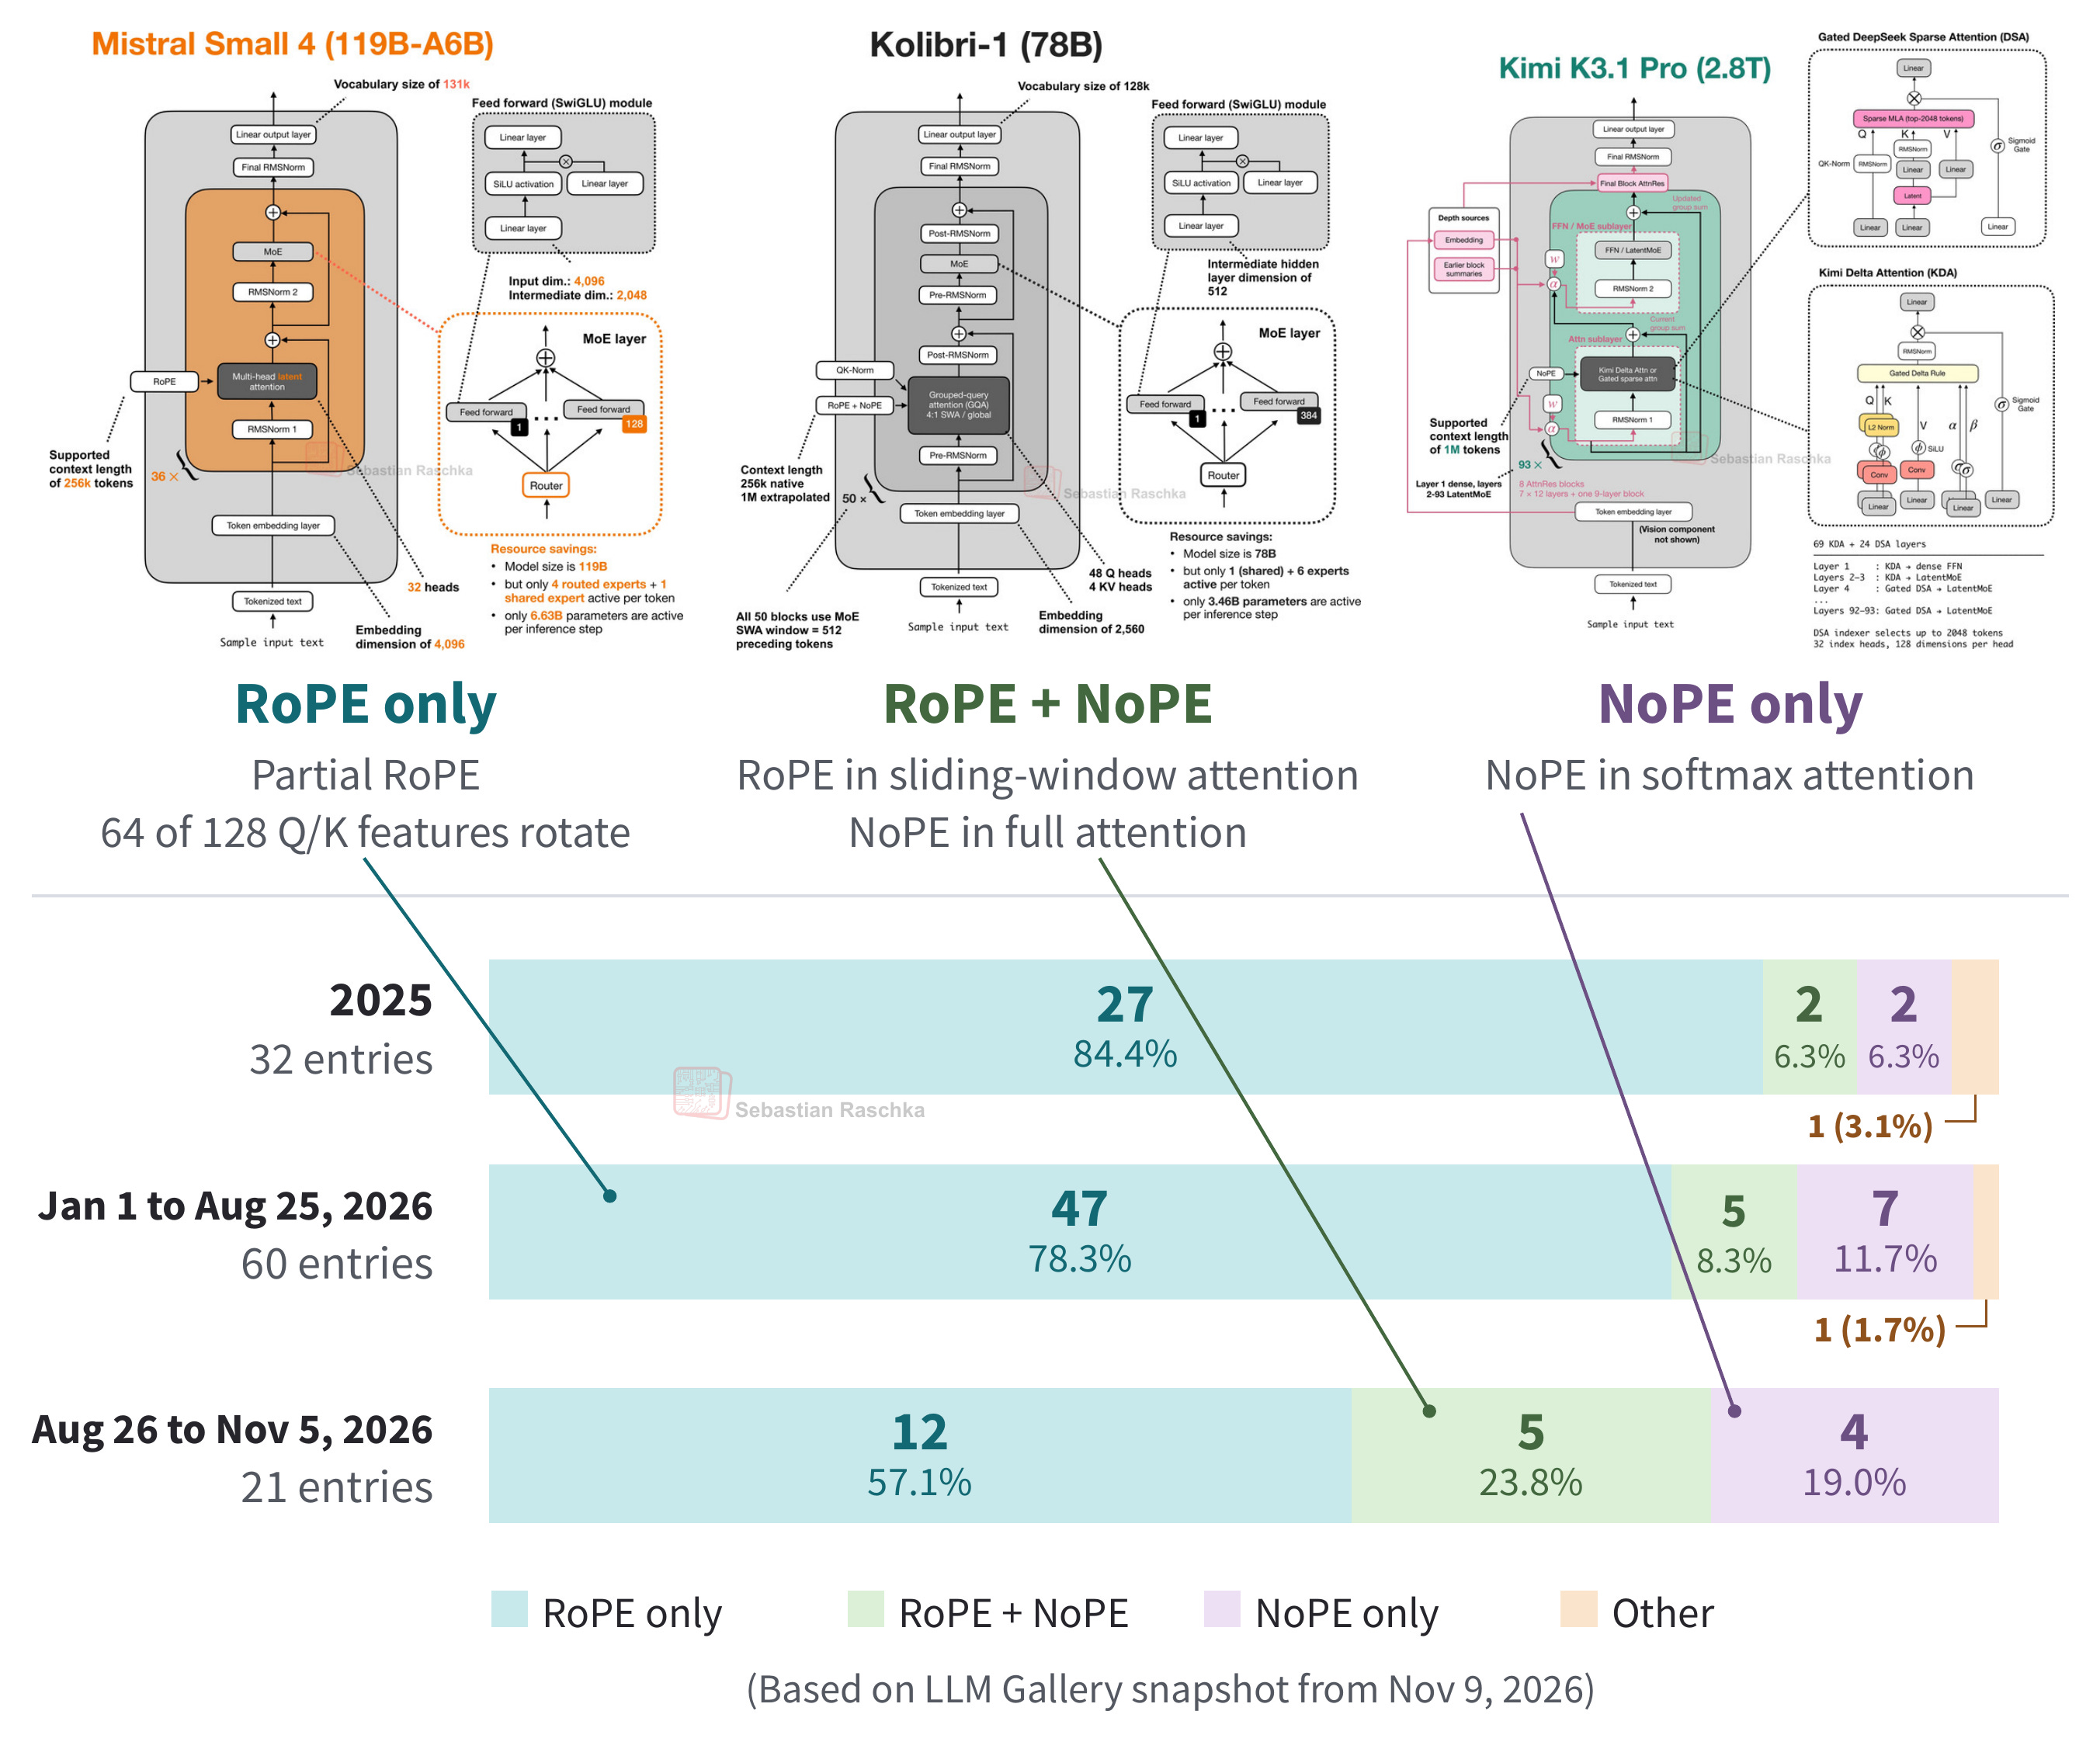
正如我们在上图 35 中所见,在每一个softmax 注意力层中使用 RoPE 仍是最常见的选择。然而,其使用率从 2025 年到 2026 年有所下降,随后在 2026 年下半年也出现下降,这可能是一种趋势。
因此,混合使用 RoPE 和 NoPE 的模型数量正在增加。这些群体规模仍然较小,因此很难说这些趋势是否会持续。
仅使用NoPE 的条目都是带有 softmax 注意力层的循环混合模型,且不使用显式位置编码。这里的“Other”类别指的是 xLSTM 7B(2025)和 Inkling(2026)。xLSTM 没有 softmax 注意力层。Inkling 在 softmax 之前给注意力分数加上了一个学习到的偏置,正如我们在第 6.3 节中看到的那样。
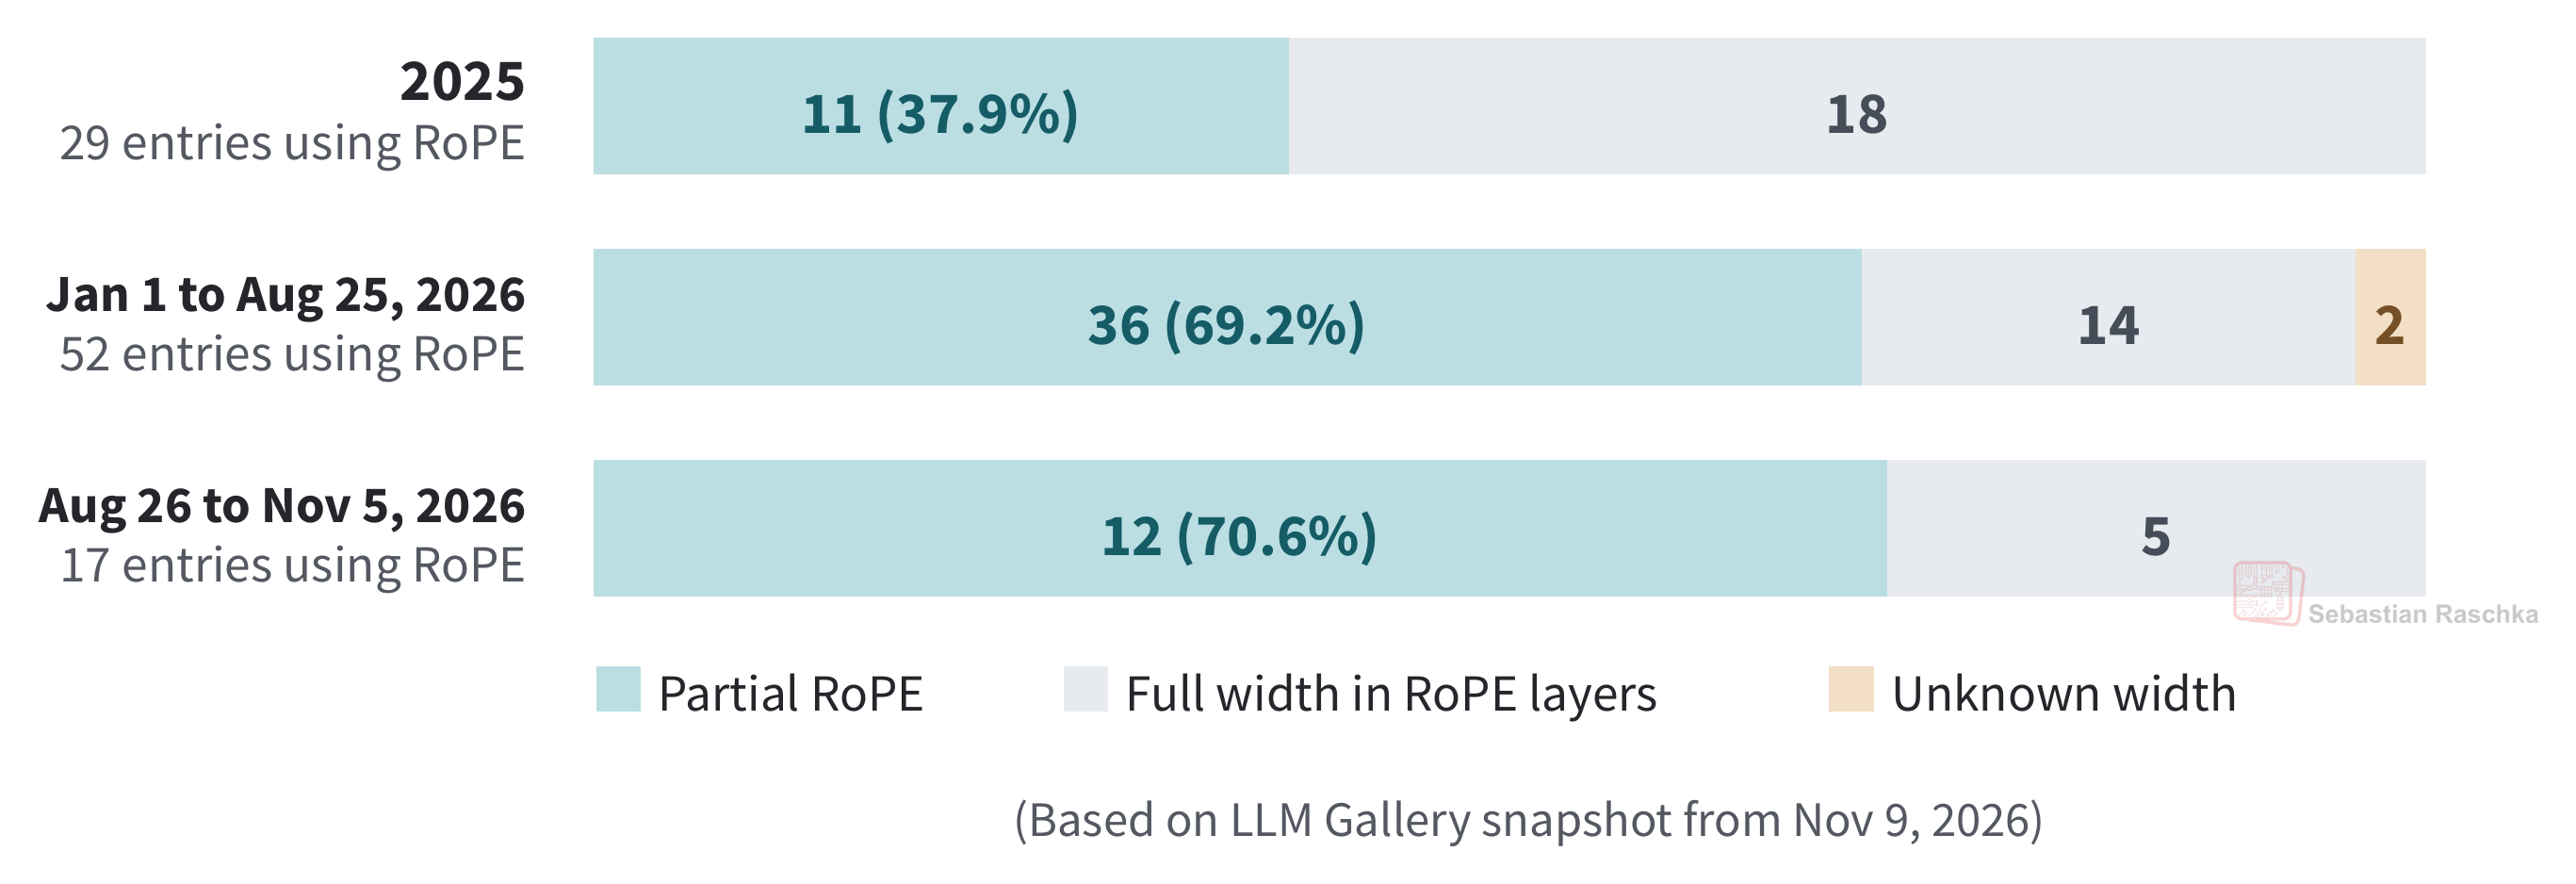
在使用 RoPE 的模型中,部分 RoPE 从 2025 年到 2026 年变得更加常见。它在 2025 年还是 RoPE 模型中的少数,到 2026 年的两个组中都变成了多数,如图 36 所示。
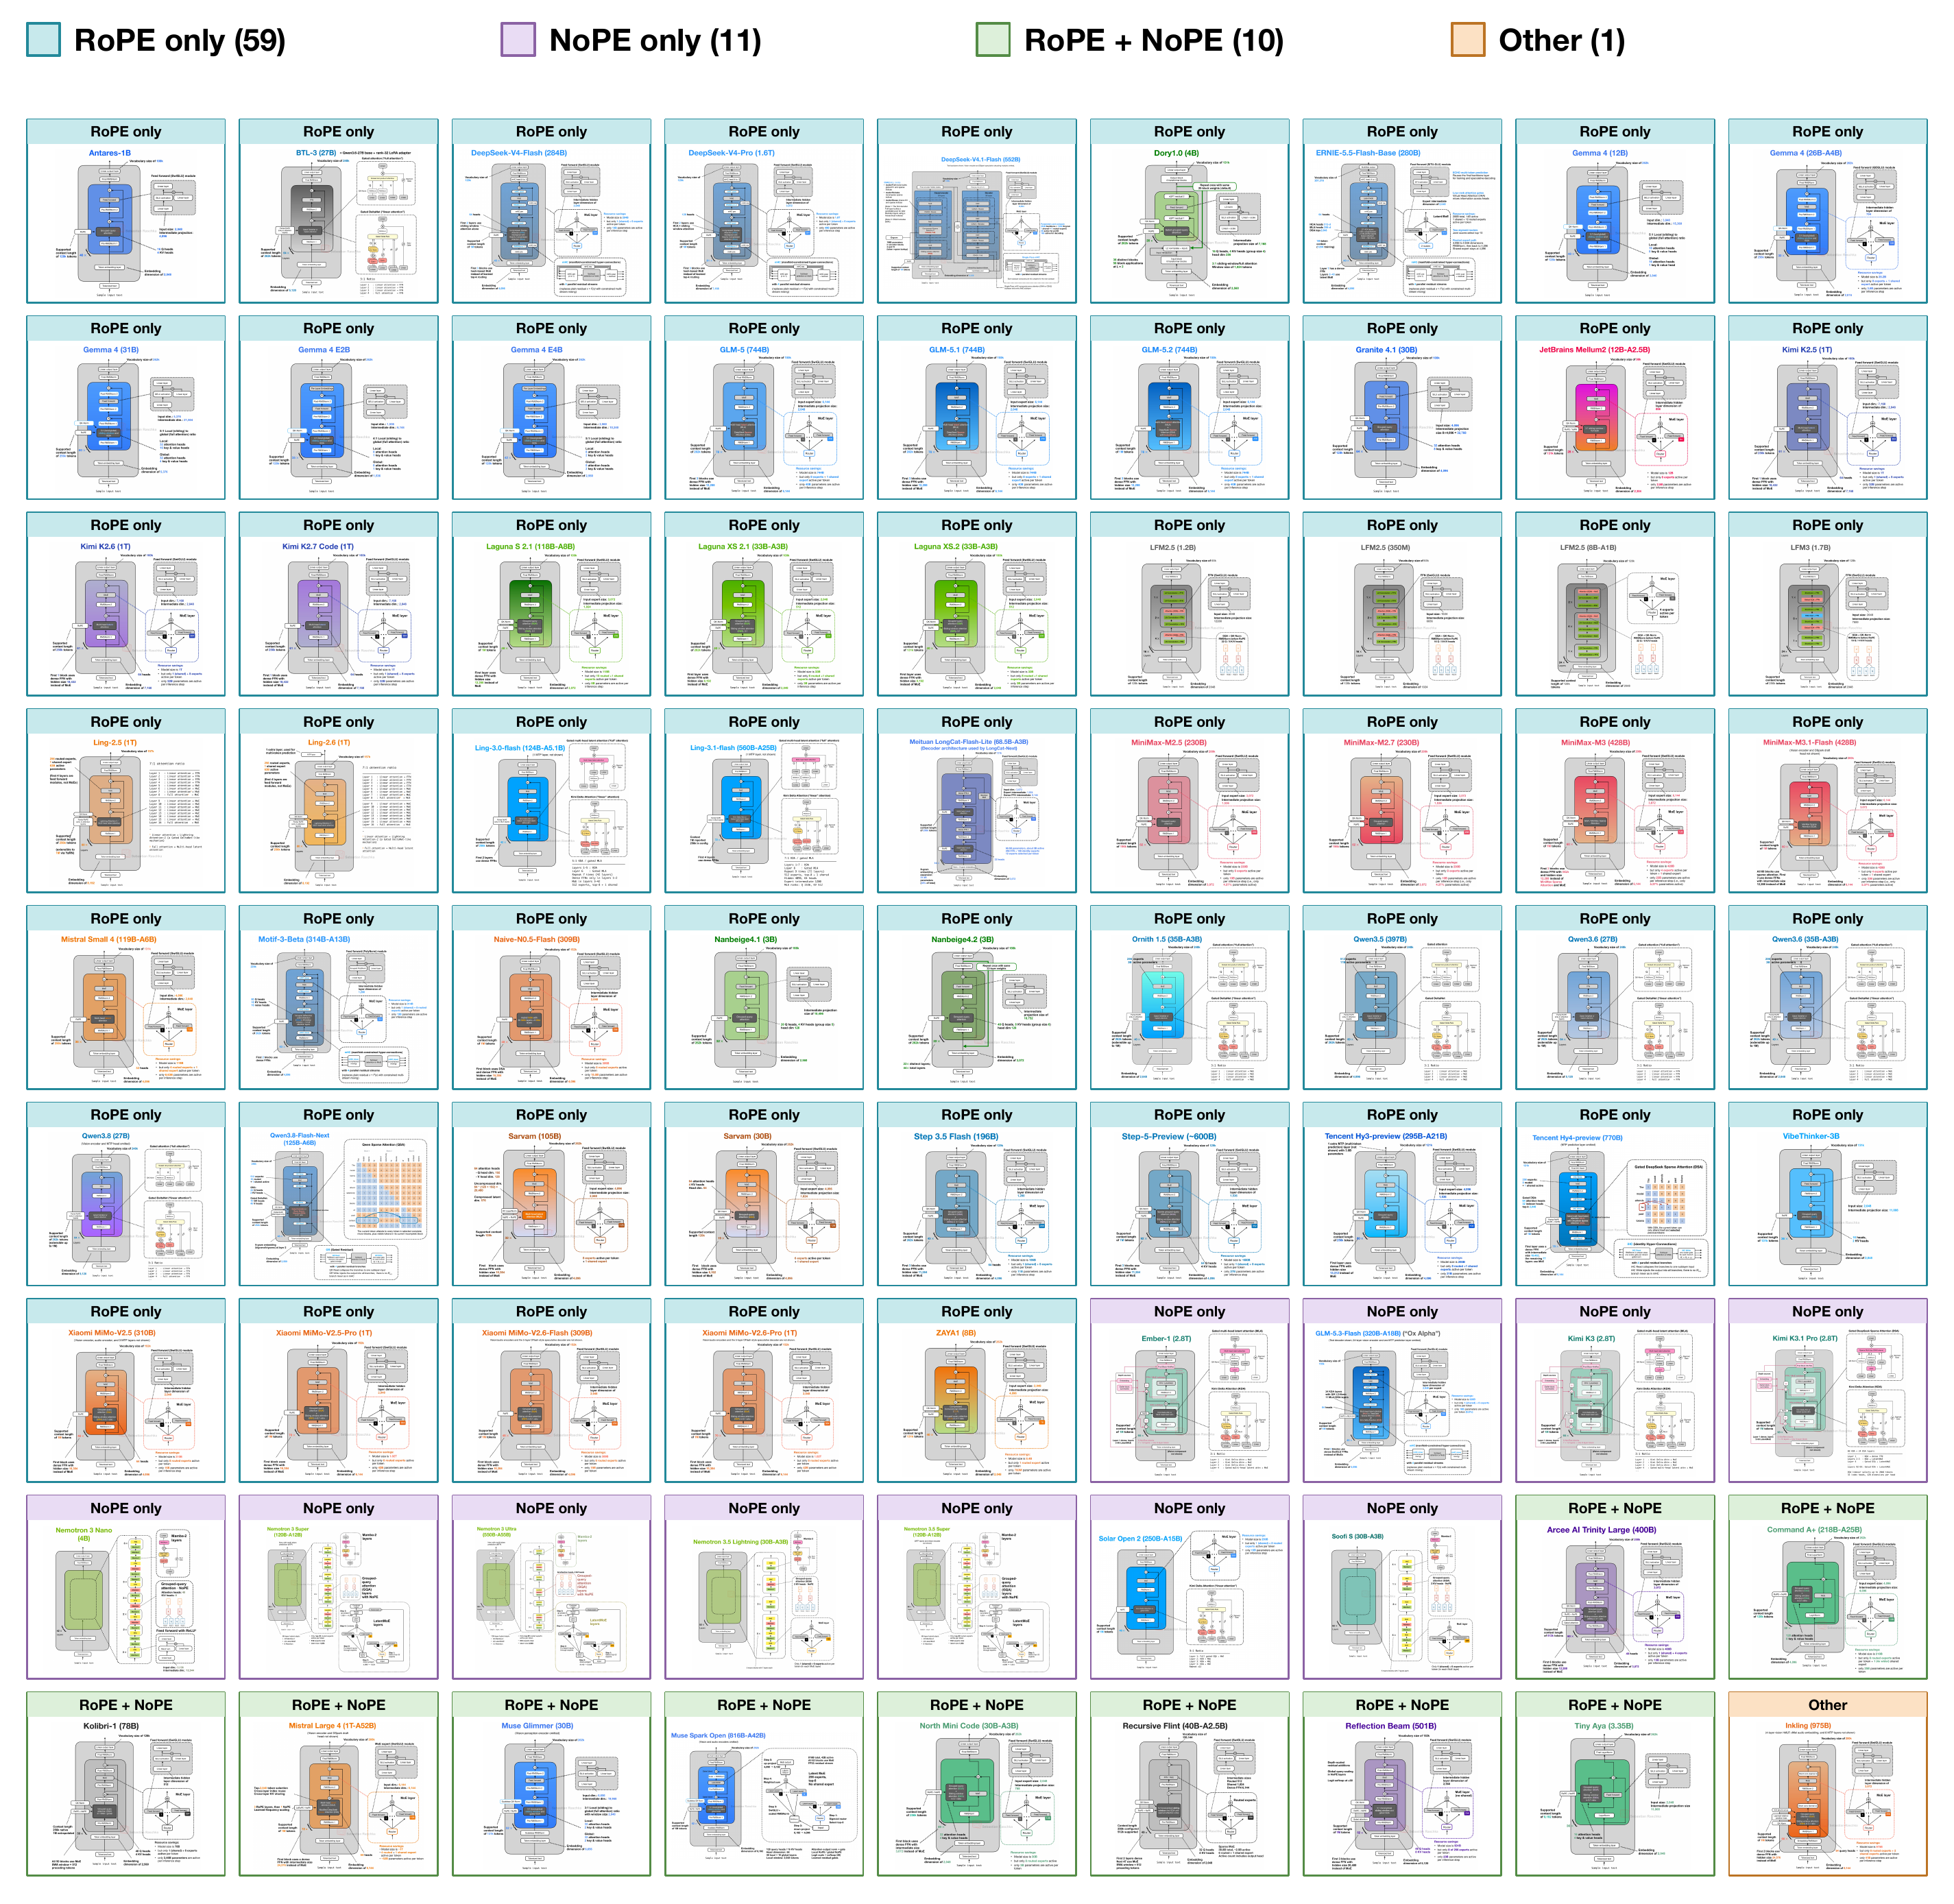
如果你想查询 2026 年组中的某个具体模型,下面的图 37 展示了 2026 年图库概览,各个架构按位置类型标注。你也可以交互式浏览图库这里。
那么,回顾一下,我们讨论了 GPT-2 和原始 transformer,它们在第一个 transformer 块之前给每个 token 嵌入加上一个位置向量。然后,现代 LLM 转向了 RoPE,它通过旋转查询和键在注意力内部编码相对位置。令人惊讶的是,RoPE 至今仍是最流行的位置嵌入方法。
然而,最近 Inkling 从 T5 中借鉴了一个想法,在 softmax 之前给注意力分数加上一个学习到的相对位置偏置。然后我们还有 NoPE-RoPE 架构,它在某些层中省略了 RoPE。
这可能是无聊的消息,但如前所述,RoPE 仍然是主要的位置嵌入方法,我认为这肯定会延续到 2027 年。不过,也许我们会在 2027 年看到更多类似 Inkling 设计的架构出现。
虽然这听起来可能“无聊”,但我很高兴在这么多年后终于把这篇关于 RoPE(以及其他位置信息方法)的文章发出来了,这样我就可以把它加入我的 LLM“基础”讲解合集。
如果你对大语言模型的其他架构构建模块感兴趣,我仍然强烈建议从 GPT-2 风格的模型入手,这样你能以最小的阻力对这些构建模块建立扎实的理解。在此基础上,你可以再叠加其他方法(例如 RoPE)。
如果你想自己构建那个 GPT-2 风格的模型,我的第一Build a Large Language Model (From Scratch)这本书会逐一讲解下图所示的所有构建模块。
对于从 GPT-2 基线分支出来的各种方法,我在下面收集了一些相关的博客文章,先从自注意力回顾开始:
自注意力、因果掩码和多头注意力:理解并编写大语言模型中的自注意力、多头注意力、因果注意力和交叉注意力
现代注意力变体(GQA、MLA、滑动窗口注意力、稀疏注意力以及混合方案):现代大语言模型中注意力变体的可视化指南
KV 缓存。从零理解并编写大语言模型中的 KV 缓存
SwiGLU 前馈层与归一化(LayerNorm 和 RMSNorm):从 GPT-2 到 gpt-oss:解析架构演进
混合专家层与专家路由。大语言模型架构大比较
残差连接与 DeepSeek 的流形约束超连接(mHC):大语言模型架构的最新进展:KV 共享、mHC 与压缩注意力
在 Qwen3 中把部分组件组合起来:从零理解并实现 Qwen3逐步讲解如何在 PyTorch 中实现稠密版和混合专家版。
感谢阅读并支持我的工作!
PS:我开始尝试 Substack 新的“perks”系统。作为对支持者的感谢,我添加了图像导出和元数据来自架构图库,供你在自己的分析中使用。