LFM3是我们新一代的 Liquid Foundation Models(LFMs),旨在成为专用智能的起点。它将文本、视觉、音频、全模态和决策模型统一到一个共享骨干上,全部处于 2B 参数范围内。这意味着你可以为你的模态选择模型,在单块 GPU 上用你自己的数据对其进行微调,并将其部署到你的应用运行的地方。
与之前的 LFM2 系列相比,LFM3 带来了四项主要变化:
- 每参数能力更强:新的三混合架构和训练配方使 LFM3-1.7B 在参数少 35% 的情况下超越 LFM2.5-2.6B。
- 所有模态共用一个骨干:六个 2B 级模型(文本、视觉、音频、全模态和决策)均从 LFM3-1.7B-Base 训练而来,其中包括我们的首个全模态模型,以及视觉模型的视频输入。
- 为边缘而构建:文本模型在 4-bit 精度下仅占约 1 GB,新的自研视觉和音频编码器加快了处理速度,文本模型的 256K 上下文窗口让智能体可以在设备端运行。
- 为专用化而打造:每个模型都能在单块 GPU 上微调,因此你可以将其适配到你的数据、术语和部署环境。
我们如何构建更具表达力的骨干
LFM2 表明,短卷积与注意力的混合架构可以在设备端快速运行,同时不牺牲质量。对于 LFM3,我们使用硬件在环架构搜索,针对智能体用例重新设计了该架构,这些用例需要更高的每参数能力和长上下文下的快速推理。搜索现在覆盖 14 种设备和后端组合,从手机和 Raspberry Pi 5 到笔记本电脑、云 CPU、GPU 以及 Qualcomm Hexagon NPU。

LFM3-1.7B-Base 有 24 层,包含四项主要变化:
- 三混合层组合:13 个门控短卷积、5 个窗口为 256 token 的滑动窗口注意力(SWA)层,以及 6 个全局注意力层。卷积的核大小从 LFM2 的 3 提升到 7。
- 逐头门控注意力:一个 sigmoid 门控对每个头的输出进行缩放,因此当头没有可贡献的内容时可以关闭。这有助于抑制损害量化的激活离群值。
- 部分 RoPE:全局注意力层只对每个头的最高频一半做旋转,因此另一半无论距离多远都按内容匹配。SWA 层保留完整的 RoPE。
- 三明治归一化:每个模块对其输入和输出都做归一化,以保持激活值处于良好尺度。
收益在长上下文时显现。按参数量计算,LFM3-1.7B 在边缘设备上的短提示上与 LFM2-1.2B 持平,而在上下文为 8K token 时约快 25%。LFM3-1.7B-Base 在 22T token 上预训练,使用与以下模型相同的 128K 词表:LFM2.5-8B-A1B。最后 3.5T token 是在精选数据上进行的中期训练阶段,其中智能体轨迹和工具调用的占比更高,同时将上下文窗口扩展到 256K token。
一个骨干,六个模型
每个 LFM3 模型都从 LFM3-1.7B-Base 分支而来。你无需运行一个大型通用模型,而是选择适合你输入的那个,对其进行定制,并在设备端运行。

| 模型 | 输入 | 输出 | 基于 |
|---|---|---|---|
| LFM3-1.7B | 文本 | 文本 | LFM3-1.7B-Base |
| LFM3-VL-2B | 文本、图像、视频 | 文本 | LFM3 骨干 + 视觉编码器 |
| LFM3-Audio-2B | 文本、音频 | 文本、语音 | LFM3 骨干 + 音频编码器、音频解码器和 LiquidCodec |
| LFM3-Omni-2B | 文本、图像、视频、音频 | 文本、语音 | LFM3 骨干 + 视觉和音频编码器以及音频解码器 |
| d1-2B | 文本、图像、视频 | 校准后的答案 | LFM3-VL-2B |
| d1-omni-2B | 文本、图像、视频、音频 | 校准后的答案 | LFM3-Omni-2B |
视觉和音频模型还获得了两个新的自研编码器:
- 视觉编码器:它结合了卷积和注意力,计算量比之前 LFM VL 模型中的 SigLIP2 编码器少 3 倍。我们 164M 参数的编码器在准确率上与 Qwen3.5-2B 的视觉编码器持平,而所需 FLOPs 少 2.2 倍(两者均使用相同的 LFM2.5-230M 语言骨干测量)。对于视频,它将每对采样帧嵌入到一个时间切片中,使时间序列长度减半。
- 音频编码器和 LiquidCodec:音频编码器混合了滑动窗口注意力和短卷积,并且完全因果,因此模型可以在你说话时进行预填充,首 token 时间低至 50 ms。LiquidCodec 是我们新的音频分词器,在 Apple M4 Max 的单 CPU 线程上以约 87 倍实时速度将生成的 token 转换为语音,并支持流式解码。
如何使用 LFM3 模型
每个模型都运行在transformers。以下片段来自模型卡片,卡片中还列出了每个模型支持的其他推理引擎。
LFM3-1.7B
当你需要本地智能体、工具调用、结构化输出,或需要一个用于领域特定微调的基础模型时,可以选择 LFM3-1.7B。它经过后训练,可在 Hermes Agent、Pi 和 OpenClaw 等智能体框架中运行。它以少 35% 的参数超越了前代 LFM2.5-2.6B,提升最大的地方在智能体任务上:在 WebArena-Verified 上,它得分 38.42,而前代为 3.02,它甚至在浏览器和商业应用中的长任务上击败了 Qwen3.5-9B。更多细节可在LFM3-1.7B 模型卡片中找到。
要运行 LFM3-1.7B,请安装最新版本的transformers:
pip install -U transformers
然后加载并运行该模型:
from transformers import pipeline

generator = pipeline(
    "text-generation",
    model="LiquidAI/LFM3-1.7B",
    trust_remote_code=True,
)

messages = [{"role": "user", "content": "What is C. elegans?"}]
output = generator(
    messages,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.1,
    max_new_tokens=2048,
)
print(output[0]["generated_text"][-1]["content"])
关于本地智能体设置,请参阅智能体框架指南。
LFM3-VL-2B
当你需要设备端视觉理解时,可以选择 LFM3-VL-2B。它是首个接受视频输入的 LFM 视觉模型;它在回答前会逐步推理,能找出物体并推理它们的摆放方式,是机器人技术的坚实基础。与 LFM2.5-VL-3B 相比,它的参数更少(1.9B 对 3.1B),却将 62 个视觉基准测试的平均分从 57.6 提升到 71.4,与 Gemma 4 12B 持平,而后者规模是它的六倍多。更多细节可在LFM3-VL-2B 模型卡片中找到。
要运行 LFM3-VL-2B,请安装 transformers>=5.21.0 及其视觉依赖:
pip install "transformers>=5.21.0" torch torchvision pillow
然后加载并运行该模型:
import torch
from transformers import AutoModelForImageTextToText, AutoProcessor

model_id = "LiquidAI/LFM3-VL-2B"

model = AutoModelForImageTextToText.from_pretrained(model_id, dtype=torch.bfloat16, device_map="auto", trust_remote_code=True)
processor = AutoProcessor.from_pretrained(model_id, trust_remote_code=True)

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "url": "https://placecats.com/300/200"},
            {"type": "text", "text": "Describe this image."},
        ],
    }
]

inputs = processor.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
).to(model.device)

with torch.inference_mode():
    output_ids = model.generate(
        **inputs,
        do_sample=True,
        temperature=0.1,
        top_k=50,
        repetition_penalty=1.1,
        max_new_tokens=16384,  # generate() 需要显式限制;推理过程可能很长
    )

generated_ids = output_ids[:, inputs["input_ids"].shape[1] :]
print(processor.batch_decode(generated_ids, skip_special_tokens=True)[0])
请参阅LFM3-VL-2B 模型卡片了解工具调用、工具搜索以及使用 llama.cpp 进行设备端推理。
LFM3-Audio-2B
当你需要在笔记本电脑或边缘设备上进行语音聊天、语音识别、语音合成或 18 种语言的翻译时,可以选择 LFM3-Audio-2B。它以文本或音频作为输入,并以文本、语音或两者兼有的形式回应,还能把语音请求转化为工具调用。与 LFM2.5-Audio-1.5B 相比,它使用了新的自研音频编码器和语音编解码器,语音质量更高(UTMOSv2 3.83 对 3.22),并新增了音频理解、通用音频推理和工具调用能力。更多细节可在LFM3-Audio-2B 模型卡中找到。
要运行 LFM3-Audio-2B,请安装transformers>=5.20.2及其音频依赖:
pip install "transformers>=5.20.2" torch accelerate librosa soundfile
直接从 Hugging Face Hub 加载模型和处理器:
import torch
import soundfile as sf

from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "LiquidAI/LFM3-Audio-2B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModelForMultimodalLM.from_pretrained(
    model_id, dtype=dtype, device_map=device, trust_remote_code=True
).eval()
processor = AutoProcessor.from_pretrained(model_id, trust_remote_code=True)
codec = processor.audio_tokenizer.to(device=device).eval()
然后大声提出一个问题,并以文本和语音形式获得回复:
conversation = [
    {"role": "system", "content": "以文本和音频交错的形式回复。"},
    {"role": "user", "content": [{"type": "audio", "audio": "question.wav"}]},
    {"role": "assistant", "content": "<|mixed_start|>"},
]
inputs = processor.apply_chat_template(
    conversation,
    continue_final_message=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
).to(device)
with torch.no_grad():
    outputs = model.generate(
        **inputs,
        max_new_tokens=1024,
        audio_temperature=1.0,
        audio_top_k=128,
        audio_repetition_penalty=1.1,
        audio_repetition_window=4096,
        return_dict_in_generate=True,
    )

    text = processor.decode(
        outputs.sequences[0, inputs["input_ids"].shape[1]:],
        skip_special_tokens=True,
    )
    waveform = codec.decode(
        outputs.audio_codes[:1, :, :outputs.audio_lengths[0]]
    ).audio_values[0]  # 24 kHz
print(text)
sf.write("reply.wav", waveform.float().cpu().numpy(), 24_000)
参见LFM3-Audio-2B 模型卡了解实时语音识别、语音合成、音频理解和工具调用。
LFM3-Omni-2B
当你需要一个能看、能听、能回话的端侧模型来替代单独的 ASR 模型、视觉语言模型、LLM 和 TTS 模型时,可以选择 LFM3-Omni-2B。它可以回答关于图像的语音提问,可以同时观看和聆听视频,还能把它看到和听到的内容转化为工具调用。这是我们的首个全模态模型,支持文本、视觉和音频输入,以及文本和语音输出,并保留了独立 LFM3 模型的核心能力,包括视觉问答、语音识别、语音合成和指令遵循。与 LFM3-Audio-2B 一样,它通过 LiquidCodec 发声,该编解码器将生成的 token 转化为语音的速度快于实时,因此语音回复会随模型生成而流式输出。在音视频视频理解方面,它在 Daily-Omni、WorldSense 和 AV-SpeakerBench 上击败了参数量最高达 10.7B 的模型,例如 Qwen2.5-Omni-7B。更多细节可在LFM3-Omni-2B 模型卡中找到。
要运行 LFM3-Omni-2B,请安装transformers>=5.20.2及其视觉和音频依赖:
pip install "transformers>=5.20.2" torch torchvision torchcodec accelerate pillow librosa soundfile
import torch
import soundfile as sf

from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "LiquidAI/LFM3-Omni-2B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModelForMultimodalLM.from_pretrained(
    model_id, dtype=dtype, device_map=device, trust_remote_code=True
).eval()
processor = AutoProcessor.from_pretrained(model_id, trust_remote_code=True)
codec = processor.audio_tokenizer.to(device=device).eval()
然后通过语音就一张照片提问:
conversation = [
    {
        "role": "system",
        "content": "回答关于所提供图像的问题。每个答案都只能基于可见内容。以文本回复。",
    },
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "photo.jpg"},
            {"type": "audio", "audio": "question.wav"},
        ],
    },
]
inputs = processor.apply_chat_template(
    conversation,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
).to(device)

with torch.no_grad():
    outputs = model.generate(**inputs, max_new_tokens=1024, generation_mode="text")

print(processor.decode(
    outputs.sequences[0, inputs["input_ids"].shape[1]:outputs.sequence_lengths[0]],
    skip_special_tokens=True,
))
参见LFM3-Omni-2B 模型卡了解语音输出、带音轨的视频以及工具调用。
d1-2B 和 d1-omni-2B
当你需要快速、结构化的决策而非生成文本时,请选用 d1 模型。给它们一个情境(一张支持工单、一张发票、一个应用界面、一张照片、一条语音留言)和一组问题,它们会在单次前向传播中回答所有问题,每个答案都带有校准后的概率。除了是/否、选项和分数之外,它们现在还能指向物体、从文档中读取数值、估算带范围的数字,并选出所有适用选项。你可以在以下模型卡中找到更多细节d1-2B和d1-omni-2B。
在两个 d1 模型之间:
- d1-2B:选择它用于文本、图片和视频。它以少三分之一的参数取代d1-3B,并在我们全部四个决策套件上得分更高,例如在 ImajevBench 上为 75.5 对 64.0。
- d1-omni-2B:当你的输入包含音频时选择它。如果你用语音而非文字提问,它几乎能保持全部准确率。
要运行 d1-2B,请安装transformers>=5.19及其视觉依赖:
pip install "transformers>=5.19" torch torchvision pillow
然后加载 d1-2B,并在单次传播中就一张支持工单提出多个问题:
import torch
from transformers import AutoModel

device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"
dtype = torch.float32 if device == "cpu" else torch.bfloat16
model = AutoModel.from_pretrained("LiquidAI/d1-2B", trust_remote_code=True, dtype=dtype).to(device)

# 针对一个状态的多个具名问题,在单次传播中回答
questions = {
    "refund": {"type": "noul", "instructions": "客户是在要求退款吗?"},  # 是/否:P(yes)
    "team": {"type": "choice", "instructions": "应该由哪个团队处理此事?",
             "criteria": {"billing": "收费、退款、发票", "shipping": "配送和包裹",
                          "technical": "应用或网站故障"}},
    "topics": {"type": "choice", "multiple": True, "instructions": "这条消息涉及哪些主题?",
               "criteria": {"billing": "付款和收费", "delivery": 配送与包裹,
                            登录: 登录账户}},
    紧急程度: {类型: 分数, 说明: 这张工单有多紧急?, 标准: [低, 中, 高]},
}
out = model.system_one(我被重复扣款了,而且包裹一直没送到。请退还其中一笔费用。, questions)
a = out[答案]
urgency = a[紧急程度][图例][str(int(a[紧急程度][分数]))]
print(round(a[退款][noul], 2), a[团队][选择], a[主题][选项], urgency)
# 1.0 账单 ['billing', 'delivery'] 中
为简洁起见,我们只包含 d1-2B 的示例。参见d1-omni-2B 模型卡了解音频片段和口语问题。
为你的任务微调 LFM3
LFM3 生来就是为了专用化。前沿模型是强大的通才,但它们未必是你用例中的专家。LFM3 将额外容量装入一个小而快的模型,因此一次简短的微调就能把它变成你任务上可靠的专家,掌握你的数据、术语和工具。由于它体积小,你可以把微调后的模型部署在应用运行的地方,从设备到私有基础设施再到云端。
每个模型都能在单块 GPU 上微调,这些 notebook 会带你走完文本、视觉、音频和全模态模型的完整任务流程,从数据准备到评估。
| 模型 | 方法 | 任务 | Notebook |
|---|---|---|---|
| LFM3-1.7B | SFT | 从杂乱文档中提取结构化 JSON | 在 Colab 中打开 |
| LFM3-1.7B | DPO | 基于检索到的文档作答,或拒绝回答 | 在 Colab 中打开 |
| LFM3-1.7B | GRPO | 在包含 108 个工具的手机应用中调用正确的工具 | 在 Colab 中打开 |
| LFM3-1.7B | CPT | 从原始文本学习一门新语言(土耳其语) | 在 Colab 中打开 |
| LFM3-VL-2B | SFT | 将收据照片读取为 JSON | 在 Colab 中打开 |
| LFM3-VL-2B | GRPO | 将方程图像转写为 LaTeX | 在 Colab 中打开 |
| LFM3-Audio-2B | SFT | 将口语智能家居指令映射为函数调用 | 在 Colab 中打开 |
| LFM3-Audio-2B | SFT | 教模型一种新声音 | 在 Colab 中打开 |
| LFM3-Omni-2B | SFT | 将口语智能家居指令映射为函数调用 | 在 Colab 中打开 |
| LFM3-Omni-2B | SFT | 回答关于医学图像的口语问题 | 在 Colab 中打开 |
示例:教 LFM3 行动
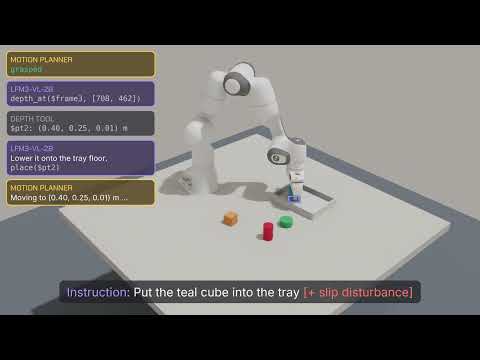
我们将 LFM3-VL-2B 改编为三个互补的机器人模型,分别用于编排、导航和操作编排器通过工具调用操作机械臂:它通过指向来定位物体,用深度工具测量它们,调用运动规划器,并在后续相机图像中检查结果。导航器利用最近的 RGB 观测遵循路线描述,仅用五个 token 预测空间目标和航点轨迹。操作 VLA 在单次前向传播中将图像、语言和机器人状态映射为八步连续动作块。该 VLA 在 15 种具身形态上联合训练,在四个 LIBERO 套件上达到 96.2% 的平均成功率,在 RoboCasa-GR1 桌面任务上达到 45.7%,并在搭载 TensorRT FP16 的 Jetson AGX Orin 上以不到 50 ms 生成动作块。这些结果凸显了 LFM3-VL-2B 作为机器人领域紧凑基础模型的潜力,涵盖从高层规划到低层控制,并能在嵌入式硬件上实时生成动作。
观看 LFM3-VL-2B 在以下场景中处理感知、导航和操作此演示视频。
开始使用 LFM3
所有 LFM3 模型均为开源权重,现已在 Hugging Face 上提供:
- 下载:Hugging Face 上的LFM3 合集,包括LFM3-1.7B-Base,用于你自己的后训练。
- 微调:使用我们的微调 notebook将 LFM3 适配到你的任务。
- 在你的 harness 中使用:遵循我们的指南了解如何运行本地智能体,例如 OpenClaw、Hermes Agent 和 Pi。
我们迫不及待想看到你构建的作品。
引用
如果你使用本工作,请引用发布博客:
@article{liquidAI2026LFM3,
  author = {Liquid AI},
  title = {Introducing LFM3: Every Modality for Specialized Intelligence},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/lfm3},
}