我们的最新版本 Apertus 1.5 在 8B 和 70B 的 Apertus 1.0 模型基础上扩展了图像/音频理解能力、可选的思考模式、四倍长的上下文窗口、改进的指令遵循能力以及更好的工具使用能力。更新后的8B 和 70B 模型权重已于 2026 年 7 月 24 日以 Apache 2.0 许可证发布到 Hugging Face。更多细节现可从项目技术报告中获取,并在此处进行了总结。
Apertus 1.5 是对第一代模型的持续预训练:为 8B 模型新增 4 万亿 token 的文本和多模态训练数据,为 70B 模型新增 2 万亿 token,总计分别达到 19T 和 17T。与每一次 Apertus 发布一样,这些模型完全开放:开放权重、开放数据、开放价值观,以及完整的训练细节。
关键增强
- 原生多模态理解:Apertus 1.5 可同时接受图像、音频和文本,将文档、图表和照片带入对话。模型还能处理口语语言,不过这仍处于实验阶段。
- 思考模式:模型可切换到思考模式,在回答前对输入进行推理,从而提升在推理问题上的表现。
- 长上下文:上下文窗口增长至 262,144 token,是 Apertus 1.0 的 4 倍。
- 改进的指令遵循:比 Apertus 1.0 更好的指令遵循能力,带来更可预测、更准确的回答。
- 改进的工具使用:模型经过训练以实现更好的工具集成,从而更有效地使用外部工具和 API。
- 开放价值观:更严格地遵循 Apertus 章程,使模型的价值观和原则更加透明。
训练过程
 完整的 Apertus 1.5 训练流程
通过分词器实现多模态
我们在 v1.5 模型中以早期融合的方式引入多模态:图像和音频以离散 token 的形式与文本 token 进入同一序列,而非使用单独的视觉编码器。图像使用Emu3.5分词器进行分词(一张 512×512 图像变为 1,024 个 token),音频则使用WavTokenizer(每秒 40 个 token)。我们只扩展词表,因此架构保持不变,训练以纯文本速度运行。模型能理解图像和音频,但只生成文本。

预训练
从 Apertus 1.0 出发,我们分四个阶段继续预训练:
- 非配对:文本加上独立的图像和音频,让模型学习新的模态。
- 配对:图像–描述和音频–转写配对,让模型将它们与语言对齐。
- 冷却:更高质量的数据,包含更多数学和代码。
- 长上下文:窗口从 8k 逐步增长到 262k token。
总体而言,超过一半的训练 token 是纯文本,这保留了 Apertus 1.0 的语言能力。文本数据用以下来源刷新,例如FineWeb2-HQ+、FinePDFs 和 Nemotron-CC。所有新数据(包括多模态数据)都达到与之前相同的标准:公开可用、采用宽松许可,并追溯性地遵守 robots.txt 的退出选项。每个来源都列在apertus-data-transparency中。
后训练
后训练分五个阶段进行:SFT → 长上下文 SFT → RL → DPO → 章程对齐(SDPO)。
- SFT使用 370 万条文本样本以及图像和语音数据。推理轨迹只添加到模型在没有它们时已经无法解决的提示上。工具使用数据仅限于经过执行验证的轨迹。我们发布了文本 SFT 混合数据,已上传至 Hugging Face。
- 长上下文 SFT在完整的 262k 窗口下进行,恢复了短上下文 SFT 所侵蚀的长上下文能力。
- 带可验证奖励的 RL(RLVR)在约 35 万个数学、代码、指令遵循、多语言和视觉提示上进行,混合开启和关闭思考模式。
- DPO使用评委打分的偏好对,提升聊天质量、工具使用和安全性。我们发布了偏好池和训练对。
- SDPO通过评委反馈和自蒸馏,使模型与Apertus Charter对齐。
评估结果
除了扩展的模型能力,我们还显著扩大了评估范围。在 Apertus 1.0 使用的现有基于文本的评估之外,我们新增了多模态评估(图像和音频)以及思考模式评估。
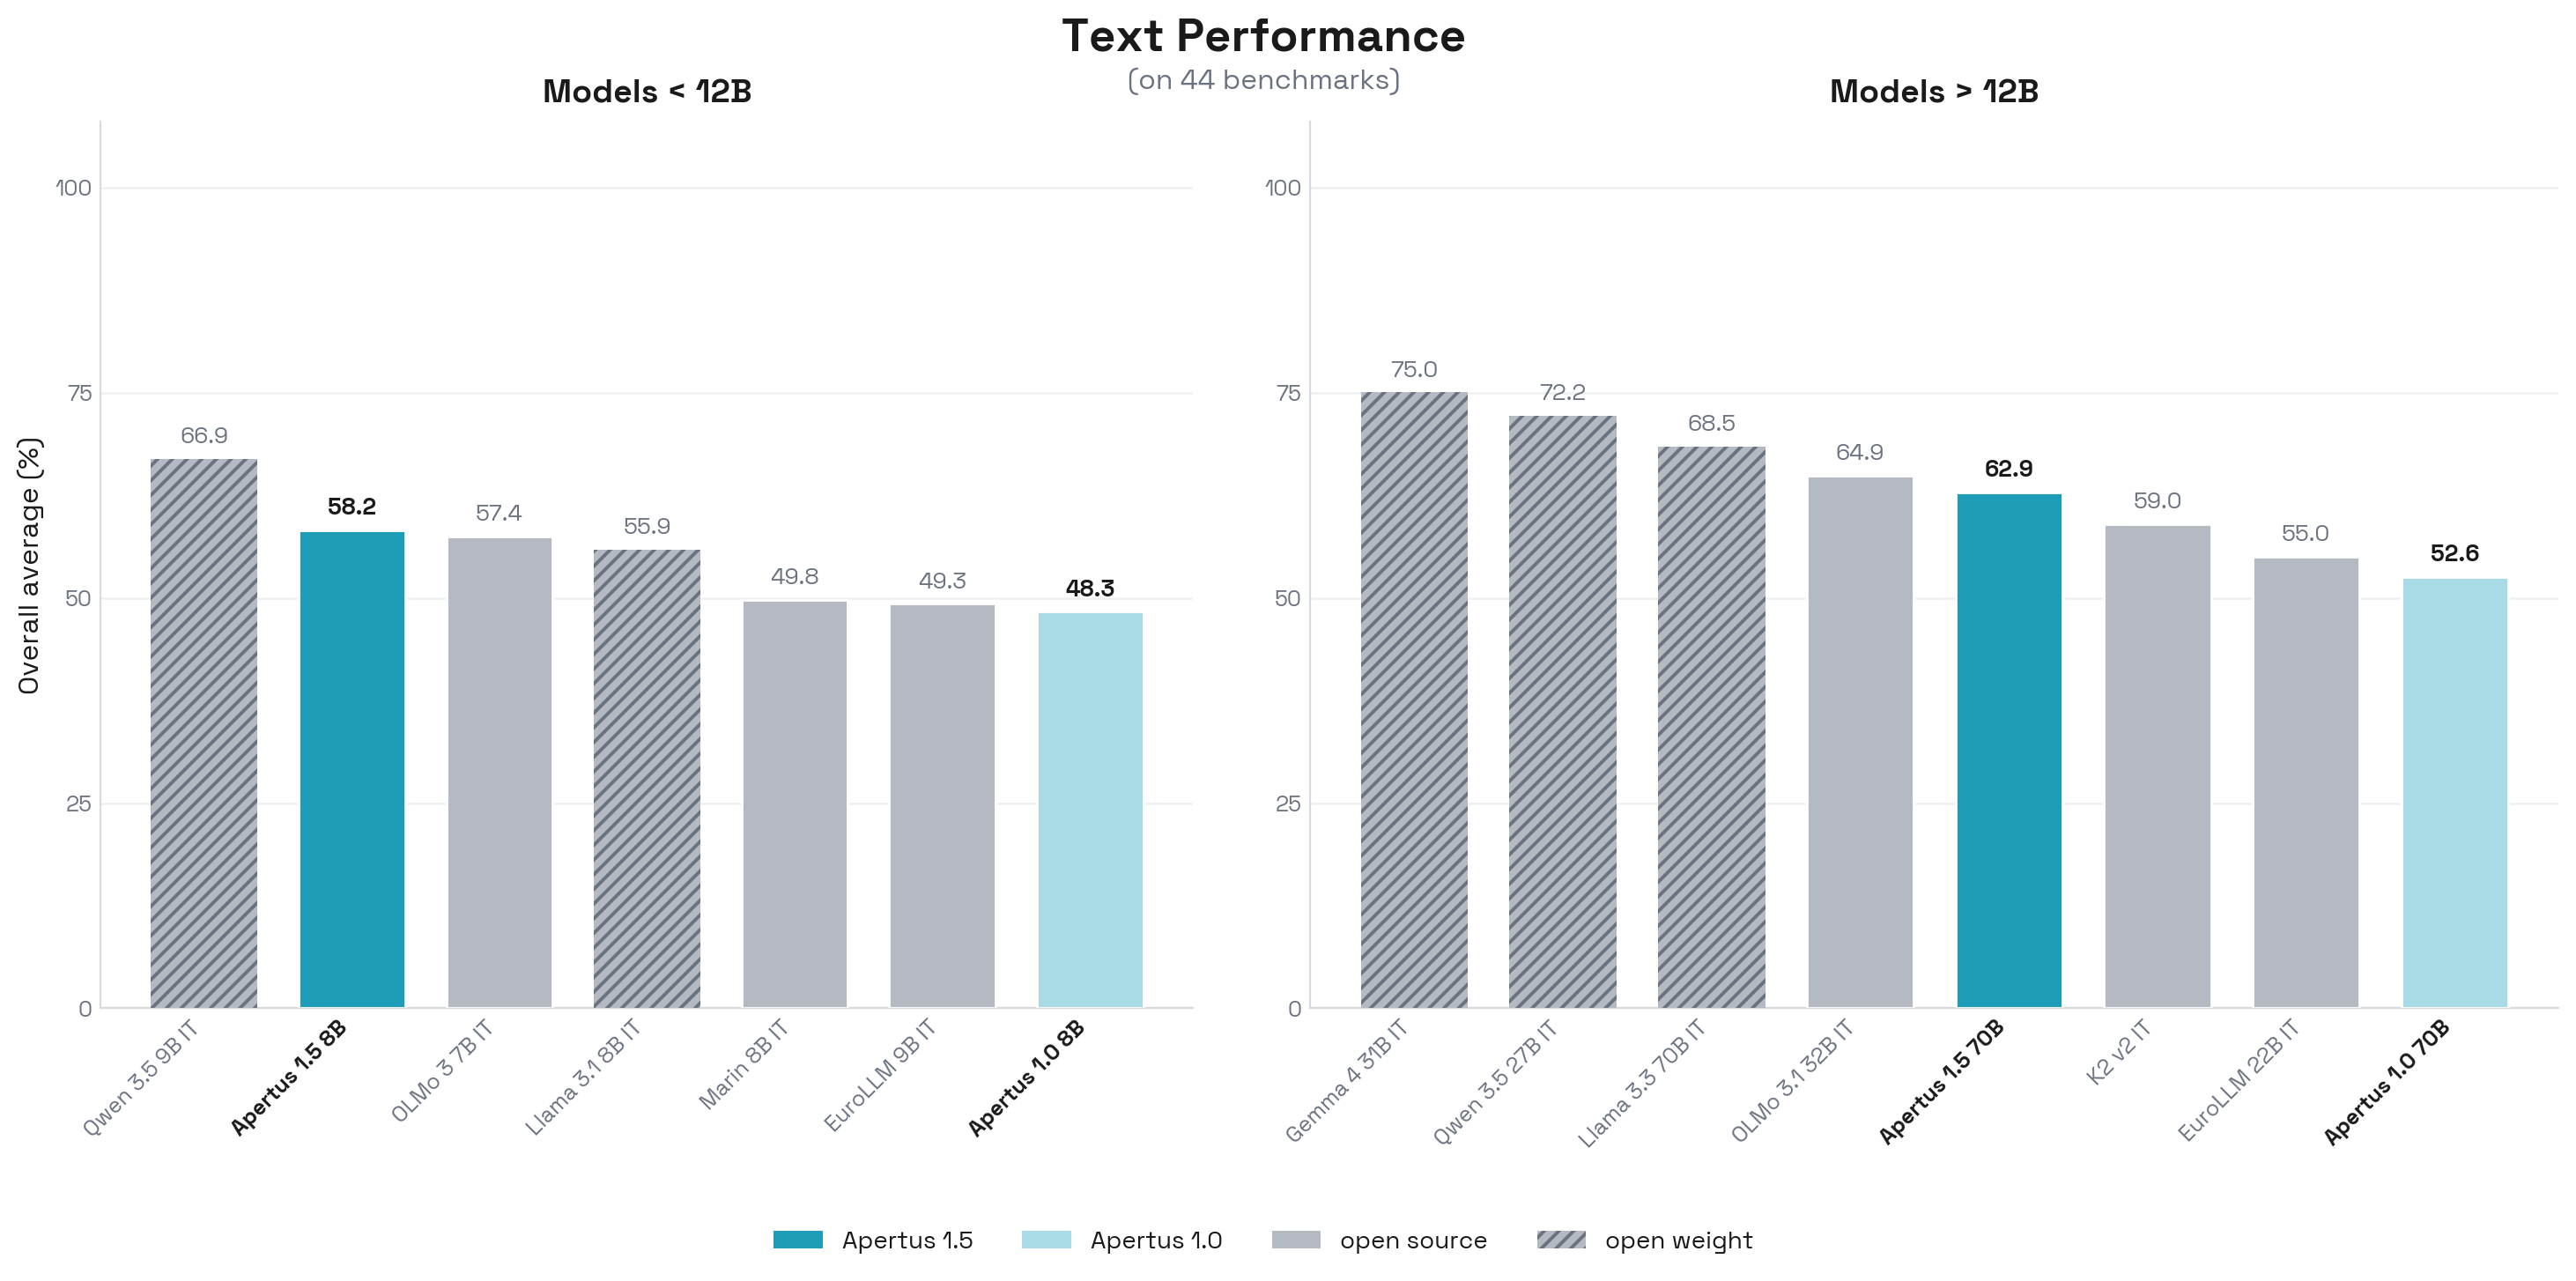
多模态评估通过MLLM-eval-suite流水线完成,合并了两个主要的多模态评估框架lmms-eval和VLMEvalKit我们还添加了一系列基于文本的基准测试,并扩展了针对翻译与多语言能力、安全性以及工具使用的基准评测。这些可以在我们的训练后评测仓库中找到,基于lm-evaluation-harness 的分支。
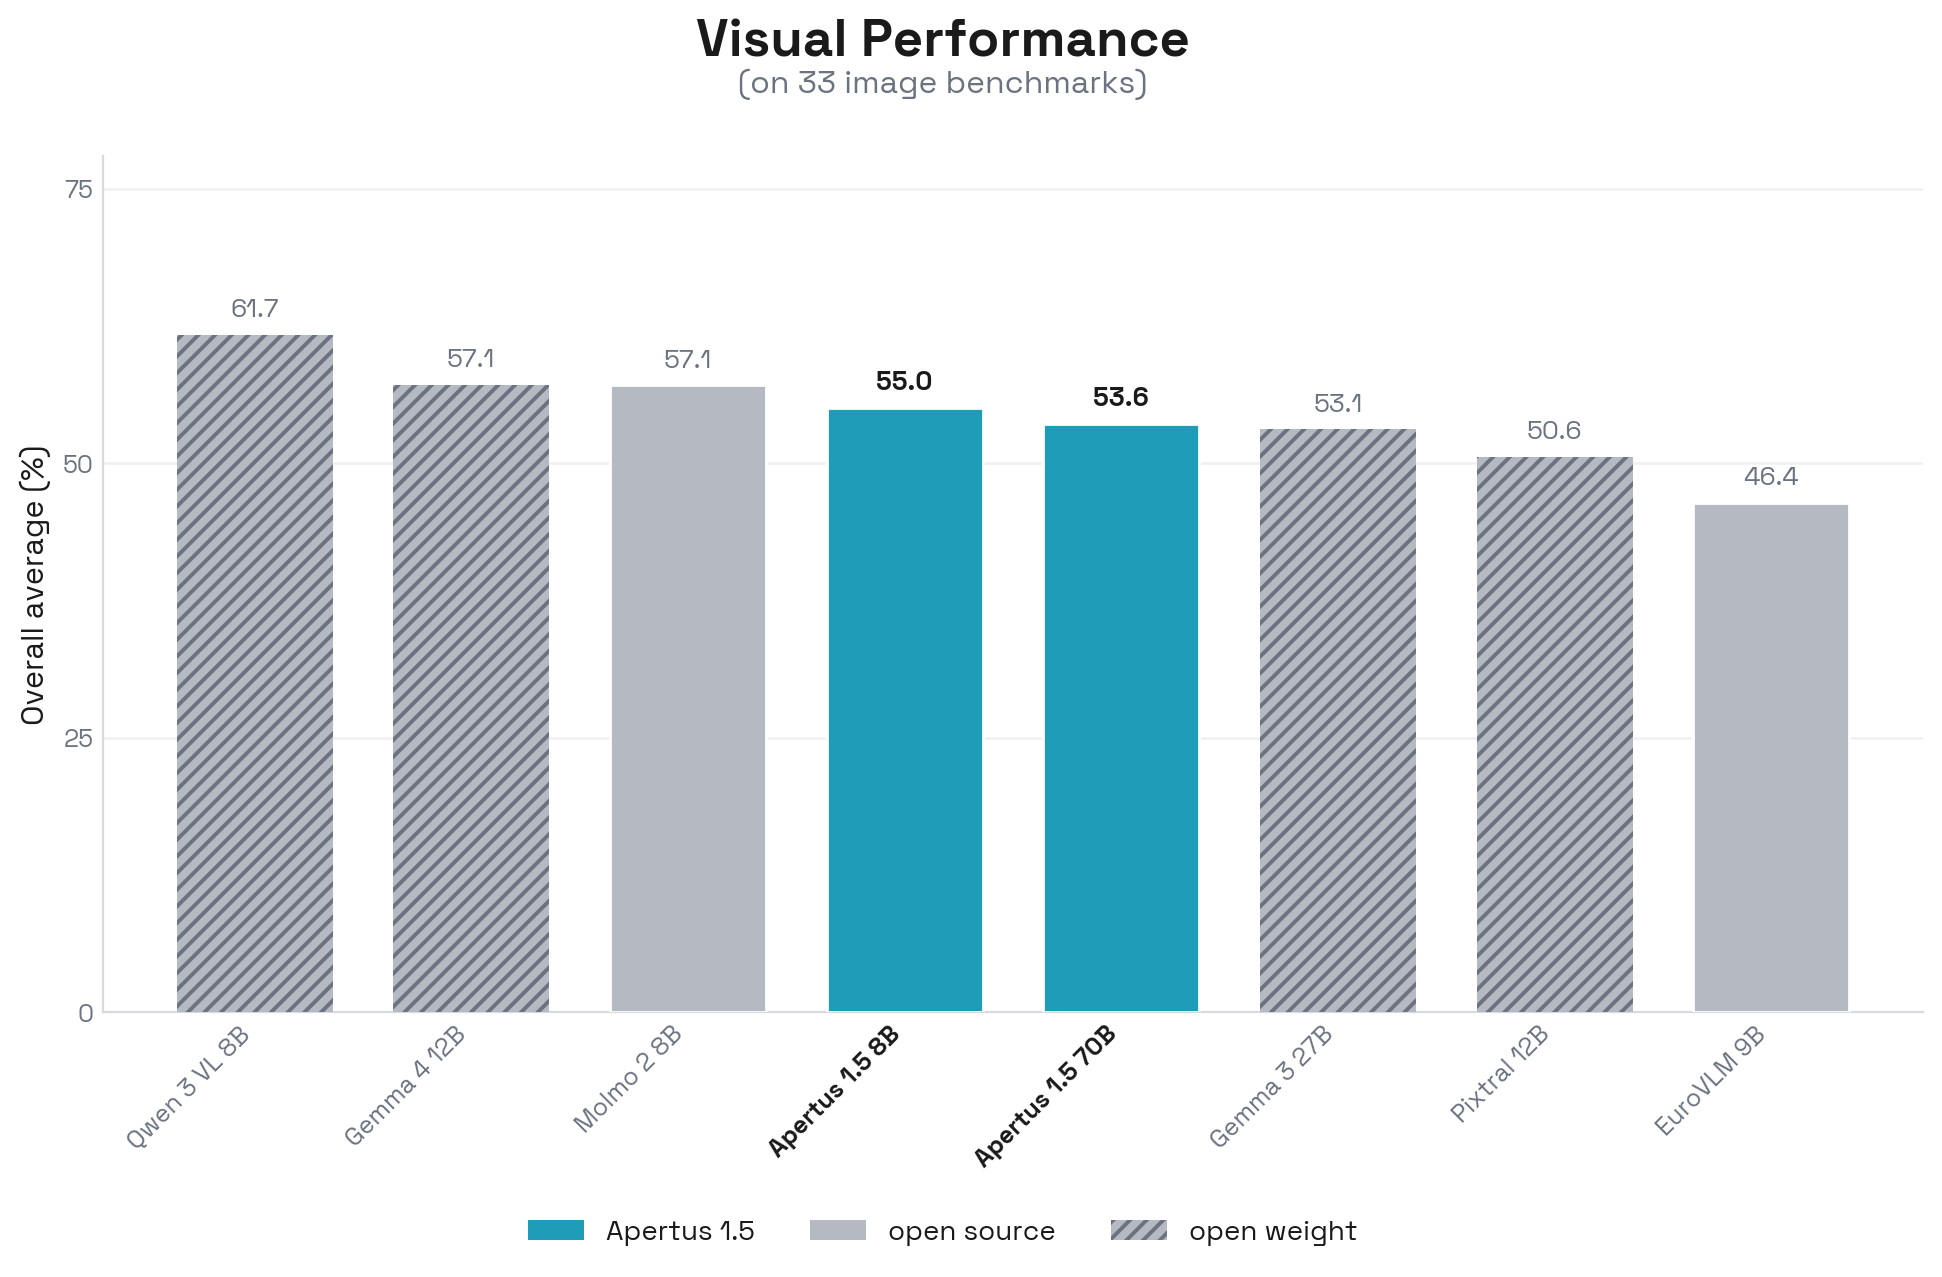
尽管仍落后于前沿开源权重模型,新版本在编码和指令遵循能力上也有显著提升,Apertus 1.5 8B 在 IF 和多语言任务上优于同等规模的开源权重模型。Thinking 进一步提升了在 AIME 等具有挑战性的推理密集型基准测试上的表现。该模型的多模态性能更接近Gemma 4 12B以及其他当前的开源权重模型。Apertus 1.5 的多模态性能在开源权重模型中的空间理解方面具有竞争力,在开源模型中的文档/图表理解方面也具有竞争力。
我们还感谢我们的合作者和外部评测者对高效基准评测 Apertus 能力所提供的帮助。特别是,Apertus 1.5 在瑞士法律任务上表现出色,与领先的开源权重模型不相上下(博客,代码)。此外,在 Last Translation Benchmark 上,Apertus 1.5 8B 展现出的机器翻译能力与GPT-OSS-20B相当,并优于Claude Haiku 4.5或Google Translate等模型(排行榜,论文)。
评测卡片:Apertus ❤️ EvalEval
Apertus 与EvalEval Coalition合作,以确保完全透明且可复现的基准评测。我们在Every Eval Ever (EEE)schema 中发布 Apertus 1.5 的结果,这是一种共享格式,不仅记录分数,还记录谁运行了评测、如何访问模型、生成设置以及每个指标应如何解读:这些细节在排行榜中经常缺失,也常常解释了为什么看似相似的分数会有所不同。
结果如下方的 Eval Card 所示,它将运行数据与基准测试和模型元数据合并为一条可解读的记录,也可通过Hugging Face Community Evals获取。这与UK AI Security Institute 用于公开发布其评测结果的基础设施相同由于我们的文本评估运行在 lm-evaluation-harness 的公开分支上,EEE 为其提供了专用转换器,因此任何人都可以重新运行这些评估,并在相同设置下将他们的数字与我们的数字进行比较。
结构化评估报告的意义也超出了研究范畴。EvalEval 已将评估卡片映射到 AI 治理要求,包括《欧盟 AI 法案》第 55 条和 GPAI 行为准则,并发现 EEE schema 能够表示这些框架所要求的 60 个评估报告要素中的 56 个。这与我们发布 Apertus 的方式一致:除了模型之外,我们还发布训练内容公开摘要,并自愿发布一份行为准则文件。机器可读的评估记录是自然的下一步:让监管机构、部署者和研究人员更容易找到、解读和比较模型背后的证据。
我们致力于通过评估卡片和 EEE schema 推动可复现、透明的评估,并鼓励其他模型开发者以同样的方式报告结果,以便分数能够在不同模型和组织之间进行比较。
Apertus 1.5 可复现性
所有配方、消融实验和数据混合方案都记录在技术报告中。我们希望通过公开并开放 v1.5 的训练过程,来推广开放模型开发。中间检查点托管在我们的Apertus 1.5 Hugging Face 集合中,包括基础权重、SFT、RLVR 和 DPO,以及我们精选的训练数据混合/自定义数据集,位于Apertus 1.5 数据集集合。共享这些内容使研究人员能够研究每个阶段如何改变模型行为。
该报告涵盖了关于后训练数据在不同阶段影响的大量消融实验,我们观察到在 SFT 期间与文本数据混合的多模态数据有助于提升所有模态的表现。我们还发现,多模态推理轨迹带来的收益在后续的纯文本强化学习中依然存在:从使用多模态轨迹训练的 SFT 检查点出发,RL 对数学能力的提升大于从纯文本检查点出发,并且推理任务上的优势在整个训练过程中持续存在。
| 模型 | 8B | 70B |
|---|---|---|
| 预训练(长上下文基础) | Apertus-v1.5-8B-base | Apertus-v1.5-70B-base |
| 监督微调(SFT) | Apertus-v1.5-8B-SFT | Apertus-v1.5-70B-SFT |
| 强化学习(RLVR) | Apertus-v1.5-8B-RL | Apertus-v1.5-70B-RL |
| 偏好对齐(DPO) | Apertus-v1.5-8B-DPO | Apertus-v1.5-70B(最终) |
| 章程对齐(SDPO) | Apertus-v1.5-8B(最终) | – |
| 阶段 | 数据 | 代码 / 配方 |
|---|---|---|
| 预训练:阶段 1–2(非配对、配对) | 所有来源及其版本和许可证见apertus-data-transparency;视觉和音频处理配方见multimodal-data | Megatron-LM,启动脚本见pretrain-code,apertus-omni-tokenizer,benchmark-image-tokenizer,benchmark-audio-tokenizer(包括交错的语音–文本构建器) |
| 预训练:阶段 3(冷却) | apertus-data-transparency;精选图像数据集NASA,Our World in Data,Smithsonian,swisstopo | Megatron-LM,启动脚本见pretrain-code |
| 长上下文扩展 | apertus-data-transparency;合成长上下文任务见LongContextQA | Megatron-LM,启动脚本见pretrain-code |
| SFT | Apertus-v1.5-SFT-mix(报告中列出的多模态 SFT 混合数据) | posttraining-data,Megatron-LM(SFT 启动脚本) |
| 长上下文 SFT | SFT 混合数据的子集(报告中列出),加上LongContextQA任务 | Megatron-LM |
| RL(RLVR) | 报告中列出的混合数据 | verl,verl-recipe |
| DPO | Apertus-v1.5-Preference-Pool(带标注的补全),Apertus-v1.5-Preference-Data(配对) | posttraining,verl |
| SDPO(章程对齐,仅 8B) | gretelai/gretel-safety-alignment-en-v1 | 自蒸馏 |
模型可用性
Proton Lumo和Infomaniak Euria是两个广泛使用的应用,最近已集成 Apertus 1.5。这些部署已链接到Community Showcase等页面中——请参阅此讨论帖以获取预览。
多家提供商已宣布以 API 形式向开发者提供 Apertus 1.5 的访问,包括Swisscom,Infomaniak,Phoeniqs,以及我们General Availability guide中列出的其他公司。报告还详细介绍了我们如何与外部评估者合作来测试和准备模型。
运行模型的技术说明见 Hugging Face 上 Apertus 各版本的模型卡,以及我们的Quickstart guide。
如何参与
感谢阅读这篇博客文章并成为我们社区的一员!我们刚刚在 Hugging Face 分析中庆祝了五百万次下载 🤗,而且并没有放慢脚步。在最近的AI+X Summit上,我们的团队在苏黎世宣布了Apertus 2.0的路线图:稀疏/MoE 架构,总参数约 600B,延长训练计划,优先方向为智能体、数学和编程。
总结一下:我们邀请你阅读我们的报告、下载模型、探索中间检查点、微调权重,并复现我们的评估。尚未在我们的出版物或网站 FAQ中涵盖的问题随时欢迎提出,我们也很想听听哪些主题对社区未来的深度探讨最有用。
如果你构建或使用 Apertus,请填写展示表单,并通过我们联系页面上的选项与我们联系。我们期待展示更多工作、了解你正在构建的内容,并听取 Apertus 可以如何改进!
引用
Project Apertus, et al. “Apertus 1.5: From Open Text Models to Open Multimodal Reasoners.” arXiv:2610.15542. Preprint, arXiv, October 11, 2026.https://doi.org/10.48550/arXiv.2610.15542。
@misc{apertus2026apertus15opentext,
      title={Apertus 1.5: From Open Text Models to Open Multimodal Reasoners},
      author={Project Apertus and Yixuan Xu and Yassine Turki and Vinko Sabolčec and Valentina Pyatkin and Tommy Chu and Sven Najem-Meyer and Sean F. Carroll and Robert Smith and Raphael Kreft and Oscar Alessandro Tazza and Oleg Lavrovsky and Nicola Irmiger and Matteo Santelmo and Marian Schneider and Juan García Giraldo and Hanna Yukhymenko and Eduard Ďurech and Davit Melikidze and Dani Tamayo and Bettina Messmer and Aryan Ahadinia and Anunay Yadav and Allen Huang and Ahmad Fraij and Alessandro Bombarda and Alex Padula and Alexander Hägele and Alexander Sternfeld and Anna Hedström and Anna Kosovskaia and Arthur Wuhrmann and Arundhati Balasubramaniam and Badr Al Mahouri and Barna Pasztor and Bartosz Szostakiewicz and Bich Ngoc Doan and Bryan Schmid and Burak Sezen and Camille Challier and Clément Charmillot and Dana Shayakhmetova and Daniel Perruchoud and David Brüggemann and David Isztl and Elia Palme and Emma Anastassova and Fabian Bösch and Faruk Zahiragić and Fawzi Roberto Mohamed and Fiona Panicali and Florian Kolly and Flynn Guerra and Francesco Monti and Frederike Lübeck and Gennaro Oliva and Haofeng Yang and Haoliang Shang and Helen El Khoury and Henrique Mendonça and Jannis Vamvas and Jérome Landolt and Jessica Lam and Jingchun Xiao and Jonathan Coles and Joshua Oyebanji and Khanh Nguyen and Konstantinos Pitas and Lasse B. Strand and Li Mi and Loïc Deslarzes and Lorenzo Baggi and Lorenzo Noci and Luca Baumann and Luca Sartori and Lukas Drescher and Marco De Negri and Marco Passerini and Mark Klein and Marko Stojanovic and Martin Majsec and Matin Ansaripour and Mattea Busato and Mauro Pellonara and Max Neuwinger and Michael Graber and Michal Tešnar and Michelle Wastl and Miguel Gila and Mikolaj Boronski and Morgane Magnin and Moritz Reihs and Mukhammadali Sayfiddinov and Nathan Ranchin and Nicolas Cuveillier and Oscar Wohlfahrt and Qianqian Zou and Rada Kamysheva and Rita Sevastjanova and Roman Machacek and Sebastian Keller and Simon Matrenok and Simon Pierre and Stefano Schuppli and Suei-Wen Chen and Szabina Horváth-Mikulas and Taliesin Perez and Thilo Spinner and Thomas Kleine Buening and Tim Robinson and Tymoteusz Kwiecinski and Vilém Zouhar and Vinzenz Thoma and Xiaozhe Yao and Yannick Metz and Yuhei Fukuhara and Yusif Askari and Zixuan Chen and Alexander Ilic and Ana Klimovic and Andreas Krause and Andrei Kucharavy and Elliott Ash and Joost VandeVondele and Martin Rajman and Mennatallah El-Assady and Thomas Schulthess and Timo Kehrer and Torsten Hoefler and Antoine Bosselut and Martin Jaggi and Imanol Schlag},
      year={2026},
      eprint={2610.15542},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2610.15542},
}