两个月前,我们发布了ExtractBench用于衡量和改进基于 schema 的文档抽取。我们从中获得的经验加速了我们的研究:在LlamaExtract v2.5 版本中,即使是我们成本最低的档位,其 value F1 也超过了 93%。
但这个基准测试也有盲点。一些真实客户带来了复杂的文档和 schema,而最初的 370 份 ExtractBench 文档从未覆盖这些内容。这就是文档抽取的长尾。这也是为什么即便 ExtractBench 上的分数逐渐逼近饱和,抽取问题仍未解决。
今天我们发布 ExtractBench Pro,这是基于那些真实长尾文档构建的扩展集。它涵盖六项新挑战,每一项都源自真实客户打破我们假设的方式。在下面的样本中,你会发现只出现在复杂图表中的数值、某一页上会改变另一页含义的规则、密集的领域术语、混乱的版式等等。僵化的流水线在 ExtractBench Pro 上举步维艰,但配备合适工具的智能体系统能够适应。
合成具有挑战性的文档
你上面看到的所有页面都是由完全确定性的流水线从零生成的。从单个种子和配置文件出发,这些流水线将合成内容与来自网络各处及我们客户的真实高难度文档的格式和风格相结合。合成数据对来源进行了匿名化处理,同时也确保了覆盖值抽取和 grounding 的高质量真值标注。
这类似于我们为最初 370 份 ExtractBench 文档中的 45 份所做的处理。然而,我们在数据变换的保真度和多样性上取得了巨大飞跃,以呈现长尾数据中所见挑战的广度。这些合成文档将数据依赖关系编织到多个页面之间,绘制复杂的图表,并加入照片和多页拼接等感知挑战。
配置
种子 2113
ECG 读数流水线
"21:08""50 到 74""A"false120


Schema 真值
{
  "doses": [
    {
      "tracing_time": string"21:08",
      "bpm_band": string"50 到 74",
      "qt_class": string"A",
      "withhold": booleanfalse,
      "permitted_mg": number120
    }
  ],
  ⋮
} 


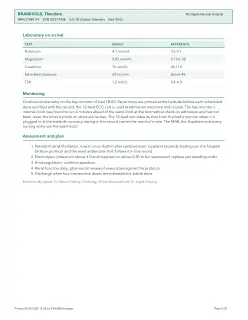
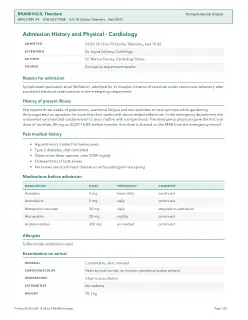
使用多样化的配置,ExtractBench Pro 中的所有 100 份文档都是这样合成的。生成的数据集被拆分为六个主要挑战,具有困难的布局和格式,需要前沿级别的智能、多步推理和高效的工具使用才能解决。
文档约定
在这个任务挑战中,文档的一部分包含诸如图例或规则之类的信息,这些信息会影响文档其余部分必须如何被解读。这些信息可以阐明符号、单位或修订必须如何处理。或者,它可以引入筛选标准,使得只有表格中的某些行才是正确提取的。文档长度增加了这一挑战的难度,因为找到相关信息(尤其是当提取器根本不知道它是否存在时)是一个大海捞针的问题。
在报告自身的单位中,AVELING POWER S A 的记录值是多少?
内部词汇
商业系统是在海量公共数据聚合上训练的,而且(但愿)不是在你组织的内部文档上训练的。当遇到你的内部术语时,重要的是找出你的具体定义(什么算作“bulk”?),而不是急于下结论。在 ExtractBench Pro 文档上,理解内部术语可以完全颠覆提取结果应该是什么。
Keelson Title & Escrow 的预订应如何分类?
内部计数规则
传统上,提取被期望专注于文档中字面出现的值,但客户有时期望我们返回通过聚合多条信息而得出的值。要实现这一点,需要智能体从 schema 和文档中读取定义,并用它们来计算计数和总和。
有多少周未达到获得全额费率所需的点数?
绘制的关系
许多现实世界的文档依赖图表。它们能以适合人类的视觉方式传达组织结构、流程、电路以及其他关系数据。然而,这也使得同样的文档对专注于 OCR 和文本的传统 LLM 来说难以处理。ExtractBench Pro 包含关系型图表,其中提取值的全部或部分取决于一条线,而非字面值。这些关系可以构成多步推理链的一部分——链越长,即使是最聪明的智能体也越容易忽略某个图表。
在审计期间,DMA-383 服务多少个计费账户?
文档内的图表
与关系型图表类似,图形能以对人类友好的方式直观地传达密集的时间序列。这不仅对 LLM 来说更难读取,而且这些文档还依赖精确的视觉来分辨细线和交点。为了让这在 ExtractBench 的数据格式中可行,我们的 schema 将连续刻度拆分为一组与坐标轴刻度线对齐的范围,并要求提取器预测在给定点上该值落在哪个范围内。一些提取器会被它们对别处书面文本的偏好所干扰。
BHA 1 在其侧向冲击极限之上钻进了多少英尺?
长图表页
视觉模型依赖其输入处于可接受的宽高比范围内。像测井曲线和时间-位置图这样的垂直数据序列,会把所有这些数据塞进一个极其狭长、窄小的页面中,从而打破这一预期。我们针对这些文档的 schema 可能要求在数百个点上取值,这要求提取器尽可能高效地策略性定位并提取每个值。
在 11,262 ft 处的伽马射线读数是多少?
结果
我们在 ExtractBench Pro 上测试了十二个系统:四个提取 API、五个编码智能体,以及我们三个层级 LlamaExtract(Cost-Effective、Agentic 和 Agentic Plus)的最新版本。与最初的 ExtractBench 一致,每份文档有 30 分钟的时间限制。失败或超过该限制的文档,其 Value 和 Grounded F1 得分均为 0。
在我们的分析中,我们发现许多文档的 Value F1 呈现双峰分布。一组提取器的得分接近 100%,而另一组提取器在同一文档上的得分则低得多。这为研究人员思考如何在 ExtractBench Pro 上爬坡提供了重要提示:一份文档在它不再难之前都是难的。失败的提取器得分低多少,取决于文档中与失败挑战相关的字段比例。因此,为了公平地衡量通过的挑战比例,我们在 ExtractBench 中新增了一个指标:Value F1 达到完美(100%)的文档比例。
- LlamaExtract
- 编码智能体
- 提取 API
- 30 分钟限制
- 无限制
以下是结果告诉我们的:
- 长尾真的很难。与 ExtractBench 相比,LlamaExtract 提取器的 Value F1 下降了 18.5 到 47.0 个百分点,Grounded F1 下降了 22.9 到 30.4 个百分点。有些提取器在 ExtractBench Pro 上没有任何一份文档达到完美。
- LlamaExtract 是低成本下的前沿。在每页低于 25 美分的情况下,我们的各档位在完美文档、Value F1 和 Grounded F1 上构成了整体的性价比前沿。只有在成本高得多的时候,我们才会被最昂贵的编码智能体超越。尽管如此,我们在绘制关系和长图表页方面仍有巨大的改进空间。
- 编码智能体很强,但很贵。它们在 ExtractBench Pro 上取得了最高的 Value F1 和 Grounded F1,而我们的前沿图说明了原因——编码智能体按每页费率消耗 token(Opus 为 41 美分,Astra 为 95 美分),这会击穿大多数真实文档提取客户的预算,而且 Claude 尤其经常需要超过 30 分钟的时间限制才能做到。
- 擅长价值提取并不会让你自动擅长 grounding。LlamaExtract 通常两者都擅长。与此同时,一些编码智能体和提取 API 在将其 Value F1 与更严格的 Grounded F1 指标进行比较时大幅下降,后者要求它们正确引用在文档中何处获得了提取结果。
但最重要的是,我们看到了全局:你给一个系统的资源、通用工具和通用智能越多,它就越能适应文档抽取的长尾。我们期待采纳这一经验,让我们的下一代 LlamaExtract 更加出色。
ExtractBench Pro 今天在与 ExtractBench 相同的渠道发布:数据集、代码和论文。在你的抽取器上运行它,并告诉我们你在长尾文档抽取方面的进展!