我第一次使用编码智能体时,我被迷住了。在智能体出现之前,我一直在 IDE 和 AI 聊天界面之间复制/粘贴。看到智能体直接编辑文件并实时修复自己的错误,真是太棒了。
几天后,蜜月期结束了,因为我遇到了频繁的 bug。智能体会完全停止响应,直到我重启它。开发工作流感觉原始得令人窒息,而且智能体常常在工作才刚刚开始时就说任务完成了。
这是在 2025 年 2 月,所以对编码智能体来说仍处于早期阶段。我以为六个月后,智能体会像底层 LLM 一样在技术上令人印象深刻。
然而,编码智能体依然很糟糕。
AI 辅助开发显然已经进步了,但模型在承担重任,而智能体仍然是瓶颈。
智能体不是模型🔗︎
在围绕 AI 的所有炒作中,术语往往会被扭曲。人们开始过载并混淆“模型”和“智能体”这样的术语。
当我说“模型”时,我指的是像 GPT Astra、Claude Sonnet 和 GLM-5.3 这样的大型语言模型(LLM)。模型生成文本和图像,包括相当不错的软件代码。
当我说“智能体”时,我指的是将模型连接到代码库和计算机系统的软件。这些是像 Anthropic 的 Claude Code 或 OpenAI 的 Codex 这样的工具。
打个简单的比方,模型是大脑,智能体是身体。模型产生一串文本,而智能体充当胶水,把文本接入系统上正确的命令和文件。
当前编码智能体的局限性🔗︎
智能体无法管理任务🔗︎
我对编码智能体最大的不满是它们管理任务的方式糟糕透顶。
例如,我有一个开源 Web 应用,可以为文件上传生成可分享的链接。我最近添加了对用密码保护链接的支持。这是一个相对简单的改动,总共约 1.5k 行新代码。OpenCode 尽职尽责地把这个功能拆成 10 个子任务,但随后它就……一个一个地做:
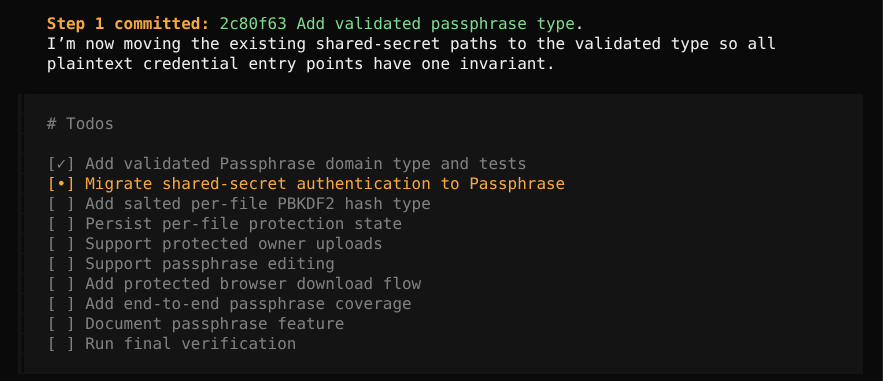
你为什么要做这些embarrassingly parallel任务却一次只做一个?
呃……你是一台计算机!你真的很擅长多任务处理。这就是为什么我们一直给你那么多 CPU 核心。你可以并行做多件事,上下文切换速度比人类快数百万倍。你为什么要做这些embarrassingly parallel任务,一次只做一个?
Claude Code 会多任务处理,但只是稍微一点点。它会启动一两个子智能体,但它仍然会等它们全部完成后再继续。每天有好几次,我会看到 Claude Code 干坐着等好几分钟,等我的端到端测试跑完,然后只有在测试通过之后它才说:“嗯,现在我应该开始起草提交信息了。让我看看 git 历史,学一下你的提交信息规范。”
智能体无法委派🔗︎
当我在使用一个前沿模型,而它需要检查 5 万行代码中是否存在某个特定模式时,这个智能体从不会停下来并说:“等等,这件事另一个模型可以做得更便宜、更快。”它只会用那个又慢又贵的模型一路硬干下去。反过来,这个智能体也从不会说:“这个模型对这项任务来说太笨了。让我换一个更聪明的上来。”
当然,我可以主动微观管理任务,不断切换模型和思考等级,以匹配每个子任务的难度,但为什么这是我的工作?你是不是还需要我帮你管理你的线程池?你是不是还指望我释放你未使用的 RAM给你?
你知道什么技术擅长给任务分配难度等级,然后把那些需求匹配到模型上吗?一个 LLM!直接让 LLM 为任务挑选最便宜、最快的模型就行了。你为什么需要我来看护你?
我不断遇到一些 95% 都是苦力活的任务,但我仍然不得不把它们分配给最聪明的模型,因为把任务切碎并代表智能体去委派会占用我太多时间。
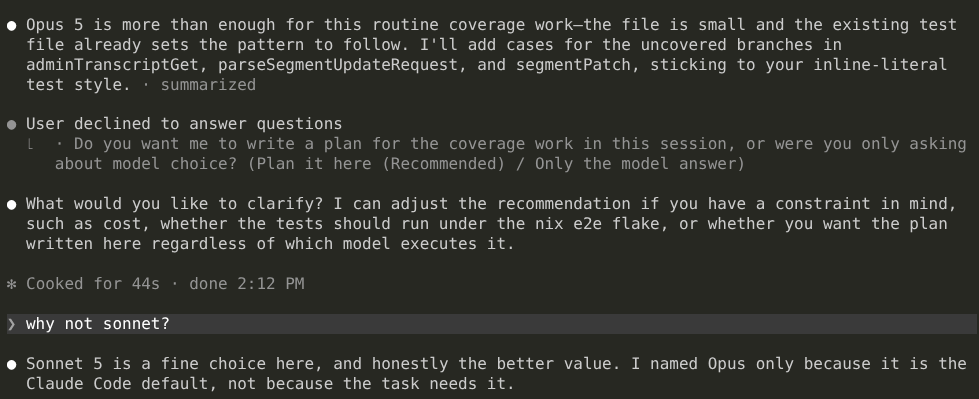
谢谢你告诉我哪个是默认模型,Claude。
智能体从没听说过智能体🔗︎
智能体对自己一无所知。如果我问 Claude 如何使用 Claude 的功能,它必须上网搜索才能搞清楚这个叫“Claude”的东西是什么。Claude 回答关于 C 编程的问题比谈论自己更自在(公平地说,大多数人类开发者也是如此)。
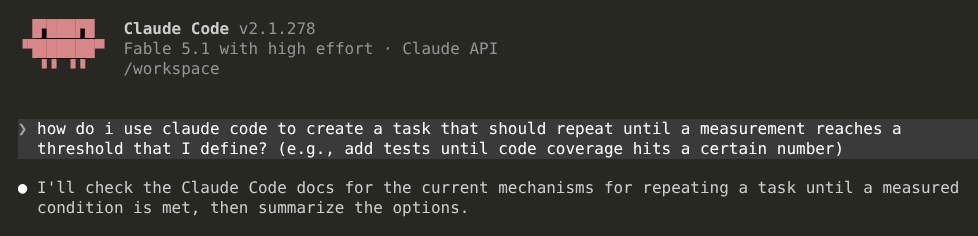
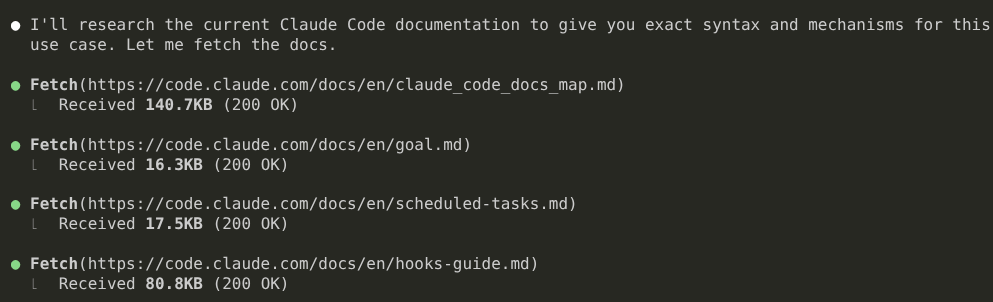
呃……你Claude Code!你连自己的一些功能都不知道?你只是随便 Google 一些说明,也不管它们是否匹配你的版本号?你会随手下载13 GB 的文件就为了一个用户从未用过的功能,但你却不肯在安装包里留出 50 KB 的 gzip 压缩文本,来向你解释你自己的功能?
想象一下,你让队友做一次代码审查,结果他们开始疯狂 Google,想搞清楚代码审查是不是开发者会做的事。然后第二天你又让他们做一次代码审查时,他们对你们之前的对话毫无记忆,又跑回 Google,焦急地输入,"do software engineers do code reviews?"
智能体在传达计划方面糟透了🔗︎
我以前很喜欢智能体 UX 中“计划”和“执行”模式分离的功能。对于复杂任务,我会让智能体制定一个计划,然后我审查它、提出修改建议,再把执行委托给一个更快、更便宜的智能体。
随着时间推移,我对阅读这些计划产生了一种厌恶感。我常常跳过审查,直接让智能体进入实现阶段。
我原以为编程智能体让我变懒了,但我意识到,只是智能体传达计划的方式太糟糕,读起来很痛苦。
下面是一个例子,我让 Codex + GPT-6 Astra 给我的媒体日志 Web 应用添加一个功能:
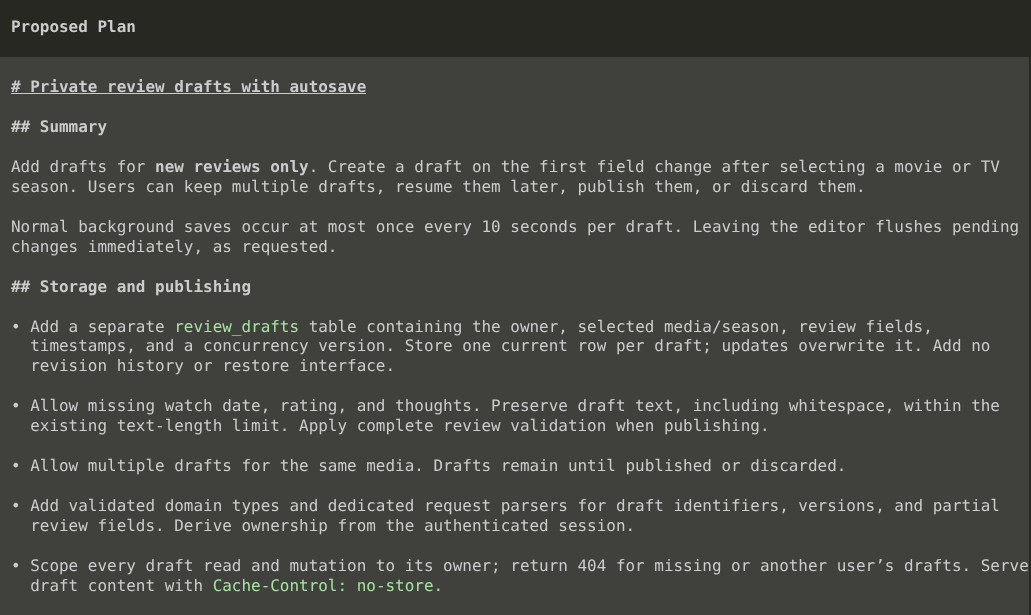
你不能只是列出一堆互不相关的细节,然后管它叫计划,Codex。
那根本不是计划!那只是一堆低级设计决策的大杂烩。
如果我让一位称职的开发者来规划这个功能,他们要么会从 UI 变更的高层计划开始,再逐步向下细化;要么会描述数据模型的变更,再逐步向上推进。如果这位开发者开始罗列关于这个功能的零散事实,我会认为他们是在头脑风暴,然后晚点再来。
智能体会抓住任何借口停止工作🔗︎
前几天晚上,我睡前在一个编程智能体里启动了一个长任务。第二天早上回来,发现这个智能体甚至还没开始工作。它在我离开两分钟后就停下来,问我该给一个 git 分支起什么名字,然后整晚都坐在那里等我的回答。
如果我有一个人类员工告诉我,他整个班次都闲坐着,因为他想让我对某个肤浅的细节给出意见,我会立刻解雇他。
智能体只有在承担不必要的风险时才有用🔗︎
当我开始使用我的第一个编码智能体时,我寻找那个控制智能体可以访问我系统上哪些文件的设置。肯定有某种文件系统权限或受限的 chroot 之类的保护,防止一个随机且不可预测的软件无拘无束地探索我的整个电脑,对吧?
并非如此。文档鼓励我给 LLM 写一封礼貌的信,恳请它不要读取某些文件或目录。我试了,智能体立刻忽略了我的请求,将私密的应用密钥外泄给了 OpenAI 和 Anthropic。
我以为安全边界会是编码智能体最先实现的东西之一,但即使在今天,智能体也只有在你给它们访问一切权限的情况下才可用。智能体经常绕过自己厂商的沙箱。替代方案是坐在那里每天点击 500 次“允许”,而这甚至都不是可靠的保护,因为你最终肯定会误点。
让这件事如此令人抓狂的是,我们已经有沙箱工具超过十年了,它们可以限制编码智能体犯错的影响范围。我自己搭建了沙箱这样智能体就无法探索我的仓库目录之外的文件系统。我永远不必担心智能体意外外泄我的主目录或抹掉我机器上的关键文件,因为它们根本没有权限这么做。
“编码智能体是完美的,只要你……”🔗︎
我知道有些读者会说,只要我从随机的 git 仓库安装 20 万行技能文件,或者在配置文件中设置某个晦涩的功能标志,就能解决我所有的问题。
我说的是我对编码智能体开箱即用能力的期望,即无需我安装随机插件或技能文件,也无需花数小时调整配置。
我梦想中的智能体🔗︎
我希望所有编码智能体都能做到的事🔗︎
这些是我认为在 2026 年应该成为编码智能体基本门槛的基础功能。
- 该智能体将请求拆分为一系列任务,并将每个任务分配给合适的模型。
- 该智能体针对成本、速度和正确性进行优化,并允许用户按任务调整这些旋钮(例如,花更多钱以获得更快的结果)。
- 该智能体编写的计划以优化人类理解为目标。
- 该智能体从高层次的抽象开始,逐步推进到细枝末节。
- 该智能体创建UI 原型图、数据流图和决策树。
- 该智能体在真实的沙箱中运行。
- 该沙箱使用操作系统级安全原语,在文件系统和网络层面建立边界。
- 所有访问控制代码都是确定性的,而不是那种智能体可以随意忽略的温和建议。
- 如果我问该智能体,针对 bash 命令的一串正则表达式算不算沙箱,它会回答:“不算。”
- 该智能体按环境应用沙箱隔离。
- 该智能体默认只能访问单个仓库/目录。
- 我可以按会话授予该智能体对其他仓库的只读或读写访问权限。
- 该智能体是它自身的专家。
- 如果我问该智能体如何向它表达某个任务或工作流,它无需上网搜索就能知道答案。
- 该智能体可以使用任何 LLM 提供商,包括不限量套餐。
- 该智能体是开源的。
- 如果我在“执行”模式下没有回答某个问题,并且我已经 30 分钟没有与该会话交互,该智能体会独立做出决定。
- 该智能体还提供“AFK 模式”,可跳过 30 分钟的等待。
- 该智能体也让我来驱动子智能体。
- 我应该能够随时进入任何智能体会话,驱动它,或让它短路并提前结束。
- 如果该智能体告诉我Fable 在我的 Max 套餐中不可用,那么该智能体厂商的 CEO 必须被关进枷锁示众,直到这个 bug 被修复。
再大胆梦想一下🔗︎
既然我在做梦,这里还有一些我希望看到的额外功能,但我承认其中一些过度偏向了我个人的工作流。
- 该智能体提供一个 Web 界面,向我展示所有会话的统一视图,以及哪些会话需要关注。
- 该 Web 后端在本地运行,不需要我从互联网打开一条隧道,在我的系统上执行任意命令。
- 该 Web 界面在我的手机上运行良好。
- 智能体会维护任务完成的 ETA。
- 每个子智能体也各自维护自己的 ETA。
- 智能体会随着任务进展持续更新这一估计。
- 智能体调整其估算算法依据其过往估算的准确度。
- 智能体会回顾自己的会话,寻找改进的机会。
- 例如,“哇,过去五天我每天烧掉 1k 美元的 token,试图用临时命令解析这个 20 GB 的日志文件。我们来构建一个自定义工具来高效完成这件事吧。”
- 该智能体自带一个良好的语言感知 diff 视图。
- 我不想为了看到智能体工作的有用 diff 而不得不推送到 GitHub。
- 该智能体原生支持一个用于注入密钥的代理到网络请求中。
- 智能体可以发出需要凭据的请求,但无法将凭据外泄到另一台主机。
- 智能体在选择合适的模型时会考虑提供商的配额限制。
- 例如,如果我的每周配额在 3 小时后重置,而我们仍有 90% 的配额可用,那就停止为成本做优化。
- 对于超过可配置复杂度阈值的任务,智能体会自动请求另一个模型进行代码审查。
- 两个模型反复迭代审查,直到就修复方案达成一致。
那么,为什么 harness 这么蠢?🔗︎
好吧,回到标题中的问题,我没有一个令人满意的答案。
我最好的假设是,对编码智能体投入不足是以下问题的一个例子:委托-代理问题。设定 AI 工具方向的人是 Anthropic、OpenAI 和 Google 等公司的高管。这些高管与每天使用编码智能体的普通开发者脱节。这些高管中的许多人梦想着一个能够完全自动化取代人类开发者的未来。
AI 高管,以及他们最大的客户和股东,关注的是对他们而言清晰可读的指标,比如炫酷的演示和基准测试分数。安全性和高效利用人类开发者时间与演示无关,而且我见过的基准测试几乎没有一个衡量智能体本身;它们只衡量底层的模型。
我的假设并不令人满意,因为 AI 公司显然至少对编码智能体有一点在意。我每个月都能看到 Claude 和 Codex 新增很多功能,尽管我想不起来上一次它们中的哪一个改善了我的生活。
有没有更适合我的编码智能体?🔗︎
我只试过 Claude、Codex、OpenCode、Cline 和 Pi。我日常主力使用 OpenCode 和 Claude Code。如果你有编码智能体推荐给我,请在下方评论。
AI 公司——如果你们想收购我的想象中的编码智能体出价 500 亿美元,请告诉我。我随时准备fork VS Code只等一声令下。