技能是赋予智能体领域知识的最佳方式之一。一个技能技能是一个包含指令、脚本和参考文件的文件夹,用于教会智能体如何做事,比如像你的销售团队那样准备客户会议或审阅通话记录。Agent Skills 是一个开放标准可与任何模型配合使用,并受到数十种智能体产品的支持。你也不需要具备技术背景就能编写一个:其核心就是一个 markdown 文件。
技能之所以有效,是因为渐进式披露。智能体一开始只能看到每个技能的名称和描述,只有在任务需要时才读取完整指令。这样可以保持上下文精简,而上下文工程是构建高效智能体的关键。
随着使用规模扩大,团队对技能的需求也在变化。我们看到企业技能注册表增长到数千个技能,在团队和智能体之间共享。我们改进了Deep Agents 中的技能支持,以解决一些常见需求:
- 将工具绑定到技能:绑定到某个技能的工具只有在智能体读取该技能时才会加载。
- 固定技能:当用户明确请求某个技能时,比如
/meeting-prep,你的应用可以在下一次模型调用之前加载它。 - 技能重新加载:长时间运行的线程可以获取新增或变更的技能,而无需重新开始。
技能如何工作
一个技能是一个目录,其中包含一个SKILL.md文件:带有name和description的 YAML frontmatter,后面是智能体遵循的指令。一个技能还可以在scripts/、references/和assets/下捆绑支持文件(规范)。

在本文中,我们将使用我们的 GTM 智能体作为贯穿始终的示例。它构建于Deep Agents之上,其包含 50 多个技能的库覆盖了销售代表的日常工作,比如meeting-prep、call-transcripts和competitive-intel-card。
- 发现。启动时,智能体在其系统提示中看到每个技能的
name和description。 - 激活。当任务匹配某个技能时,智能体使用
SKILL.md读取完整的read_file。 - 执行。智能体遵循指令,仅在指令要求时读取脚本或参考文件。

在技能被使用之前,它只占用系统提示中的一行,因此一个库可以持有大量技能的引用而不会挤占上下文。现在让我们深入了解我们在 Deep Agents 中做的增强。
将工具绑定到技能
技能通常会告诉智能体如何使用特定工具,而有些工具只有在智能体读过这些指令后才能正常工作。到目前为止,技能和工具是分开披露的。你可以通过以下方式让工具 schema 不进入上下文:工具搜索,但没有任何机制把工具与解释它的技能关联起来:智能体可能在不阅读其技能的情况下找到并调用某个工具,或者读了技能后仍不得不去搜索它的工具。
现在你可以将工具绑定到技能,这样技能和它的工具会一起披露。绑定的工具在智能体读取其技能之前不会被加入上下文,在此之前调用它会因未知工具而失败。这保持了上下文的精简,也意味着智能体在能够调用某个工具之前已经读过如何使用它。在我们的GTM 智能体中,call-transcripts解释了如何搜索通话和读取转录文本,因此这是绑定这些工具的自然位置。
在技能 frontmatter 的以下字段中列出工具metadata.include_tools:

将这些工具传给SkillsMiddleware而不是智能体:


在对话中途添加工具过去意味着要编辑请求的工具列表,这会使 prompt 缓存失效。Anthropic和OpenAI现在让较新的模型能够在对话中途接受工具,因此在这些模型上,Deep Agents 会在技能被读取后立即添加该技能绑定的工具,已缓存的 prefix 保持不变(Anthropic和OpenAI集成文档)。在其他模型上,工具会像以前一样追加到请求中。
一个列表就能覆盖大多数技能。为了获得更多控制,技能可以列出一个标签而不是工具名称,而你传给SkillsMiddleware的函数会把每个标签转换为工具。这让你能够:
- 披露整个工具组,比如某个 MCP 服务器上的所有工具,用一个名称即可,而无需在技能中逐一列出每个工具。
- 根据运行时权限来门控工具。该函数接收图的运行时,因此它可以检查用户是谁,并只返回他们被允许使用的工具。
这里,call-transcripts获取调用 MCP 服务器上的所有工具,而pipeline-forecast获取 CRM 工具,但只有经理才能更新预测:


参见向技能添加工具了解更多。
固定技能
有时用户已经知道自己想要哪个技能。在我们的 GTM 智能体中,销售代表可以输入/meeting-prep for my Acme call tomorrow。如果不固定,模型只能看到技能的描述,并且必须读取它。这会在工作开始前增加一次往返,而且模型不保证会加载正确的技能。使用固定技能时,你的应用会在消息中找到技能名称(或从 UI 中解析),并将它们传入pinned_skills,然后中间件会在下一次模型调用前将每个技能的指令添加到对话中。Deep Agents 不会自己解析消息,所以语法由你选择:

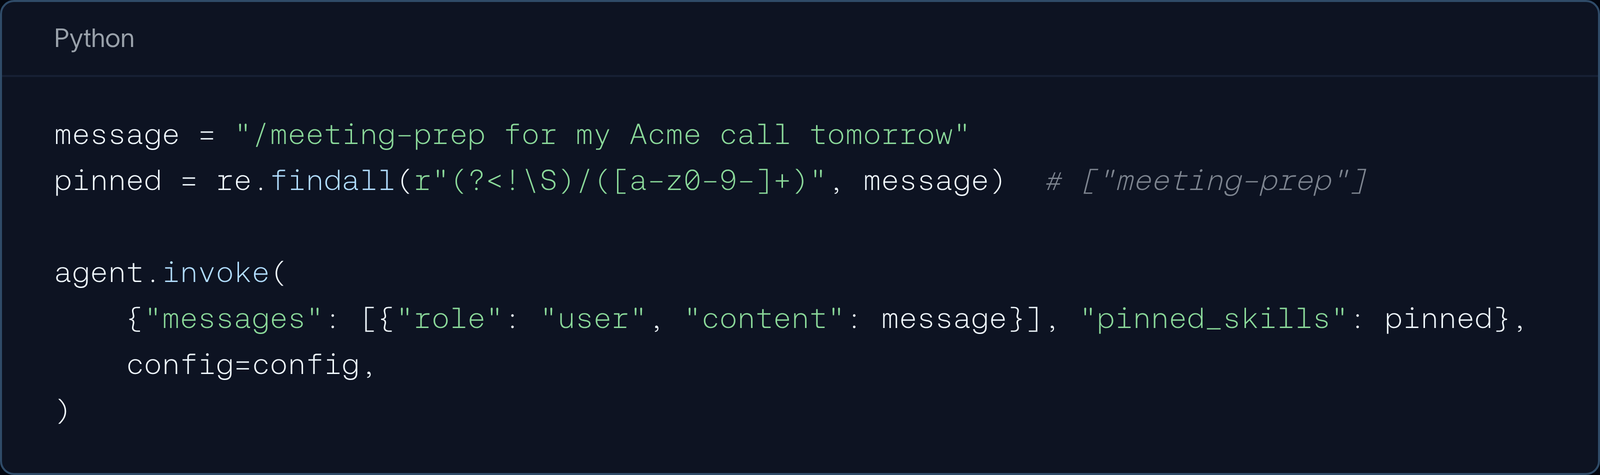
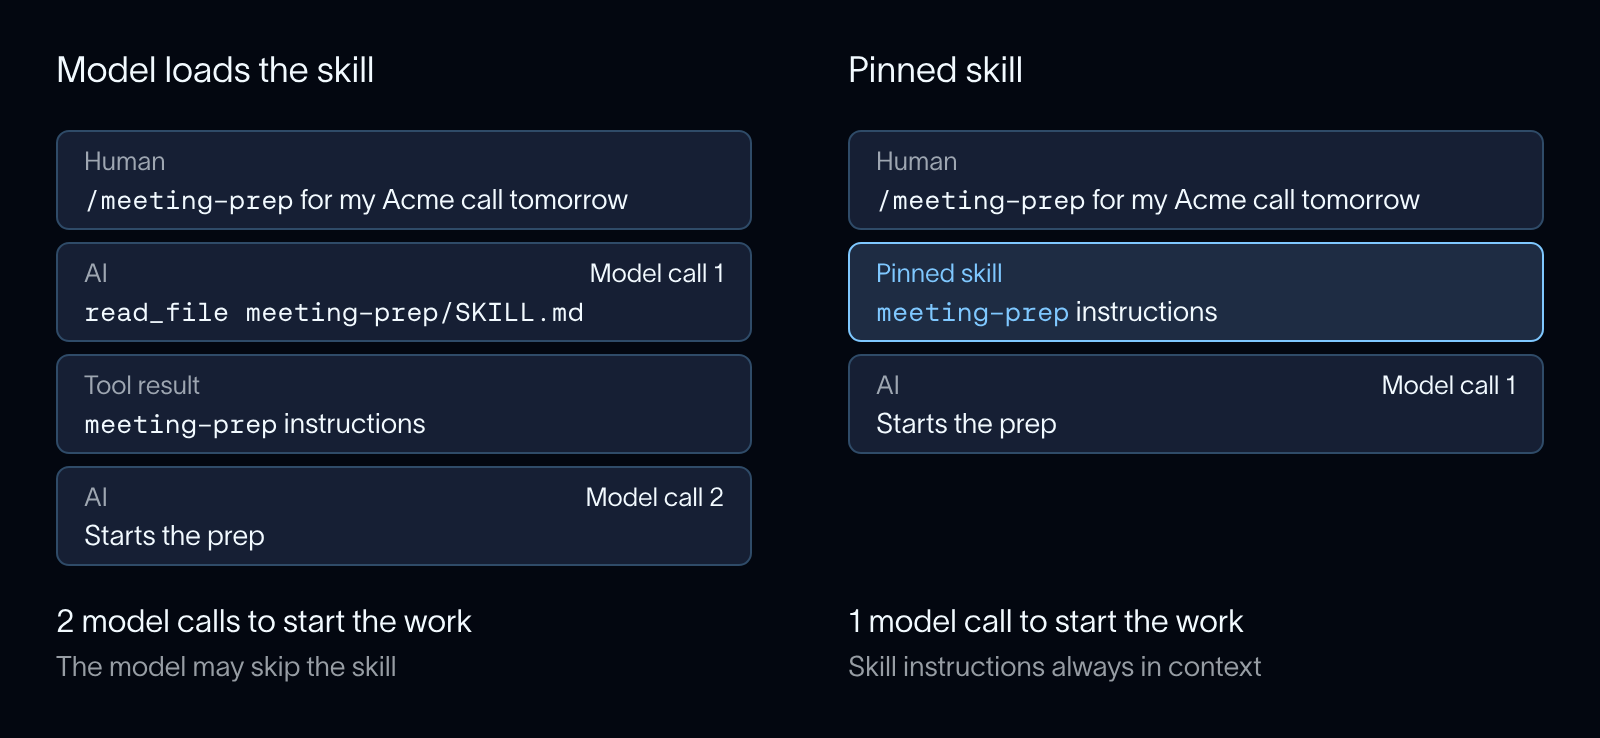
这降低了延迟,并使行为更可预测:指令保证在上下文中,而且固定技能所绑定的工具也随之而来。每个固定技能都会作为一条带标签的消息添加一次,因此较早的消息永远不会改变,提示缓存保持有效,聊天 UI 可以将该技能显示为标签,而不是其全文。
在线程中途重新加载技能
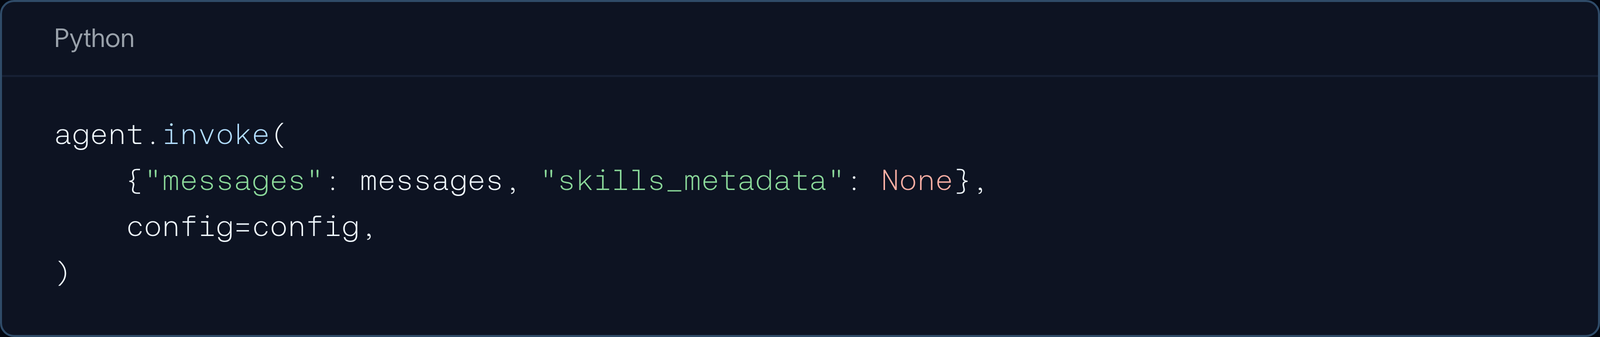
技能会在每个线程开始时加载,并保存在智能体状态中,因此之后的每一轮都会复用同一组技能。你现在可以使此列表失效通过设置skills_metadata为None在调用智能体时。如果队友向库中添加了一个competitive-intel-card技能,应用可以选择使技能列表失效,下一次运行将重新扫描每个来源:
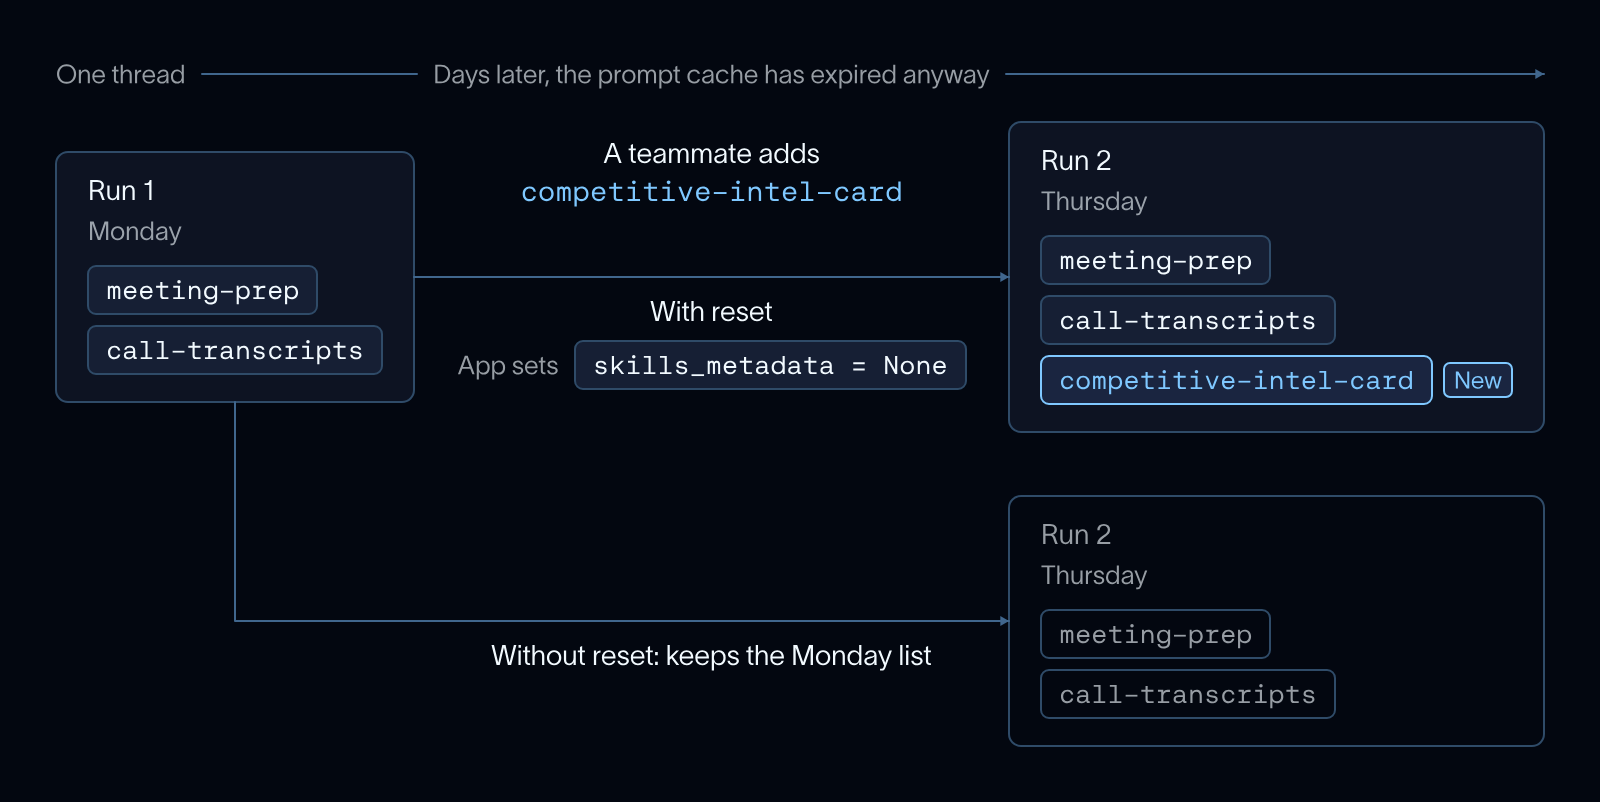
重新加载时发现新技能会改变系统提示,从而使提示缓存失效。对于已闲置一段时间的线程,这个成本通常已经支付过了:提供商的缓存通常会在不活动几分钟到一小时后过期(Anthropic、OpenAI),所以当销售代表回来时,缓存已经是冷的。
因为重置只是运行输入,你也可以把控制权交给用户。例如,一个/reload客户端命令:

你也可以从update_state或从中间件重置,这样你的应用就能控制技能重新加载的时机。参见重新加载技能。
开始使用
技能是为智能体提供有组织的领域知识的行业标准机制。这些更新让技能更容易大规模运行:工具只在技能需要时才加载,工作流所需的技能会预先加载,而长时间运行的线程会随着你的技能库变化保持最新。而且由于技能是开放标准,你的团队编写的技能可跨模型和智能体使用。
所有这些都可在最新的deepagents中使用。阅读技能文档开始使用,并通过GitHub issues、论坛或X告诉我们你的想法。
致谢
感谢Rich Scarrott主导这些新功能的开发,以及Hunter Lovell进行功能与博客审阅!