假设你正在构建一个智能体,用来回答客户上传的 CSV 相关问题。模型需要运行 Python 才能得到答案。那段代码在哪里运行?
一种选择是你自己运行。这意味着要使用一个沙箱平台,比如E2B或Modal,或者你在 Docker 上自己的容器,再加上让它远离你的数据库和互联网、限制其运行时长以及修补镜像这些工作。
服务端代码执行工具是另一种选择。你把该工具加入你的 API 请求,模型自行决定何时需要运行某些东西,提供商在自己的沙箱中运行命令,并在同一个请求内将输出返回给模型。这里的沙箱指的是一个隔离的 Linux 容器,拥有自己的文件系统、时间限制,且默认无网络访问。
本文介绍目前提供 服务端代码执行 的四家提供商,每个沙箱能做什么、不能做什么,它在延迟和费用上的成本,以及哪些任务仍然需要你自己运营的沙箱。
Tl;dr
- 服务端代码执行工具会在你的 API 请求期间,在提供商的沙箱中运行模型的命令。你无需配置、修补或保护容器。
- OpenAI、Anthropic 和 Google 各自为自己的模型运行代码。我们的openrouter:shell工具为 Responses 和 Messages API 上的任何模型运行命令,而我们的openrouter:bash工具仅在 Messages API 上做同样的事。这两个工具都处于 beta 阶段。
- 我们的沙箱是一个隔离的容器,作用域限定在你的账户和工作区,默认关闭出站网络访问,并对每条命令的运行时长和输出大小设有上限。沙箱时间按每秒 $0.0001 计费,新建或休眠的容器有 30 秒的最低计费。
- 你自己运营的沙箱平台对于自定义基础镜像、GPU 工作或运行数小时的会话来说仍然是正确的选择。
服务端代码执行意味着什么
模型本身从不执行任何东西。当它调用工具时,它会发出一个请求,指明工具名称和参数,然后需要有某个东西来执行它。对于客户端工具,那个东西就是你的应用代码或你构建所基于的智能体框架。你的应用接收调用、执行它,并在后续请求中把结果发回。对于服务端工具,提供商在自己的基础设施上执行调用,并在同一个请求中把结果返回给模型,因此你的应用没有对应的处理程序。服务端代码执行属于第二种。
你可能已经在使用以这种方式工作的工具。网页搜索让模型在实时网络上查找某些内容,而网页抓取让它读取某个 URL 的内容。在这两种情况下,你只需在请求中添加一个条目,剩下的由提供商完成。代码执行把同样的模式应用于运行命令。
一次工具调用如何变成一条被执行的命令
这些步骤适用于任何服务端代码执行工具。凡是出现字段名的地方,都是我们的 shell 工具所使用的字段名。
- 你把该工具包含在请求的
tools数组中。 - 模型判断它需要运行某些东西,并发出一个携带一条或多条 shell 命令的调用。
- 提供商在沙箱容器中按顺序运行这些命令。
- 每条命令的标准输出、标准错误和结果都会返回给模型。结果要么是退出码,要么是超时。
- 模型读取结果,然后要么回答你,要么在同一个请求中运行更多命令。
第二到第五步会重复进行,直到模型给出回答。模型运行某些东西、读取输出、判断是否需要另一条命令,然后再次执行。这个循环正是代码执行工具的价值所在,因为模型可以对照真实输出来检查自己的工作,而不是靠猜测。
我们给这个循环设了上限。max_tool_calls字段设定了一个请求最多可以执行多少个服务端工具步骤。我们的服务端工具参考把默认值和最大值都设为 30。
托管沙箱与你自行运行的沙箱有何不同
运行你自己的沙箱意味着要承担本应由提供商承担的那些部分。你要选择基础镜像、配置算力、接入 SDK 来启动运行并读取输出,还要管理每次运行的生命周期。你也要承担安全边界。
托管工具用 JSON 数组中的一个条目来换取对那项控制权。你不需要调整容器大小、打补丁或运维它。我们构建了 openrouter:shell,用于每个请求只需执行少量短命令的场景。
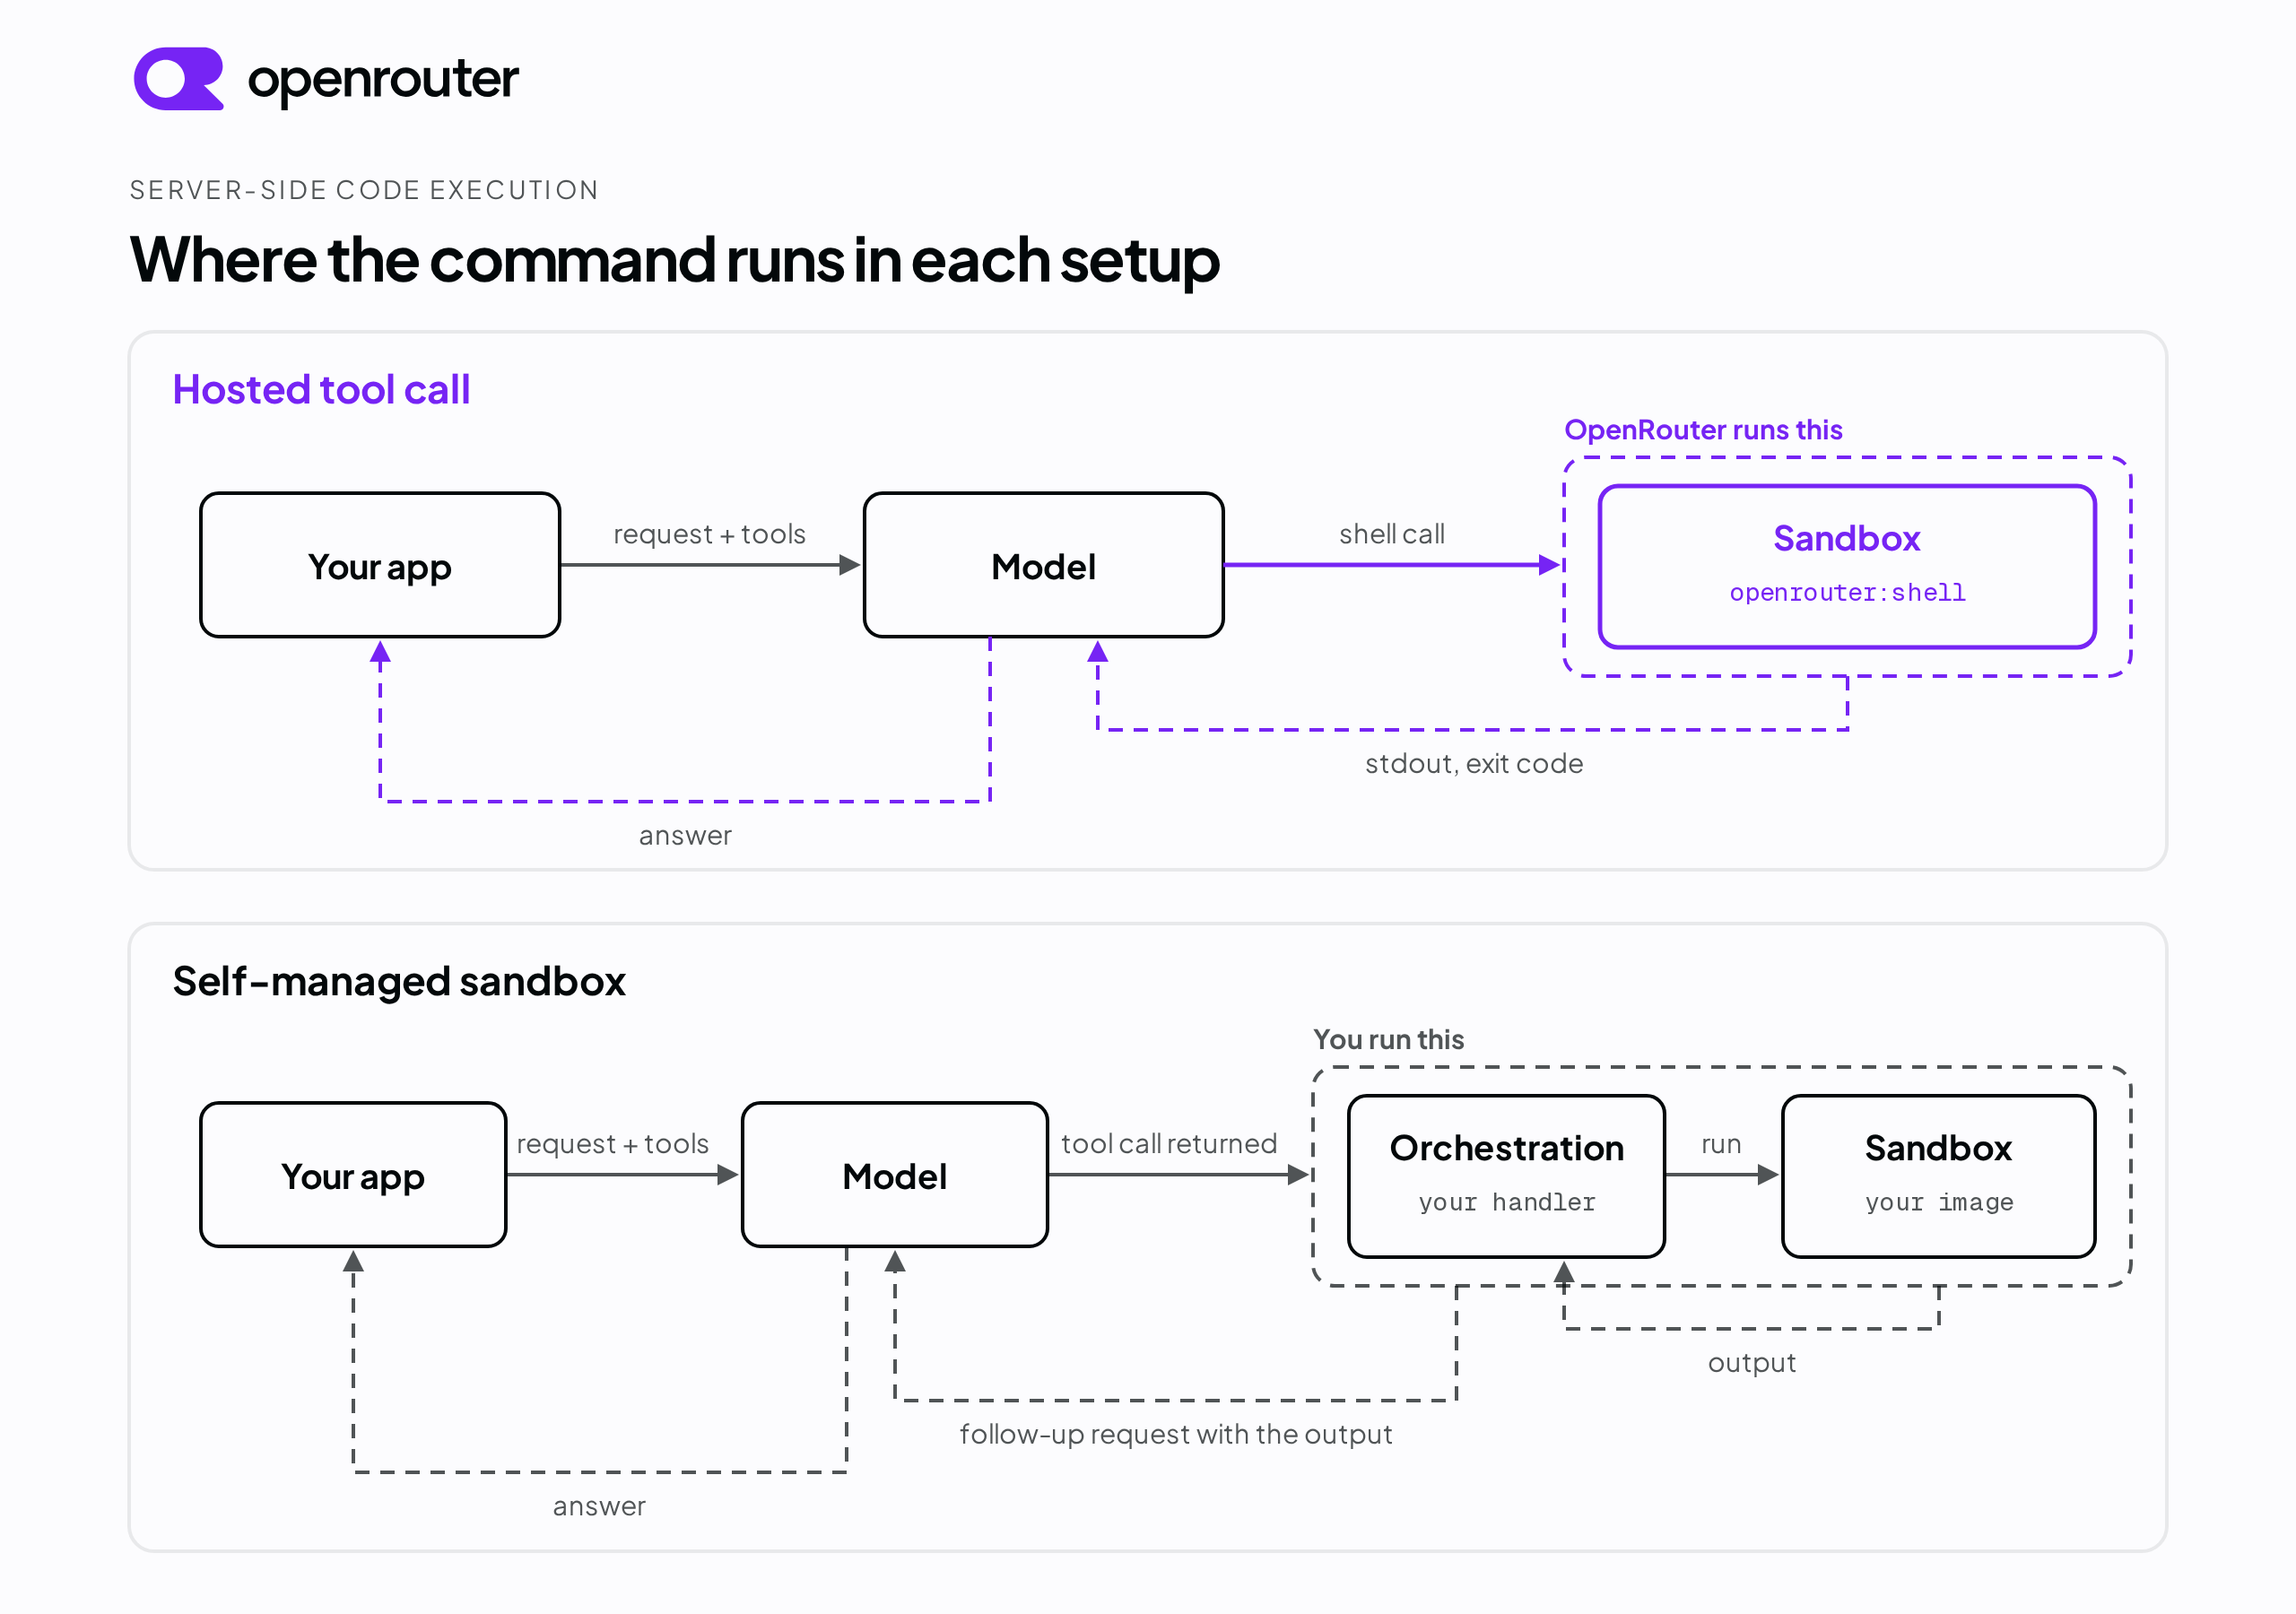
如今谁提供托管代码执行
本文涵盖 OpenAI、Anthropic、Google 和 OpenRouter。智能体 SDK 和专用沙箱平台属于不同的类别,两者都会在文章后面出现。这四家提供商的区别在于各自为哪些模型运行代码。
OpenAI 为 OpenAI 模型运行托管 shell
OpenAI 的shell 工具在 OpenAI 管理的容器中运行命令,位于 Responses API 上。OpenAI 在文档中将托管运行时描述为 Debian 12,默认工作目录为/mnt/data。命令运行时没有sudo,且不支持交互式 TTY 会话。文档中列出的预装语言包括 Python 3.11、Node.js 22.16、Java 17、PHP 8.2、Ruby 3.1 和 Go 1.23。
托管容器默认没有出站网络访问权限。要启用它,组织管理员需在 OpenAI 仪表盘中配置允许列表,并在请求中的容器环境上设置network_policy。通过在container_reference环境中传入容器 id,容器可以跨请求复用,其过期时间在容器创建时设定。OpenAI 还有一个单独的代码解释器工具用于 Python。
Anthropic 为 Claude 模型运行 Python 和 Bash
Anthropic 的代码执行工具在 Anthropic 管理的沙箱中运行 Python 和 Bash,位于 Messages API 上。文档中描述的环境是 Linux x86_64 容器,配备 Python 3.11、5 GiB 内存、5 GiB 工作区存储和一个 CPU。互联网访问被禁用,不允许任何出站连接,因此 Claude 只能使用预装的库,无法在运行期间安装软件包。
三个工具版本存在,且每个受支持的模型都接受全部三个版本。code_execution_20250825支持 Bash 命令和文件操作。code_execution_20260120增加了在请求之间保持的 Python 解释器状态,这依赖于 Anthropic 的编程式工具调用,且在 Claude Haiku 4.5 上不可用。容器在创建 30 天后过期。在约 5 分钟无活动后,容器会被检查点保存,在 30 天窗口内使用其 id 发起请求即可恢复它。
Google 为 Gemini 模型运行 Python
Google 的代码执行工具在 Google 管理的沙箱中运行 Python,通过请求的 tools 中的一个code_execution条目启用。文档指出,模型只能生成和执行 Python,代码环境的最长运行时间为 30 秒,且你无法安装自己的库。Google 发布了该环境包含的库列表。
我们为任何模型运行托管 shell
上述三个工具各自只适用于一家公司的模型。我们的工具适用于 Responses 和 Messages API 上的任何模型,因为我们在路由层运行沙箱,而不是在某一家模型提供商内部。
我们提供两个代码执行工具。openrouter:shell与 OpenAI 托管 shell 工具的形式一致,可同时用于Responses API和 Messages API。openrouter:bash与 Anthropic 的 bash 工具形式一致,仅适用于 Messages API。
这两个工具均处于 beta 阶段,因此 API 可能会变化。沙箱执行仅在全局openrouter.ai端点运行。区域内端点不提供 shell 工具,而 Chat Completions 会以 400 拒绝这两个工具,并在错误中列出支持它们的 API。
将engine设置为openrouter任一工具上的该值,命令就会在我们的沙箱中运行。默认engine为auto。对于 openrouter:shell,auto在存在提供商原生托管 shell 时保留它,否则路由到我们的沙箱。对于 openrouter:bash,auto将工具调用返回给你的应用程序以在客户端运行,我们的服务器上不会执行任何内容。
在我们的沙箱中运行一条命令
以下是一个完整请求,它运行两条命令并读回结果。
importos
importrequests

response=requests.post(
"https://openrouter.ai/api/v1/responses",
headers={"Authorization":f"Bearer{os.environ['OPENROUTER_API_KEY']}"},
json={
"model":"anthropic/claude-sonnet-4.5",
"input":"运行 `cat /etc/os-release` 和 `python3 --version`,然后用一句话告诉我操作系统和 Python 版本。",
"tools":[
{"type":"openrouter:shell","parameters":{"engine":"openrouter"}}
],
},
)

foriteminresponse.json()["output"]:
ifitem["type"]=="openrouter:shell":
print(item["container_id"],item["action"]["commands"])
forresultinitem["output"]:
print(result["stdout"],result["outcome"])
我们在 2026 年 9 月 22 日运行了这个请求。模型在一次 shell 调用中发送了两条命令,每条命令都返回了自己的结果。完整的os-release输出有好几行,这里只截取了前两行。
{
"type":"openrouter:shell",
"container_id":"sess_art10-418b8597e044",
"action": {"commands": ["cat /etc/os-release","python3 --version"] },
"output": [
{
"stdout":"PRETTY_NAME=\"Ubuntu 22.04.5 LTS\"\nNAME=\"Ubuntu\"\n",
"stderr":"",
"outcome": {"type":"exit","exit_code":0}
},
{
"stdout":"Python 3.11.14",
"stderr":"",
"outcome": {"type":"exit","exit_code":0}
}
]
}
沙箱在那天报告的是 Ubuntu 22.04.5 LTS 和 Python 3.11.14。运行时镜像可能会变化,所以要从容器中读取版本,而不是硬编码。服务器工具参考涵盖了其余参数。
为你封装沙箱的智能体 SDK
如果你是基于智能体 SDK 构建,而不是直接调用 API,有些 SDK 会封装这些工具之一。
TheOpenAI Agents SDK提供了CodeInterpreterTool,它在 OpenAI 的沙箱中运行代码,以及ShellTool,它根据你如何配置其环境,在你的本地运行时或 OpenAI 托管的容器中运行。在假设某条命令是远程运行之前,先确认你配置的是哪种模式。在我们这边,openrouter:shell 是tools数组中的一个条目,和其他条目一样,所以它进入OpenRouter Agent SDK循环的方式,与进入原始请求的方式相同。
什么仍然需要你自己的沙箱
托管工具适合简短、有界的工作,例如运行脚本、转换文件或检查结果。任何需要特定基础镜像或 GPU 的任务都超出了全部四个托管工具的范围,需要一个你自己运营的沙箱平台。
对比
每个托管工具单元格都来自上方链接的供应商自己的文档,除了 OpenRouter 运行时单元格,它来自我们运行上述请求时沙箱所报告的内容。自管理列描述的是你自己运行的沙箱,而不是任何特定平台。
| OpenRouter | OpenAI | Anthropic | 自管理 | ||
|---|---|---|---|---|---|
| 谁运行它 | 我们 | OpenAI | Anthropic | 你 | |
| 模型 | Responses 和 Messages API 上的任何模型 | OpenAI 模型 | Claude 模型 | Gemini 模型 | 任何模型 |
| API | Responses 和 Messages。openrouter:bash 仅限 Messages | Responses | Messages | Gemini API | 任何 |
| 语言 | 任意 shell 命令。Ubuntu 22.04.5,Python 3.11.14,报告于 2026 年 9 月 22 日 | Debian 12 上的 shell 命令。预装 Python、Node.js、Java、PHP、Ruby 和 Go | Python 和 Bash | 仅 Python | 你构建的任何东西 |
| 文件系统 | 自有容器文件系统,范围限定在你的账户和工作区。home 目录下的文件在每条命令后都会保存 | 自有容器文件系统,默认工作目录为/mnt/data。容器过期时数据会被删除 | 隔离容器,5 GiB 工作区存储。容器在创建 30 天后过期 | 未记录 | 由你的镜像和挂载决定 |
| 出站网络 | 默认关闭。允许列表最多 50 个主机名,端口 80 和 443 | 默认关闭。组织允许列表加上每次请求的network_policy | 已禁用 | 未记录 | 由你自行配置 |
| 在运行时安装包 | 可以,包主机需在允许列表中 | 可以,包主机需在允许列表中 | 否 | 否 | 是 |
| 会话持久性 | 容器以容器 id 为键。空闲 5 分钟后休眠。保存的文件在最后一次使用后保留 30 天 | 容器通过以下方式按 id 复用container_reference。过期时间设置在容器上 | 容器在创建后 30 天内按 id 恢复。解释器状态在以下情况下持续保留code_execution_20260120及更高版本,支持程序化工具调用 | 每次执行最长运行时间 30 秒。请求之间的状态持久性未记录 | 取决于各平台的上限 |
| 成本模型 | 推理 token 加上沙箱时间,每秒 $0.0001,新建或休眠容器有 30 秒最低计费 | shell 工具文档中未说明 | 每个组织每月 1,550 免费小时,之后每个容器每小时 $0.05,每次执行最低 5 分钟 | 无额外费用。生成的代码和输出按 token 计费 | 沙箱运行期间的计算时间 |
我们的沙箱强制执行的内容
沙箱的意义就在于你不必信任模型。你从未打算执行的命令无法访问网络或他人的容器,并且会在运行时长和输出量的硬性限制处停止。本节所有内容描述的都是我们的沙箱。上表展示了另外三者有何不同。
适用于每条命令的限制
我们在一个隔离的容器中运行每条命令,该容器独立于为你的请求提供服务的基础设施以及你的机器,并且限定在你的账户和工作区范围内。你可以通过以下设置自行设定上限:timeout_ms命令可以运行多长时间,以及max_output_length命令可以打印多少内容。timeout_ms默认值为 120,000 ms,且不能超过 300,000 ms。max_output_length每个流默认值为 16,384 个字符,且不能超过 65,536。包含超过 100 条命令的 shell 调用会被拒绝。
除非你开启,否则出站网络访问处于关闭状态。我们在 2026 年 9 月 22 日验证了这一点:发送一个不带network_policy的请求,并要求模型用https://example.com获取curl,只打印 HTTP 状态码,并在 5 秒后放弃。该命令打印了000,这正是curl在没有收到响应时打印的内容,并以代码 28 退出,即curl超时。
{"stdout":"000","stderr":"curl: (28) Failed to connect to example.com port 443 after 5206 ms: Connection timed out","outcome":{"type":"exit","exit_code":28} }要打开网络,请设置一个network_policy最多包含 50 个主机名或 glob 模式的允许列表。只有端口 80 和 443 可访问,并且该策略在容器启动时即固定。pip install需要同时将pypi.org和files.pythonhosted.org加入允许列表。
提示注入以及沙箱限制的内容
给模型一个 shell 会让你暴露于提示注入。如果你的智能体读取网页、支持工单或他人上传的文件,攻击者可以在该文本中隐藏指令,告诉模型忽略你的提示并运行其他内容。
无论模型是在遵循你的提示还是攻击者的提示,上述限制都适用。在注入指令下运行的命令无法访问你配置的network_policy之外的任何主机,并且当你关闭该策略时完全没有网络访问。它无法访问另一个租户的容器,并且会在相同的超时处停止。允许列表会扩大注入命令可以访问的范围,而allowed_domains: ["*"]允许不受限制的出站流量,因此请将允许列表限制为作业所需的主机。
你还可以检测到达请求本身的尝试。提示注入检测位于工作区护栏中在将请求转发给模型之前,会针对常见注入技术的正则表达式模式检查每个传入请求中用户提供的消息内容。它不会检查此后服务器工具获取的内容,因此模型通过工具读取的页面、文件或命令输出需要你自己进行控制,例如审查你的应用程序收到的沙箱输出。匹配后会执行三种操作之一,具体取决于你配置的操作。
- Flag 记录检测结果并原样转发请求。
- Redact 将匹配到的片段替换为
[PROMPT_INJECTION]并转发经过清理的请求。 - Block 在请求到达模型之前以 403 拒绝该请求。
当适用多个护栏时,最严格的操作胜出,顺序为 block、redact、flag。检测并不详尽,可能会产生误报,因此在强制执行 redact 或 block 之前,先在 flag 模式下针对你自己的流量测量匹配率。你可以从 Logs 页面报告误报。
托管沙箱在秒数和美元上会花费你多少
托管沙箱会给请求增加数秒时间,并且让你无需运行任何基础设施。它还为你提供一个可以返回的容器。
文件在请求之间得以保留
命令在/workspace/home中运行,我们在每条命令后将更改的文件保存在该目录下。发送一个稳定的session_id,或在工具的环境配置中设置容器 id,带有该 id 的每个请求都会到达同一个容器和同一批文件。session_id只能使用字母、数字、_和-。包含任何其他字符的 id 会被忽略,我们会像你没有发送session_id一样选择容器,这意味着如果有的话,选择重放对话中最近的container_id,否则为该请求新建一个容器。当session_id超过 20 个字符时,我们只使用最后 20 个,因此两个结尾相同的长 id 会共享一个容器。container_referenceid 可以是来自同一字符集的 1 到 40 个字符,并且不会被截断,因此当你需要 id 精确时使用它。我们在 2026 年 9 月 22 日确认了这一点:在一个请求中写入文件,并在共享同一session_id的第二个请求中将其读回。
容器在空闲 5 分钟后进入休眠,且空闲时间不可配置。休眠不会删除文件。当稍后收到具有相同 id 的请求时,会启动一个新的沙箱并首先加载已保存的文件。打开的进程、环境变量和已安装的系统状态不会被恢复,因此请将唤醒的容器视为一台带有你文件的全新机器。已保存的文件在容器最后一次使用后会保留 30 天。要提取产物,GET /api/v1/containers/{container_id}/files列出容器产生了什么,以及promote 端点将文件复制到你的工作区文档中,在那里它不会过期。
之后你可以审查什么
响应中的每个 shell 工具结果都带有模型运行的命令以及每个命令的 stdout、stderr 和结果,因此你的应用可以像记录响应其余部分一样记录它们。输入与输出日志记录将你的提示词和补全内容存储在 OpenRouter 上,以便在 Logs 页面查看,护栏检测结果也会出现在那里。对于生产监控,Broadcast在请求完成时将追踪流式传输到外部可观测性平台。
如果你将请求路由到区域内,则 shell 工具不可用,并且即使启用了输入与输出日志记录也会被跳过。Broadcast 支持区域内路由,每个目标都配置了它接收追踪的数据区域。
往返的成本是多少
运行沙箱命令的请求比不运行该命令的同一请求耗时更长。在我们于 2026 年 9 月 22 日发送的一组单个请求中,没有 shell 工具的请求大约 2 秒返回,而进行了一次 shell 调用的请求根据模型不同在 8 到 21 秒内返回。这些是来自一个会话的单个样本,不是基准测试。每次 shell 调用请预留几秒的开销。
沙箱时间按每秒 $0.0001 计费。计时从请求首次运行沙箱命令时开始,到响应完成时停止。启动新容器或休眠容器的请求最低计费 30 秒,而之后复用同一热容器的请求只需支付其计量时间。上面的请求启动了一个新容器,其 usage 对象报告了一个server_tool_cost为 0.003,即 30 秒的最低计费。请求之间处于空闲状态的容器不计费。
无需改动工具代码即可更换模型
更换模型,你的工具定义保持不变。
我们在 2026 年 9 月 22 日将同一个请求体发送了六次,只更改了model字段,并要求每个模型运行python3 -c "print(sum(range(1, 101)))"在沙箱中。每个模型都进行了一次 shell 调用并返回了 5050。
| 模型 | 结果 |
|---|---|
| openai/gpt-5.4-mini | 5050 |
| google/gemini-3.5-flash | 5050 |
| anthropic/claude-haiku-4.5 | 5050 |
| deepseek/deepseek-v3.2 | 5050 |
| moonshotai/kimi-k2.6 | 5050 |
| qwen/qwen3-coder | 5050 |
这六个模型都在同一个沙箱中运行,使用相同的工具定义,无论它们各自的提供商原生提供什么,因为沙箱属于我们,而不属于模型提供商的。在你基于某个模型构建之前,先测试你计划使用的模型,因为工具调用的可靠性因模型而异。我们的工具调用指南介绍了服务器工具和你自己的函数工具如何共享同一个tools数组。
当你想要一个属于自己的沙箱平台时
当你需要托管工具无法提供的东西时,选择专用的沙箱平台。Modal记录了基于自定义镜像构建的沙箱,其生命周期可配置,最长可达 24 小时,并提供 GPU 资源。Daytona记录了基于公共容器镜像创建的沙箱,包括 GPU 沙箱。E2B记录了其 Pro 计划上最长运行 24 小时、基础计划上运行 1 小时的沙箱,并支持暂停和恢复以应对更长的工作负载。
结论
对于模型请求内部的简短、有界命令,使用托管工具。你只需向tools数组添加一个条目,就能获得一个出站网络访问关闭的隔离容器,你需为推理以及沙箱运行的秒数付费。为每次 shell 调用预留几秒的开销,并尽可能复用容器。
当任务需要自定义基础镜像、GPU、运行数小时的会话,或对安全边界本身的所有权时,迁移到你自行运营的沙箱平台。无论哪种情况,在做出承诺之前都要查看提供商当前的文档,因为我们的两个工具处于 beta 阶段,其他三个提供商的工具也在变化。
常见问题
是否存在一种托管沙箱 shell 工具,模型可以在请求期间直接调用?
是的。我们的 openrouter:shell 服务器工具为模型提供一个沙箱化的 Linux shell,在请求期间运行在我们的基础设施上,同时支持 Responses API 和 Messages API。设置engine为openrouter,命令就会在隔离容器中运行,每条命令的 stdout、stderr 以及退出或超时结果都会返回给模型。OpenAI、Anthropic 和 Google 各自为其自家模型提供托管的代码执行工具。
我能给模型一个可以运行命令的沙箱化 shell 吗?
可以。添加{"type": "openrouter:shell", "parameters": {"engine": "openrouter"}}到toolsResponses 或 Messages API 请求的数组中。模型随后可以发出 shell 调用,我们在隔离容器中运行这些命令,并将每条命令的输出返回给模型。除非你配置了network_policy允许列表,否则该容器没有出站网络访问权限。
哪些 SDK 或平台开箱即用地提供服务器端代码执行?
我们的 openrouter:shell 服务器工具可在 Responses 和 Messages API 上为任何模型运行命令,而我们的 openrouter:bash 服务器工具仅在 Messages API 上提供相同功能。OpenAI、Anthropic 和 Google 各自通过 Responses API shell 工具、code execution 工具和 Gemini API code execution 工具为其自家模型运行代码。OpenAI Agents SDK 将 OpenAI 的托管工具封装为CodeInterpreterTool和ShellTool。E2B、Modal 和 Daytona 是你自行集成和运营的沙箱平台,而不是提供商在 API 调用内部运行的工具。
哪个沙箱最适合 AI 智能体?
这取决于工作运行多长时间,以及你需要对运行时有多少控制权。对于请求内部的短命令,像 openrouter:shell 这样的托管工具意味着你无需运行任何基础设施。对于自定义基础镜像、GPU 访问或运行数小时的会话,你自行运营的沙箱平台(如 Modal 或 Daytona)能提供这些控制能力。
如何对 AI 智能体进行沙箱隔离?
你在一个与自身系统隔离的环境中运行智能体的命令,并限制该环境可以访问的范围。使用托管工具时,由提供商完成这一工作。在 OpenRouter 上,容器与我们的基础设施以及你的机器隔离,作用域限定在你的账户和工作区,出站网络访问默认关闭,每条命令受timeout_ms限制,输出上限由max_output_length. Workspace 护栏在模型前面增加了提示注入检测。
什么是沙箱化 AI 工具?
它是一种副作用被限制在隔离环境中、而不会影响你的生产系统的工具。对于代码执行,模型的命令会在一个拥有独立文件系统、受限网络访问和时限的容器中运行,只有命令输出会传回模型。我们的 shell 和 bash 服务器工具就是这样工作的。