一个工作流中需要不止一个模型。一个成本较低的模型处理常规调用,一个更强的模型处理困难的任务。LangChain 和 CrewAI 等智能体框架是构建这一能力的一种方式。两者都提供编排层,但组织方式不同。LangChain 的运行时 LangGraph 提供显式的状态和控制流。CrewAI 将工作组织为基于角色的智能体和事件驱动的流程。
当你构建一个会规划、保持状态、调用工具或委派工作的智能体时,这两个框架都有帮助。如果你只需要为每个步骤选择一个模型,并在某个模型失败时回退,那么完整的编排框架会加入你用不到的部分。
本文按各自承担的任务,比较 LangChain 与 LangGraph、CrewAI,以及 OpenRouter 原生路由。它展示了同一个两步流水线分别直接针对 OpenRouter 编写和通过 LangChain 编写,描述了我们的 Agent SDK 如何处于两者之间,并展示了当你同时需要编排和路由时,如何把 OpenRouter 放到任一框架之下。
Tl;dr
- 多模型编排分为三层。工作流编排是规划、状态、记忆和委派。模型路由是为一次调用选择模型,并在返回错误时回退。提供商路由是选择由哪个提供商端点来服务你选定的模型。
- LangGraph 和 CrewAI 负责工作流编排。OpenRouter 负责模型路由和提供商路由。两者互不替代。
- OpenRouter 的
models参数是一个有序的回退列表。当第一个模型返回错误时,我们尝试下一个。回退由错误驱动,不评判回答质量。 - 我们的 Agent SDK 覆盖中间情况,即一个有边界的多轮工具循环,带验证、流式传输和停止条件,而不需要持久化图或基于角色的团队。
- LangChain 有一个专门的
ChatOpenRouter集成,CrewAI 通过其LLM类将 OpenRouter 记录为提供商。你可以保留任一框架的编排,并在底层使用 OpenRouter 作为模型层。
被叫成同一个名字的三层
“多模型编排”这个说法涵盖三个不同的决策。把它们分开,框架比较就会更简短。
工作流编排是规划、状态、记忆和委派。你把任务拆成步骤,在多轮对话和多次运行之间保持状态,暂停等待人工审核,并把子任务交给其他智能体。LangGraph 和 CrewAI 就是为这一层构建的。
模型路由是选择由哪个模型处理给定的调用,以及当该模型返回错误时会发生什么。OpenRouter 的models参数通过一个请求字段来处理这件事。
提供商路由是选择由哪个提供商端点来服务你已经选定的模型。OpenRouter 上的许多模型由不止一个提供商提供服务。我们会为每个请求在符合条件的提供商中进行选择,而在包含工具的请求上,Auto Exacto会根据工具调用性能对这些提供商重新排序。提供商路由绝不会改变你所请求的模型。
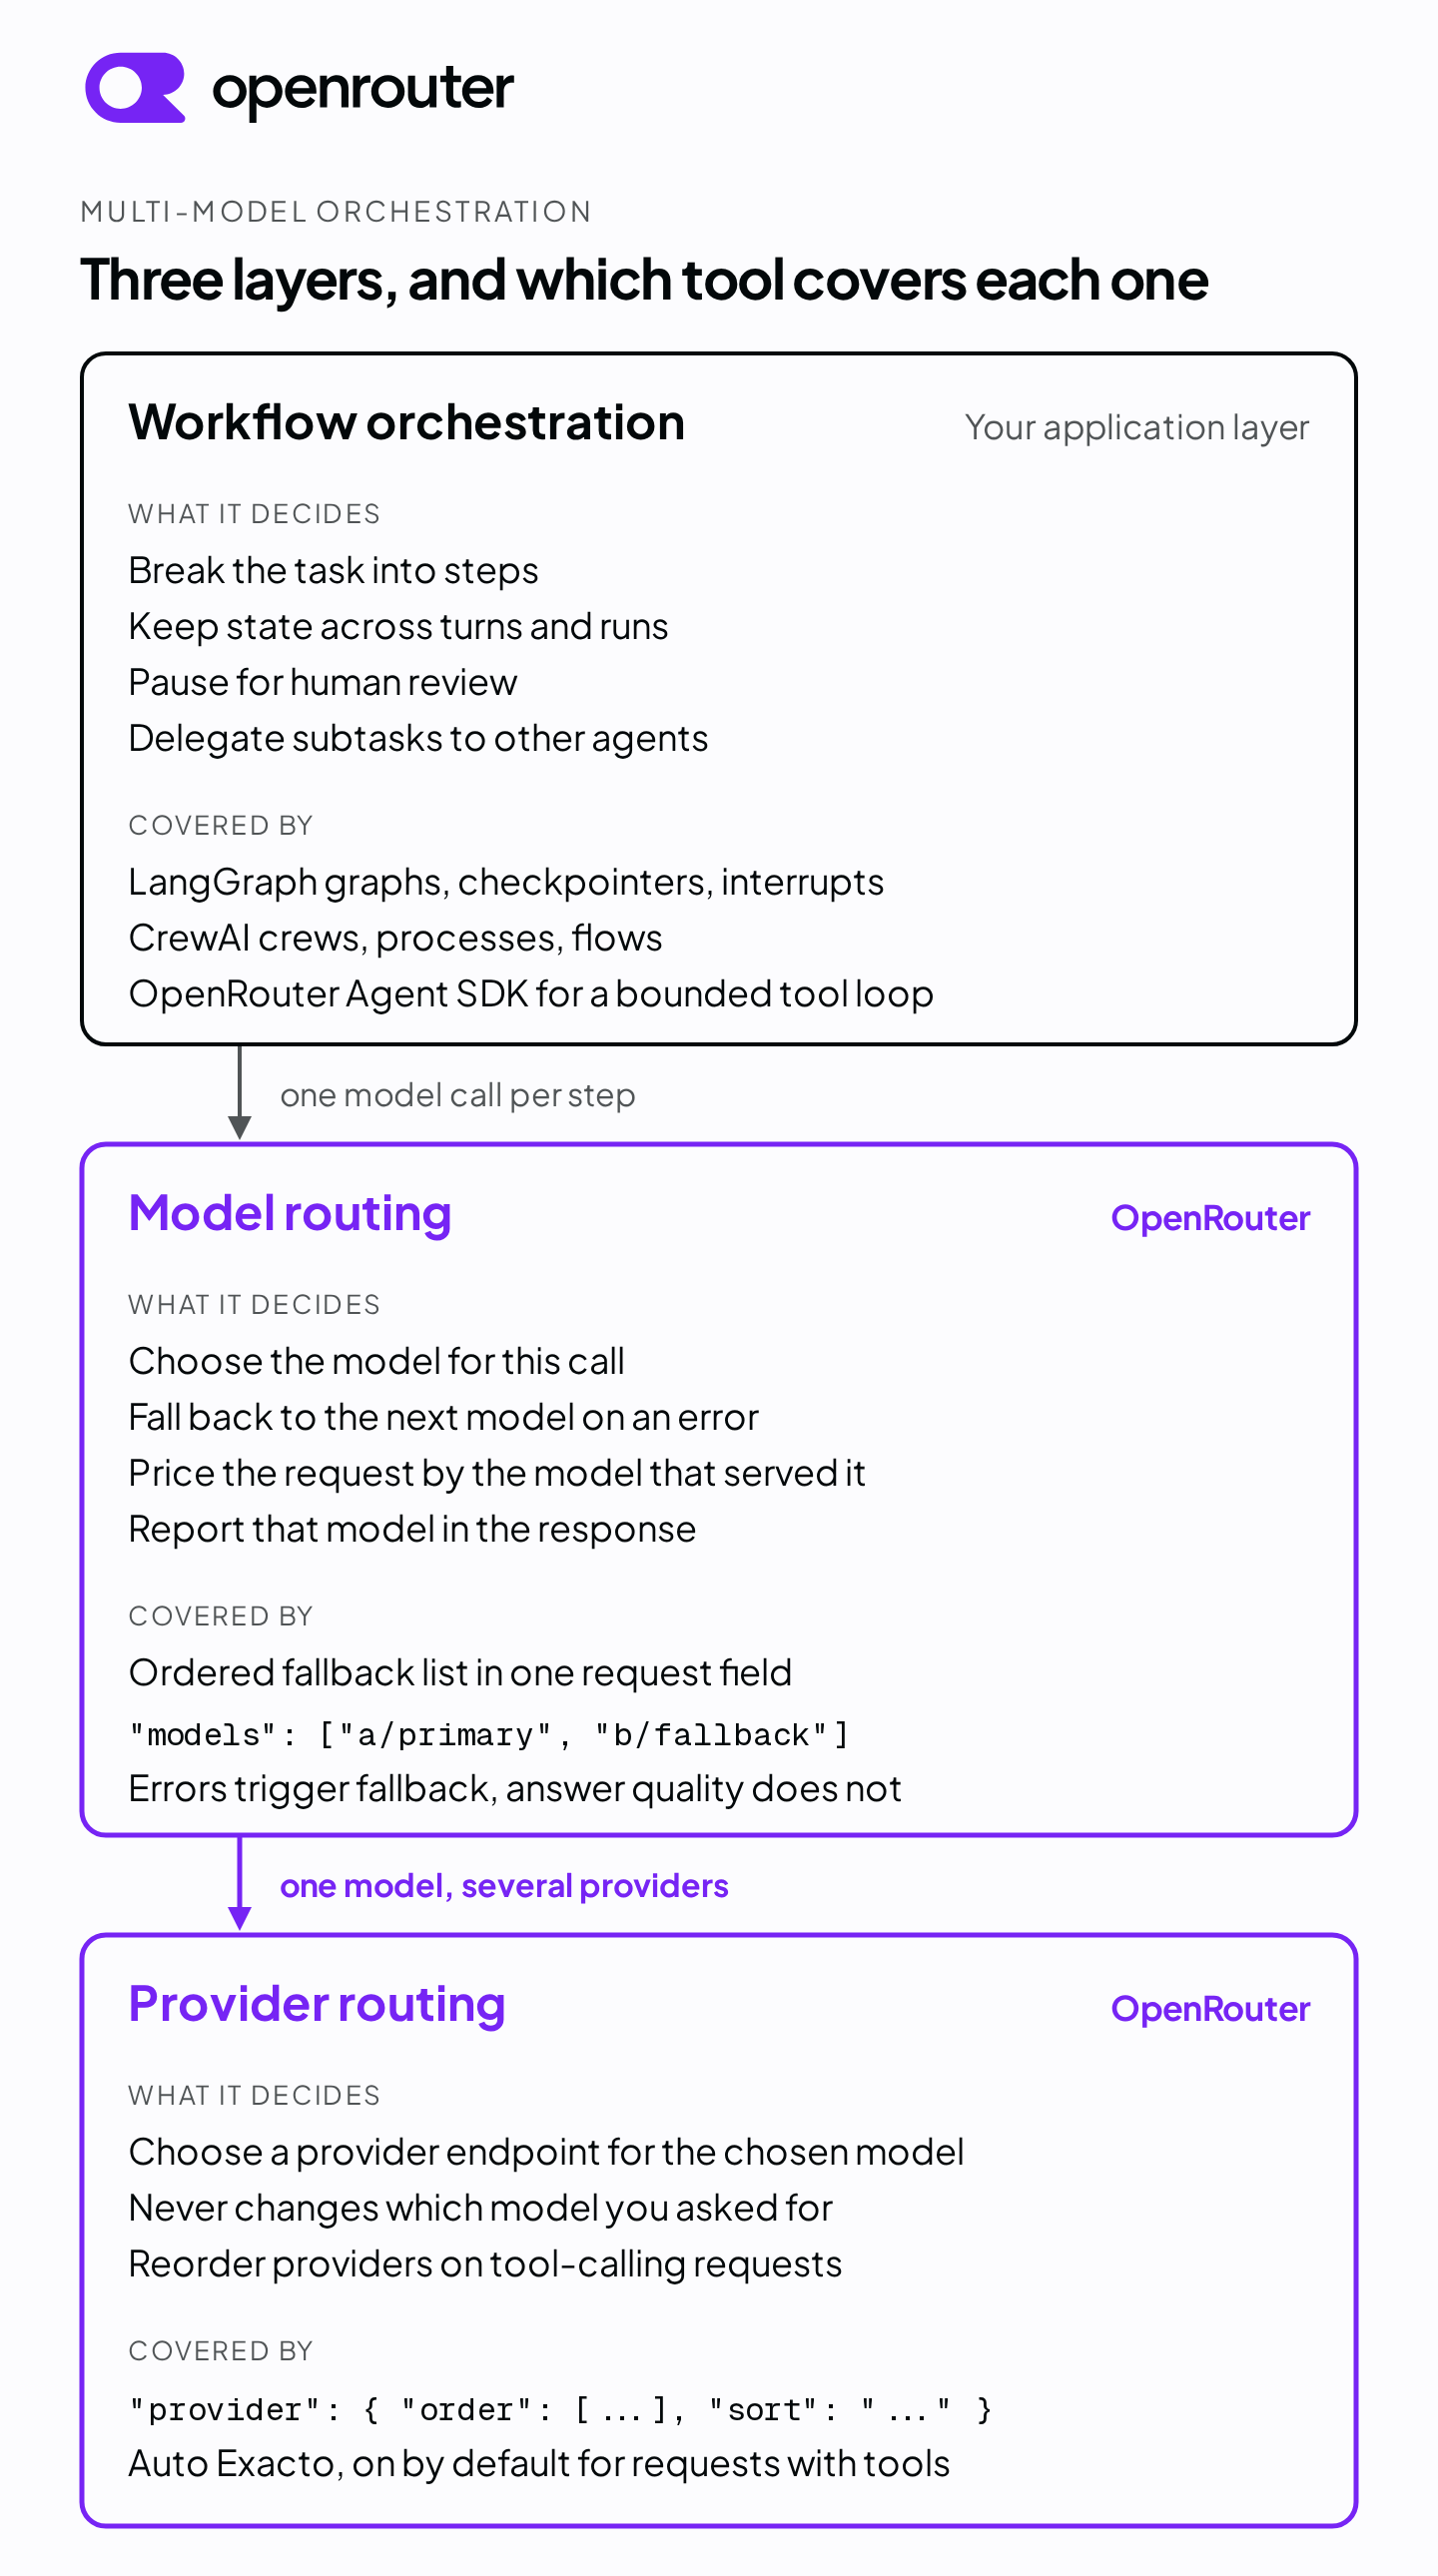
一个工作流可能三层都需要。规划逻辑决定下一步做什么,模型路由决定由哪个模型来做,提供商路由决定由哪个端点来服务那个模型。你不需要第一层就能获得后两层。一个models列表和几条if语句就能在模型之间路由,无需智能体框架。
LangChain 和 LangGraph
LangChain 当前的文档描述了两个角色不同的产品。LangChain 是智能体框架,为模型、工具和智能体循环提供抽象和集成。LangGraph 是它底层的低级编排运行时,专注于持久执行、流式传输、人在回路和持久化。你可以在不使用 LangChain 的情况下使用 LangGraph,而 LangChain 的预构建智能体运行在 LangGraph 之上。
LangGraph 将工作流建模为节点组成的图。你可以在同一个图中混合确定性的手写步骤和模型驱动的步骤。持久化来自两个组件。检查点保存器为某个线程保存图状态,从而带来对话连续性、容错、时间旅行以及人工审核的基础。存储则在图状态之外持久化应用数据,用于长期的跨线程记忆。interrupt()函数可以在节点中的任意位置暂停运行,通过检查点保存器保存状态,并等待你用Command来恢复它,这样人就可以在运行继续之前批准、编辑或拒绝某个步骤。
这种控制的代价是你需要自己描述控制流。每个节点、边、状态字段、检查点和中断都是你编写和维护的代码。如果你需要一个多步骤流水线,其中每个节点都可检查、可恢复,LangGraph 为你提供了这种结构。如果你只需要一次带 fallback 的模型调用,那就超出了任务所需。
CrewAI
CrewAI 的文档描述了两个构建块。Crews 是智能体团队,每个智能体都定义了一个角色、一个目标和一个背景故事,它们通过分配的任务协同工作。一个 crew 以顺序流程运行任务,其中每个任务的输出成为下一个任务的上下文,或者以层级流程运行,其中由 manager 模型或 manager 智能体分配和协调任务。智能体之间可以相互委派,当allow_delegation被启用时,每个智能体都有一个max_iter限制,默认为 20,以及一个可选的max_execution_time。
Flows 是围绕 crews 的结构化、事件驱动层。一个 flow 定义了步骤、在步骤之间传递的状态以及控制流,包括条件逻辑、循环和分支。每个 flow 实例都携带一个状态对象,该对象具有在运行期间持续存在的唯一 ID。CrewAI 的简介将 flows 定位为应用程序的骨干,将 crews 定位为 flow 内部的工作单元。
CrewAI 的模型更接近任务描述而非图定义。你把更多精力花在角色、目标和任务字符串上,而花在连接节点上的精力更少。这是与 LangGraph 不同的权衡,而不是它的缩小版。Crews 给智能体留出了决定如何完成任务的空间,而 flows 则是你收回控制权的地方。
对比
| LangChain 和 LangGraph | CrewAI | OpenRouter 直连 | |
|---|---|---|---|
| 专为 | 基于图的编排,具有显式状态、持久化和人工审核 | 事件驱动 flow 内基于角色的智能体团队 | 每次调用选择模型、错误驱动的 fallback 以及提供商路由 |
| 多模型支持 | 是,每个节点或智能体一个模型对象 | 是,一个LLM每个智能体、crew 或 manager | 是,一个models每个请求的列表 |
| 规划、记忆和委派 | 是,在图、检查点和存储中显式体现 | 是,通过智能体、流程和 flow 状态 | 否,仅路由 |
| 流式传输 | 是 | 是,在 crew 级别使用stream=True | 是,按请求 |
| 人工审核 | interrupt()配合检查点 | 你编写的流程逻辑 | 未提供 |
| 你编写的内容 | 节点、边、状态模式、持久化配置 | 智能体、任务、团队和流程定义 | 一个请求体 |
OpenRouter 原生路由
这里的“原生”意味着不使用框架。你向https://openrouter.ai/api/v1/chat/completions发送请求,在models参数中按优先级顺序列出你的模型,剩下的交给我们处理。如果第一个模型返回错误,我们会尝试列表中的下一个模型。默认情况下任何错误都可以触发回退,包括上下文长度验证错误、被过滤模型的审核标记、速率限制和宕机。如果回退模型也返回错误,我们就返回该错误。我们按最终提供服务的模型来计费,响应中的model字段会告诉你那是哪一个。
回退是对错误做出反应。它不会评估第一个模型的回答是否好。如果你想让更强的模型审查较弱模型的输出,那是你代码中的第二步,而不是models列表替你做的事。
以一个两步流水线为例,用一个模型起草,然后用另一个模型审查草稿,每一步在第一个模型返回错误时回退。直接针对 OpenRouter 编写,那就是一个函数和两个models列表。
importos

importrequests


defroute(models: list[str], prompt:str) -> tuple[str,str]:
response=requests.post(
"https://openrouter.ai/api/v1/chat/completions",
headers={"Authorization":f"Bearer{os.environ['OPENROUTER_API_KEY']}"},
json={"models": models,"messages": [{"role":"user","content": prompt}]},
timeout=120,
)
response.raise_for_status()
body=response.json()
returnbody["choices"][0]["message"]["content"], body["model"]


draft, draft_model=route(
["anthropic/claude-sonnet-5","openai/gpt-5.6-sol"],
"Draft a one-paragraph summary of what a model fallback list does.",
)
review, review_model=route(
["openai/gpt-5.6-sol","anthropic/claude-sonnet-5"],
f"Review this draft for accuracy and suggest one improvement:\n\n{draft}",
)
print(f"draft by{draft_model}, review by{review_model}")
print(review)
要把某个步骤发送到不同的模型,只需更改列表。由于我们的 API 与 OpenAI 兼容,相同的 chat completions 请求结构适用于目录中的每个聊天模型,而更换模型只需更改一个字符串。服务于其他端点的模型(例如 embeddings、视频、文本转语音或语音转文本)使用各自的请求结构。
通过 LangChain 实现的同一流水线使用专用的ChatOpenRouter模型类。你为每个步骤创建一个模型对象,用 LangChain 的with_fallbacks包装每一个,这样失败的调用会在下一个模型对象上重试,并通过以下方式调用结果invoke。
fromlangchain_openrouterimportChatOpenRouter

drafter=ChatOpenRouter(model="anthropic/claude-sonnet-5").with_fallbacks(
[ChatOpenRouter(model="openai/gpt-5.6-sol")]
)
reviewer=ChatOpenRouter(model="openai/gpt-5.6-sol").with_fallbacks(
[ChatOpenRouter(model="anthropic/claude-sonnet-5")]
)

draft=drafter.invoke("Draft a one-paragraph summary of what a model fallback list does.")
review=reviewer.invoke(
f"Review this draft for accuracy and suggest one improvement:\n\n{draft.content}"
)
print(review.content)
两个版本都将相同的两个步骤路由到相同的两个模型,并使用相同的回退顺序。区别在于回退运行的位置。在直接版本中,我们在服务器端于单个请求内运行它。在 LangChain 版本中,框架在你的进程中捕获失败的调用,并发送第二个请求。对于使用 LangChain 的create_agent构建的智能体,该框架还提供ModelFallbackMiddleware,它在主模型失败时尝试替代模型。框架版本为你提供模型对象和一个共享的invoke接口,一旦有了图、检查点器或一组要管理的工具,这就是你想要的结构。如果没有,它就是额外的开销。
无论哪个版本,通过我们进行路由都会带来三件事。每个响应都包含一个usage对象,其中带有 token 计数和以 credits 计的成本,无需额外参数,因此你可以在决定分层设置是否值得之前,看到每次调用的成本。提示缓存在支持的模型上可降低重复上下文的成本。当请求包含工具时,Auto Exacto默认运行。它会根据吞吐量、工具调用成功率和基准测试数据,为你所选的模型重新排列提供商顺序,因此工具调用会落到具有良好工具调用记录的提供商上,而你这边无需任何配置。Auto Exacto 改变的是提供商顺序,而不是模型。
直接路由不会规划、不会跨轮次保持状态,也不会决定哪个子任务交给哪个智能体。那是工作流编排层的事,而一个models列表并不提供这些。下一步的升级并不总是一个完整的框架。
OpenRouter Agent SDK
在直接路由和完整框架之间,是我们的Agent SDK,即@openrouter/agent包。一次聊天补全是无状态的。你发送消息,得到一条回复。要把它变成智能体,意味着运行一个循环:模型请求工具调用,你的代码验证参数并运行工具,结果返回给模型,循环重复直到工作完成。Agent SDK 把这个循环打包进一个callModel函数。
你用tool()辅助函数和 Zod schema 定义工具,SDK 会处理验证、执行以及跨轮次的对话状态。诸如stepCountIs和maxCost这样的停止条件会限制循环。每个条件都在一步完成后检查,因此maxCost会在达到阈值的那一步之后停止循环,而不是阻止那一步,并且默认情况下 SDK 随后会再进行一次模型轮次以生成最终答案。把maxCost当作停止规则,而不是支出上限。流式传输是内置的,你还可以接入远程 MCP 服务器作为工具来源。
import{ OpenRouter, tool, stepCountIs, maxCost }from"@openrouter/agent";
import{ z }from"zod";

constclient=newOpenRouter({ apiKey: process.env.OPENROUTER_API_KEY});

constresult=client.callModel({
model:"anthropic/claude-sonnet-5",
input:"What time is it in Tokyo?",
tools: [
tool({
name:"get_time",
description:"Get the current time in a timezone",
inputSchema: z.object({ timezone: z.string() }),
execute:async({timezone})=>({
time:newDate().toLocaleString("en-US",{ timeZone: timezone }),
}),
}),
],
stopWhen: [stepCountIs(5),maxCost(0.5)],
});

consttext=awaitresult.getText();
console.log(text);
该 SDK 用 TypeScript 编写,Python 和 Go 版本保持同步。它为你提供一个有边界的工具循环,包含校验、流式传输和停止条件。它不提供持久化图、检查点或基于角色的团队。
对于单个请求内的委派,openrouter:subagent服务器工具允许模型在生成过程中将一个自包含的任务交给工作模型。工作模型可以是 OpenRouter 上的任意模型。每个任务都是独立的。工作模型只能看到任务描述,任务之间不保留任何记忆。服务器工具处于 beta 阶段,API 和行为可能会发生变化。
该 SDK 还涵盖该循环内的人工审批和持久化对话状态。工具可以设置requireApproval以在运行前暂停,而一个StateAccessor在多次callModel调用之间持久化消息、审批和工具结果。它不提供的是带有显式转换和检查点的持久化图,或跨智能体团队的协调。当你需要这些时,那就是升级到 LangGraph 或 CrewAI 的时候。
在 LangChain 或 CrewAI 底层使用 OpenRouter
你不必在框架和网关之间做选择。你保留框架的规划、状态和委派,并在其底层使用 OpenRouter 作为模型层。
对于 LangChain,我们维护一个专用的集成。用于 Python 的langchain-openrouter包和用于 JavaScript 的@langchain/openrouter包为你提供一个ChatOpenRouter模型,你可以将智能体和图指向它。LangChain 的文档目前将 Python 集成标记为 beta。
fromlangchain_openrouterimportChatOpenRouter

model=ChatOpenRouter(
model="anthropic/claude-sonnet-5",
temperature=0,
model_kwargs={"models":["anthropic/claude-sonnet-5","openai/gpt-5.6-sol"]},
)一个ChatOpenRouter对象发送一个model值。要在 LangChain 下使用我们的服务器端回退,请将models列表通过model_kwargs传入,该包会将其展开到请求体中。没有它,回退就是框架的职责,如上面的with_fallbacks示例所示。
对于 CrewAI,你用我们的端点配置其LLM类。CrewAI 的LLM 文档将 OpenRouter 列为使用 LiteLLM 的提供商,因此你安装crewai[litellm]额外项,在模型 slug 前加上openrouter/,并传入我们的基础 URL 和你的密钥。
importos

fromcrewaiimportLLM

llm=LLM(
model="openrouter/anthropic/claude-sonnet-5",
base_url="https://openrouter.ai/api/v1",
api_key=os.environ["OPENROUTER_API_KEY"],
)
CrewAI 示例配置了一个模型。提供商路由适用于每个请求,而更改由哪个模型处理某个步骤就是对 slug 的更改。服务端模型回退仅在请求携带一个models列表时适用,而 CrewAI 的文档并未涵盖如何传递该字段。在这两种情况下,你的图或 crew 都会按设计继续工作,而要切换到另一个模型只需更改配置,而不是新的提供商集成或为每个模型单独使用 API key。
选择一层
如果你的直接实现开始积累状态机、可恢复检查点、审批步骤和委派规则,那你就是在手工构建一个工作流编排层,而框架会替代你原本需要自行设计和维护的代码。这是我们的编辑建议,而非产品保证,并且它从你的应用必须自己承担的行为出发。
- 当工作流已经清晰,你只需要为每次调用选择一个模型、添加一个回退列表或控制提供商路由时,使用 OpenRouter 原生路由。
- 当你需要一个有边界的多轮工具循环,并带有验证、流式传输和停止条件,且不需要持久化图或基于角色的 crew 时,使用 OpenRouter Agent SDK。
- 当你需要显式的状态转换、持久化、恢复、人工审核,或确定性步骤与模型驱动步骤的混合时,使用 LangGraph。
- 当工作映射到专家智能体、任务委派以及顺序或层级协作,并且周边应用需要结构化状态和控制时使用 flows,此时使用 CrewAI。
- 当你希望框架负责编排、OpenRouter 负责模型访问和提供商路由,并在框架转发一个
models列表时使用服务端模型回退,就把 OpenRouter 放在 LangGraph 或 CrewAI 之下。
结论
多模型编排分为三层。工作流编排负责规划、状态、记忆和委派,LangGraph 和 CrewAI 正是为此而生,但各有取舍。LangGraph 让你获得显式的图控制,代价是需要自己编写这些控制逻辑;CrewAI 提供基于角色的智能体和流程,代价是将更多执行路径交给智能体自行决定。模型路由和提供商路由是 OpenRouter 所做的事情,无论上层是否叠加框架,我们都以相同方式处理。
如果你不确定自己的项目属于哪一侧,先尝试更小的投入。用一个两步工作流跨两个模型进行路由,配合一个models列表,然后再决定是否需要在上面叠加框架。当你为任一方案选择模型时,模型目录让你可以按支持的参数进行筛选,包括tools。
常见问题
使用多个模型需要 LangChain 或 CrewAI 吗?
不需要。如果你唯一的需求是为某次调用选择模型,并在第一个模型返回错误时回退到另一个模型,OpenRouter 的models参数可以在一次请求中完成。当工作流还需要规划、持久状态、记忆、人工审核或智能体之间的委派时,才选择 LangGraph 或 CrewAI。
如何在一个智能体工作流中编排多个 LLM?
把各层分开。对于跨步骤的规划、状态和委派,使用编排框架,如 LangGraph 或 CrewAI。对于选择由哪个模型处理每次调用,向 OpenRouter 发送一个有序的models列表,让它在第一个模型返回错误时回退到下一个模型。我们还会为服务该调用的模型选择提供商端点。一个工作流可以同时使用两者,框架在上层,OpenRouter 在底层作为模型层。
我可以将 OpenRouter 与 LangChain 或 CrewAI 一起使用,而不是二选一吗?
可以。LangChain 在 Python 的ChatOpenRouter包和 JavaScript 的langchain-openrouter包中都有专门的@langchain/openrouter集成。CrewAI 通过其使用 LiteLLM 的LLM类将 OpenRouter 记录为提供商。在这两种情况下,框架负责编排,OpenRouter 提供模型访问和提供商路由。我们的服务端模型回退仅在请求携带models列表时运行,该ChatOpenRouter会通过其model_kwargs参数进行转发。
采用 LangChain 或 CrewAI 会把我锁定到某一个模型提供商吗?
如果你把框架指向 OpenRouter,而不是某一家提供商的 SDK,就不会。这两个框架都接受 OpenRouter 作为模型提供商,因此更换由哪个模型处理某个步骤,只需修改框架配置中的模型字符串,而不必重写提供商集成。你仍然可以使用 OpenRouter 上的所有模型。
OpenRouter 的模型回退会判断答案的质量吗?
不会。回退是由错误驱动的。当你列表中的第一个模型models返回错误时,例如上下文长度校验错误、内容审核标记、速率限制或服务中断,我们会尝试列表中的下一个模型。成功的响应会按原样返回,而响应中的model字段会告诉你它是哪个模型生成的。
参考资料
- 模型回退,OpenRouter
- 提供商路由,OpenRouter
- Auto Exacto,OpenRouter
- 提示缓存,OpenRouter
- 工具调用,OpenRouter
- Agent SDK以及停止条件,OpenRouter
- 子智能体服务器工具,OpenRouter
- LangChain 集成,OpenRouter
- LangGraph 概览,持久化,以及中断,LangChain
- ChatOpenRouter以及内置中间件,LangChain
- 简介,流程,过程,智能体,以及LLM,CrewAI