今天我们推出 Extract v2.5,这是我们新一代基于 schema 的文档提取智能体。此次发布提升了所有档位的准确率,并为我们最高档位 Agentic 和 Agentic Plus 增强了 grounding 能力。这些改进并未提高每页价格,确保无论你使用哪个档位,都能获得更高的性价比。
在ExtractBench上,三个档位的准确率均有提升。Cost Effective 现在超越了此前的 Agentic 档位,整体 value F1 从 87.1 升至 93.9,而 Agentic 超越了此前的 Agentic Plus,从 89.8 提升至 95.8。我们准确率最高的档位 Agentic Plus 从 95.1 升至 96.4。
在底层,我们做了架构上的增强,促成了这些性能提升,其中包括一个全新的智能体 harness,专为文档提取打造。我们从最新的编程智能体中汲取灵感,围绕模型对一切进行了超精细调优,以应对文档提取中真实的失败模式,涵盖视觉、推理和验证。最终成果是一个专门的智能体,能够交叉引用多页的上下文,并将数值 grounding 到确切的来源。
第一项变更是结构化推理。我们使用结构化推理 作用于文档表示,以基于文档类型、布局和信息密度实现更高效、更量身定制的提取。Extract 会自适应地推理,并为更复杂的文档投入更多精力,以交付最高准确率。对于不太复杂的文档,它会以更低的延迟处理,并精准投放其精力。
此次发布为 Agentic 和 Agentic Plus 引入了高级引用,帮助定位提取数值的支持性证据。ExtractBench 的 grounding 分数对 Agentic 从 46.8 升至 80.6,对 Agentic Plus 从 46.4 升至 82.2,这意味着即便面对你最复杂的布局和提取任务,也能获得更准确、更贴合的边界框。
这些改进体现在 ExtractBench 的各项挑战中,包括长列表、跨页记录和扫描表单。以下展示了一些示例,说明提取和 grounding 在这些任务上如何改进。
长列表
长列表可能导致即使是最前沿的 VLM 也提前停止或丢失对重复记录的追踪。Extract v2.5 使用中间表示来处理完整数据集,并根据你的 schema 验证其输出。在长列表任务中,Cost Effective 的得分从 82.0 上升到 92.6,Agentic 的从 86.1 上升到 95.5。
在一份 17 页的基金备案文件中,Cost Effective 之前只返回了 238 项持仓中的 87 项。Extract v2.5 返回了全部 238 项,该文档的提取得分从 52.8 上升到 98.7。
238 238 项持仓中的 每一行是一项持仓
-
 p1 12
-
 p2 15
-
 p3 15
-
 p4 14
-
 p5 15
-
 p6 16
-
 p7 14
-
 p8 15
-
 p9 15
-
 p10 15
-
 p11 15
-
 p12 15
-
 p13 14
-
 p14 15
-
 p15 15
-
 p16 14
-
 p17 4
holdings: [
…{ issuer_name: "CENTENE CORPORATION", value_usd: 203604.00 }, 87项持仓
{ issuer_name: "Aktiebolaget Volvo", value_usd: 552328.91 },{ issuer_name: "AVNET, INC.", value_usd: 361862.00 },… 151项遗漏
238项持仓
]
跨页记录
在真实世界文档中,提取必须跨页推理。某一页上的内容可能跨越多个页面,或者与许多页之后的附录相连。Extract v2.5 在构建输出时更擅长保留字段之间的关系。
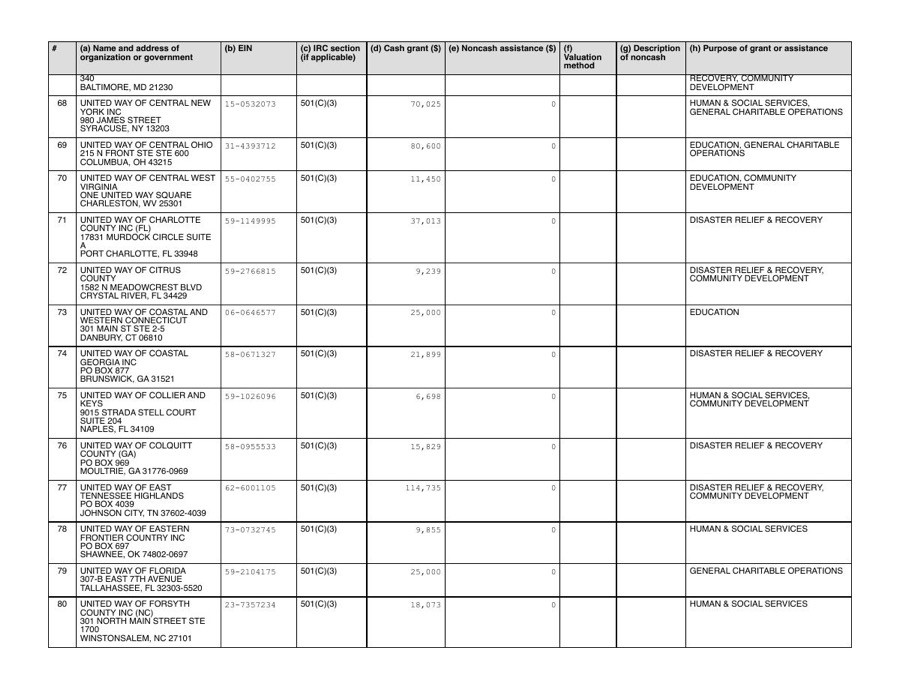
在这份拨款计划中,Agentic v2.0 在分页处停止,导致拨款的用途和地址不完整。Extract v2.5 将下一页的续接内容包含在同一条记录中。


- address_line1
- 1800 WASHINGTON BLVD STE340
- city, state, zip_code
- "" BALTIMORE MD 21230
- purpose_of_grant
- EDUCATION, HUMAN & SOCIAL SERVICES, DISASTER RELIEF &RECOVERY, COMMUNITY DEVELOPMENT
 第 5 页
 第 6 页
扫描表单
扫描表单通常混合了印刷字段、叠加文本、手写内容和审核者批注。此类表单中常见的扫描噪声会使这些层更难区分。印刷的值可能在打印后被划掉并手工更正。Extract v2.5 更擅长在上下文中对字段进行视觉解读,并将所需的值与周围的标记区分开。它现在也更能将提取的值回溯定位到源文档,以便交叉核对和参考。
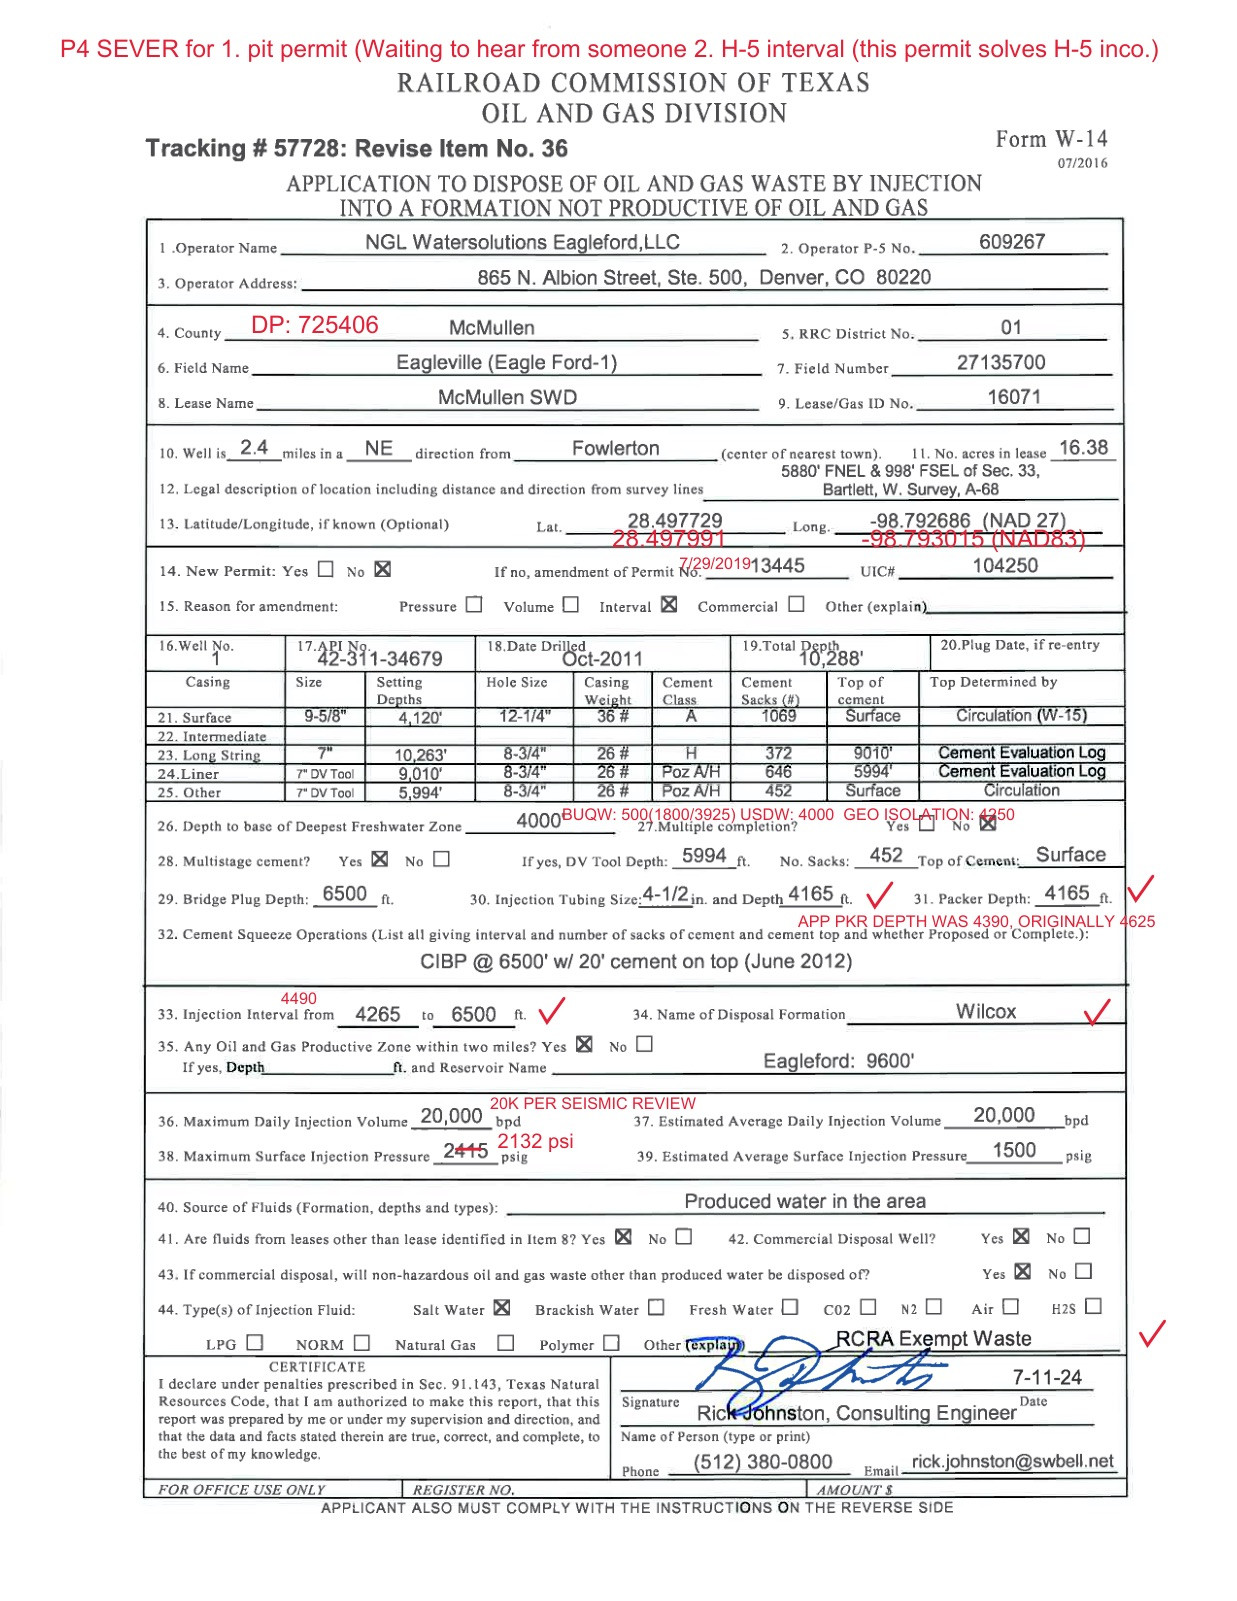
在这份带注释的许可证上,Agentic 之前将审查员的日期与许可证编号合并,并把审查员备注附加到淡水深度上。Extract v2.5 将原始值与注释分离,放入 schema 所要求的字段中。

- amendment_permit_no
- "7/29/2019 13445" "13445"
- amendment_permit_no_review
- null "7/29/2019"

- deepest_freshwater_zone
- "4000 BUQW: 500(1800/3925) USDW: 4000 GEO ISOLATION: 4250" "4000"
- deepest_freshwater_zone_review
- "4000 BUQW: 500(1800/3925) USDW: 4000 GEO ISOLATION: 4250" "BUQW: 500(1800/3925) USDW: 4000 GEO ISOLATION: 4250"
Advanced Citations
Advanced Citations 会定位困难字段的支持证据的边界框,包括那些并未逐字出现在文档中的值。此前已在 Agentic Plus 中提供初始版本。在 v2.5 中,我们进一步提升了其定位准确度,并将其扩展到 Agentic。
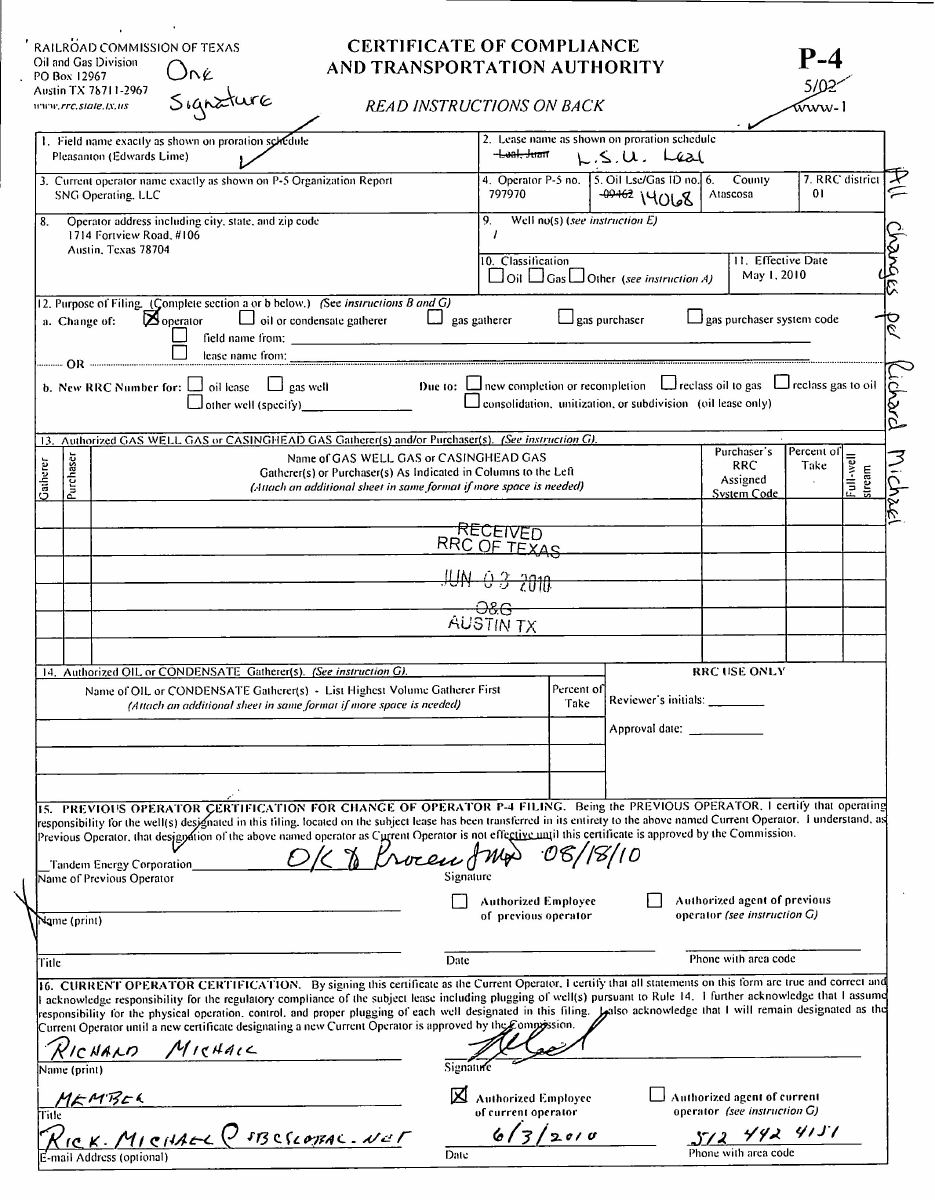 field_namePleasanton (Edwards Lime) lease_nameL.S.U. Leal current_operator_nameSNG Operating, LLC operator_p5_no797970 oil_lse_gas_id_no14068 countyAtascosa operator_address1714 Fortview Road, #106 Austin, Texas 78704 well_nos1 classification_oilfalse classification_gasfalse classification_otherfalse effective_dateMay 1, 2010 change_operatortrue change_oil_condensate_gathererfalse change_gas_gathererfalse change_gas_purchaserfalse change_gas_purchaser_system_codefalse change_field_namefalse change_lease_namefalse new_rrc_oil_leasefalse new_rrc_gas_wellfalse new_rrc_other_wellfalse due_new_completion_recompletionfalse due_reclass_gas_to_oilfalse due_reclass_oil_to_gasfalse due_consolidationfalse
边界框引用与置信度分数结合得很好。置信度分数帮助团队判断哪些值可以自动处理,哪些需要进一步检查。审查员随后可以在 human-in-the-loop 工作流中使用引用,对照原始文档核对这些值。我们的置信度分数指南解释了如何在你自己的文档上评估这一点。
我们如何构建 v2.5
在 LlamaIndex,我们深知文档。我们已将这一专长融入我们的提取智能体可以调用的工具中,用于读取、转换和定位文档中的信息。这些工具依托专门构建的模型和文档处理方法,来处理不一致的文件格式、模糊的布局和源坐标。
阅读顺序、表格结构,以及文本与其在页面上位置之间的关系,都会影响提取。我们的工具为智能体提供了处理这些结构并在构建输出时回溯到源文档的方式。
在 v2.5 中,我们将 Agentic Plus 背后的框架引入了 Cost Effective 和 Agentic,使其工具和提取策略适配每个层级的成本约束。我们优化了如何组织任务、给智能体提供什么上下文,以及何时应更仔细地检查文档。
把这些选择做对需要大量测试。一种对短表单有效的方案,可能在面对数百条重复记录时举步维艰。我们在这些任务上评估了文档表示、工具和模型配置,在准确率提升与其所需的时间和处理开销之间进行权衡。
我们还研究了智能体如何遵循你的 schema 和提取指令,包括多达 3,200 个字段的任务。例如,如果记录 ID 对于将提取的记录与你的数据库匹配至关重要,请在提示中明确指出,以便智能体对其给予额外关注。
我们还新增了原生电子表格提取。在电子表格模式下,智能体直接处理工作簿单元格,而非扁平化表示,为它们提供了另一种处理结构化数据的方式。你可以在提取配置中启用它。
在你的文档上试用 v2.5
用代表你工作流程的文档、使用你现有的 schema 来试用 v2.5。我们认为这个版本将在提取质量上实现显著提升,尤其是对于那些此前需要手动清理或不够可靠而无法自动化的文档。我们期待看到你构建的成果。